Материал: ЛиФП. Лабораторная работа 4
Федеральное агентство связи ФЕДЕРАЛЬНОЕ ГОСУДАРСТВЕННОЕ БЮДЖЕТНОЕ
ОБРАЗОВАТЕЛЬНОЕ УЧРЕЖДЕНИЕ ВЫСШЕГО ОБРАЗОВАНИЯ «САНКТ-ПЕТЕРБУРГСКИЙ ГОСУДАРСТВЕННЫЙ УНИВЕРСИТЕТ ТЕЛЕКОММУНИКАЦИЙ ИМ. ПРОФ. М. А. БОНЧ-БРУЕВИЧА» (СПбГУТ)
Факультет инфокоммуникационных сетей и систем Кафедра программной инженерии и вычислительной техники
ЛАБОРАТОРНАЯ РАБОТА №4 по дисциплине «Логическое и функциональное программирование»
Выполнил: студент 3-го курса дневного отделения группы ИКПИ-85
Коваленко Леонид Александрович Преподаватель:
доцент кафедры ПИиВТ Ерофеев Сергей Анатольевич
Санкт-Петербург
2020
Постановка задачи
Написать программу на языке Turbo Prolog 2.0 для подсчета числа операций последовательного, бинарного и интерполяционного поисков.
Схема решения Последовательный (линейный) поиск — простейший вид поиска,
который предполагает последовательный просмотр всех элементов.
•Не требует упорядоченности данных.
•Сложность последовательного поиска в худшем случае: O(n) .
Очевидно, что на списке можно организовать только один единственный вид поиска — последовательный (линейный) поиск, пример реализации которого приведен в табл. 1.
Таблица 1 — Последовательный поиск в списке (SWI-Prolog)
/*
Последовательный (линейный) поиск в списке.
Пример: linear_search([1, 2, 3, 4], 3, I) Результат: I = 2
*/
% linear_search(List, Element, [Return] Index) linear_search(L, E, RI) :- linear_search(L, E, 1, RI).
% linear_search(List, Element, CurrentIndex, [Return] Index) linear_search([], _, _, -1) :- !.
linear_search(_, _, CI, -1) :- CI < 0, !. linear_search([X|_], X, CI, CI) :- !.
linear_search([_|Tail], X, CI, RI) :- CI1 is CI + 1, linear_search(Tail, X, CI1, RI)
В Prolog можно создавать разные структуры данных. Приведем реализацию последовательного поиска при помощи узловой структуры данных (табл. 2, рис. 1).
Таблица 2 — Последовательный поиск при помощи узловой структуры данных (SWI-Prolog)
/*
Последовательный (линейный) поиск при помощи узловой структуры данных. Пример: linear_construct([1, 2, 3, 4], S), linear_search(S, 3, I)
Результат: S = node(1, 0, node(2, 1, node(3, 2, node(4, 3, nil)))), I = 2 Особый домен: node(Element, Index, NextNode)
*/
% linear_construct(List, [Return] Structure) linear_construct(List, S) :- linear_construct(List, S, 1). linear_construct([], nil, _) :- !. linear_construct([Head|Tail], S, I) :-
S = node(Head, I, Next), I1 is I + 1, linear_construct(Tail, Next, I1).
% linear_search(Structure, Element, [Return] Index) linear_search(nil, _, -1) :- !. linear_search(node(E, I, _), E, I) :- !.
linear_search(node(_, _, Next), E, I) :- linear_search(Next, E, I).
2

Рисунок 1 — Списочная узловая структура Суть этой реализации в том, что создается узловая структура (предикат
linear_construct) для последующего поиска в ней (предикат linear_search). Очевидно, что эта реализация ничем не лучше последовательного
поиска в списке.
Бинарный поиск — алгоритм поиска элемента в отсортированном массиве (векторе), использующий дробление массива на половины.
•Требует упорядоченности данных.
•Сложность бинарного поиска в худшем случае: O(log n) .
Приведем реализацию бинарного поиска при помощи узловой структуры данных (табл. 3).
Таблица 3 — Бинарный поиск при помощи узловой структуры (SWI-Prolog)
/*
Бинарный поиск.
Пример: binary_construct([1, 2, 3, 4], S), binary_search(S, 3, I)
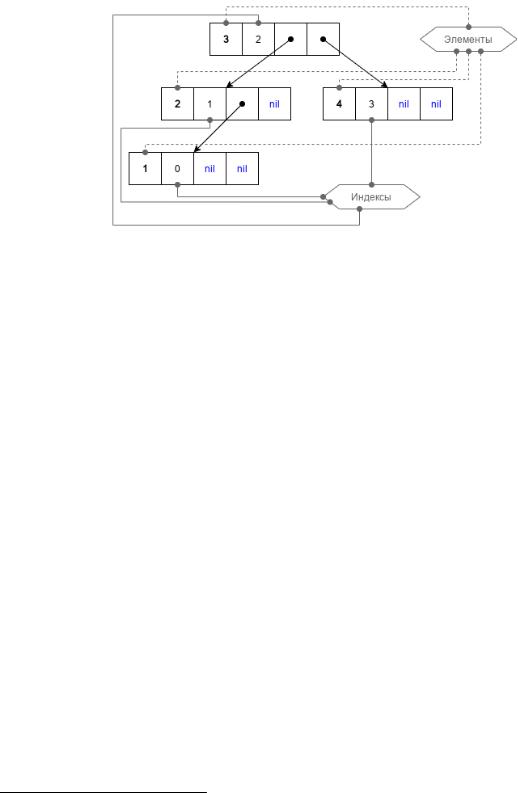
Результат: S = node(t(3, 2), node(t(2, 1), node(t(1, 0), nil, nil), nil), node(t(4, 3), nil, nil)), I = 2
Особые домены: t(Element, Index), node(t(Element, Index), PrevNode, NextNode)
*/
%binary_construct(List, [Return] Structure) binary_construct(List, S) :-
pair_list(List, PairList), quicksort(PairList, SortedPairList), balance_tree(SortedPairList, BalancedList), binary_construct(BalancedList, nil, S), !.
%pair_list(List, [Return] PairList)
pair_list(List, PairList) :- pair_list(List, PairList, 1). pair_list([], [], _) :- !.
pair_list([Head|Tail1], [t(Head, I)|Tail2], I) :-
I1 is I + 1, pair_list(Tail1, Tail2, I1).
%quicksort(List, [Return] SortedList) quicksort([], []).
quicksort([X|Xs], Zs) :- partition(Xs, X, Left, Right), quicksort(Left, Ls), quicksort(Right, Rs), merge(Ls, [X|Rs], Zs).
%quicksort(List, Element, [Return] List[:{Element}], [Return] List[{Element}:]) partition([], _, [], []).
partition([t(X, XI)|Xs], t(Z, ZI), Ls, [t(X, XI)|Rs]) :-
X > Z,
partition(Xs, t(Z, ZI), Ls, Rs).
partition([t(X, XI)|Xs], t(Z, ZI), [t(X, XI)|Ls], Rs) :- X =< Z,
partition(Xs, t(Z, ZI), Ls, Rs).
3

%merge(List1, List2, [Return] List1 + List2) merge([H|Xs], Zs, [H|Ts]) :- merge(Xs, Zs, Ts), !. merge([], Zs, Zs) :- !.
%balance_tree(List, [Return] BalancedList) balance_tree([], []) :- !. balance_tree(List, [H|T]) :-
length(List, Length), Length2 is Length div 2, get(List, Length2, H),
split(List, Length2, U1, [_|U2]), balance_tree(U1, T1), balance_tree(U2, T2),
merge(T1, T2, T), !.
%get(List, Index, [Return] Element)
get([Head|_], |
0, |
X) :- X = Head. |
get([_|Tail], |
I, |
X) :- I1 is I - 1, get(Tail, I1, X). |
get([], _, _) |
:- |
fail. |
% split(List, |
Index, [Return] List[:Index], [Return] List[Index:]) |
|
split([], _, [], |
[]) :- !. |
|
split([H|T1], |
0, |
Left, [H|T2]) :- |
split(T1, |
0, |
Left, T2), !. |
split([H|T1], |
N, |
[H|T2], Right) :- |
N1 is N - |
1, |
|
split(T1, |
N1, T2, Right), !. |
|
%binary_construct(List, ProcStructure, [Return] Structure) binary_construct([], S, S) :- !. binary_construct([Head|Tail], S, RS) :-
binary_construct_aux(Head, S, MS), binary_construct(Tail, MS, RS), !.
%binary_construct_aux(Element, Node1, [Return] Node2) binary_construct_aux(X, nil, node(X, nil, nil)) :- !. binary_construct_aux(t(X, XI), node(ET1, P1, N1), node(ET2, P2, N2)) :-
ET1=t(E1, _), X < E1, binary_construct_aux(t(X, XI), P1, U), (ET2, P2, N2)=(ET1, U, N1), !; ET1=t(E1, _), X > E1, binary_construct_aux(t(X, XI), N1, U), (ET2, P2, N2)=(ET1, P1, U), !; (ET2, P2, N2) = (ET1, P1, N1), !.
%binary_search(Structure, Element, [Return] Index)
binary_search(nil, _, -1) :- !. binary_search(node(t(E, I), _, _), E, I) :- !.
binary_search(node(t(V, _), Prev, _), E, I) :- V > E, binary_search(Prev, E, I), !. binary_search(node(t(V, _), _, Next), E, I) :- V < E, binary_search(Next, E, I), !.
Порядок работы:
1. Каждому элементу сопоставляется его исходный индекс в списке.
Например, для [1, 2, 3, 4] получим [t(1, 0), t(2, 1), t(3, 2), t(4, 3)].
2.Полученный на предыдущем этапе список сортируется. (В примере выше результат первого этапа совпадает с результатом второго.)
3.Полученный на предыдущем этапе список простым образом «балансируется» для последующего построения дерева1.
4.На основе «сбалансированного списка» строится бинарное дерево. Структура данных в результате этого этапа готова для поиска.
5.Производится поиск элементов предикатом binary_search. Балансировка происходит следующим образом:
1.Выбирается серединный элемент списка.
1 Балансировка дерева более трудоемка, поэтому вместо неё «балансируются» элементы списка, на основе которого затем создается дерево.
4
2.Список делится на две части по выбранному элементу списка;
3.Серединный элемент списка становится первым элементом сбалансированного.
4.Далее каждый подсписок обрабатывается рекурсивно, добавляя серединные элементы подсписков в результативный — сбалансированный список.
Рисунок 2 — Бинарная (двоичная) узловая структура Очевидно, что данная реализация гораздо лучше последовательного
поиска в списке по скорости нахождения нужного элемента, однако она требует предварительной обработки и дополнительной памяти.
Интерполяционный поиск — алгоритм предсказания местонахождения элемента: поиск происходит подобно двоичному поиску, но вместо деления области поиска на две части, интерполирующий поиск производит оценку новой области поиска по расстоянию между ключом и текущим значением элемента следующим образом:
|
M=left + |
(key− A [left])(right−left) |
|
|
A[right ]− A [left ] |
||
|
|
||
|
где M — индекс элемента, с которым сравнивается значение ключа, |
||
key |
— ключ (искомый элемент), |
A — массив упорядоченных элементов, |
|
left |
и right — номера крайних элементов области поиска. Важно отметить, |
||
что операция деления в формуле строго целочисленная, т. е. дробная часть, какая бы она ни была, отбрасывается.
•Требует упорядоченности данных.
•Сложность интерполяционного поиска в среднем случае2: O(log log n) .
2Средний случай — равномерное распределение элементов.
5