Курсовая работа (т): Фильтрация речевых сигналов в условиях воздействия акустических шумов
На рис. 2.1 представлена схема адаптивного компенсатора
помех, который использует один опорный сигнал.
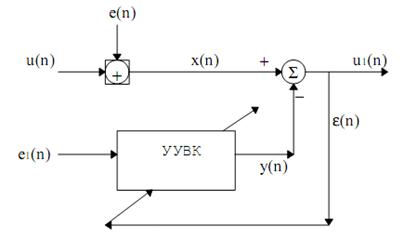
Рис. 2.1. Схема адаптивного компенсатора помех
Здесь  - дискретный отсчет полезного сигнала в
момент времени
 ;
 - шумовой сигнал;
 - опорный сигнал;
 - сигнал ошибки;
 - выходной сигнал компенсатора; УУВК - устройство управления
весовыми коэффициентами.
Наиболее важной частью адаптивного компенсатора помех является
устройство управления весовыми коэффициентами - линейный фильтр, через который
пропускается опорный сигнал . Задача адаптивной компенсации помехи сводится к подбору коэффициентов фильтра
таким образом, чтобы минимизировать энергию сигнала на выходе компенсатора . В этом случае будет максимизировано
выходное отношение сигнал/шум. Минимизация энергии обычно осуществляется на
основе градиентных методов поиска экстремума функций многих переменных.
Известно, что адаптивные компенсаторы помех позволяют значительно улучшить качество зашумленных сигналов - на несколько десятков децибел, но требование наличия опорного сигнала существенно сужает их область применения. Во многих приложениях цифровой обработки речевых сигналов (например, при реставрации архивных записей или в криминалистике), опорного сигнала, по крайней мере, в явном виде, не имеется. Поэтому для применения методов адаптивной компенсации помех опорный сигнал в таких случаях приходится получать на основе косвенных соображений, связанных с особенностями речевого сигнала, а сам адаптивный компенсатор в этом случае будет являться одной из составных частей более сложного алгоритма выделения речевого сигнала.
Методы, основанные на использовании статистических моделей речевых сигналов во временной области
Класс методов цифровой обработки зашумленных речевых сигналов, который основан на построении математических моделей речевых сигналов и обработке речевых сигналов с использованием этих моделей быстро развивается и в настоящее время эти методы приводят к самым успешным результатам. Задача выделения речевого сигнала из смеси с шумом в случае использования достаточно адекватной модели сводится к оценке каким-либо образом параметров этой модели и последующим синтезом или фильтрации речевого сигнала фильтром, построенным на основе или с помощью оцененных параметров.
Одними из наиболее перспективных методов в этом классе являются методы статистической фильтрации во временной области. Фильтрация речевого сигнала, моделируемого авторегрессией, осуществляется при этом методами теории оптимального оценивания, например, с помощью построения оптимального линейного фильтра (фильтра Калмана).
Вычислительно эффективная (но с менее удачным результатом обработки) реализация алгоритма фильтрации речевого сигнала, моделируемого авторегрессионной моделью с параметрами, связанными в марковскую цепь. Совместная оценка сигнала и параметров марковской цепи вычисляются рекуррентным способом с помощью алгоритма максимизации математического ожидания (expectation maximization - EM), причем для вычисления условного ожидания (expectation step) сигнала относительно наблюдений использован фильтр Калмана-Бьюси.
Экспериментальные испытания на речевом сигнале в смеси с некоррелированным аддитивным белом шумом с отношениями сигнал/шум 0, 10 и 20 дБ показали увеличение отношения сигнал/шум в среднем на 4 дБ.
Авторегрессионная модель речевого сигнала, как показывает
практика, не имеет такого выраженного дефекта как музыкальные тона, однако,
артефакты обработки также имеют место. В целом фильтрация высокоэнергетических
частотных диапазонов звуков выполняется точнее, в то время как моделирование
нулей и минимумов спектра затруднено. Этот эффект непосредственно связан с
порядком  используемой модели авторегрессии.
Высокие (предварительные) результаты продемонстрировал комбинированный метод анализа и фильтрации речевого сигнала, основанный на частотной декомпозиции сигнала c последующим раздельным моделированием сигнала в каждой частотной полосе моделью авторегрессии.
Речевой сигнал декомпозируется в несколько частотных полос, в
каждой из которых оценивается отношение сигнал/шум, на основании которого
выбирается порядок модели сигнала в этой частотной полосе. В
общем случае правило выбора величины таково, что сигнал в частотном диапазоне с высоким отношением
сигнал/шум (как правило, это соответствует формантным максимумам речевого
сигнала) моделируется авторегрессией большего порядка, а сигнал для частотных
полос с низким отношением сигнал/шум (нули спектра сигнала) моделируется
авторегрессией более низкого порядка.
Собственно фильтрация осуществляется модифицированным фильтром Винера в частотной области. Предварительные измерения (смесь речи с белым шумом) показали значительное увеличение отношения сигнал/шум: на +15 дБ при начальном отношении −5 дБ (соответственно, при начальном ОСШ +5 дБ улучшение составило 11 дБ).
Методы, основанные на обработке речевого сигнала с использованием аппарата скрытых марковских моделей
Другим классом методов обработки зашумленных речевых сигналов основанных на использовании статистических моделей речевого сигнала являются методы, в которых речевой сигнал моделируется скрытой Марковской цепью. То есть для моделирования речевого сигнала использован наиболее эффективный для распознавания речи подход.
Известно, что традиционно используемые методы фильтрации (вычитание спектров или фильтр Винера) не используют фонетическую информацию, переносимую речевым сигналом. Недавние исследования показали, что знание и применение в процессе обработки фонетической структуры сигнала приводит к улучшению качества фильтрации. Поэтому вполне естественным является применение в процессе очистки речевого сигнала от шумов его статистической модели в виде скрытой марковской цепи, которая связана с фонетической структурой сигнала.
Идея реализации такого подхода заключается в том, что первоначально, по записям не зашумленного речевого сигнала строятся статистические модели единиц речевого потока (фонов либо более широких классов звуков). После того, как статистическая модель для множества состояний сигнала построена, по ней можно рассчитать оптимальный фильтр Винера.
При обработке зашумленного речевого сигнала сначала оценивается (по отфильтрованному на предыдущем шаге сигналу) текущее состояние марковской модели, в соответствии с которым выбирается оптимальный фильтр, который затем используется для фильтрации сигнала и получения очередной оценки.
Алгоритм фильтрации выглядит следующим образом:
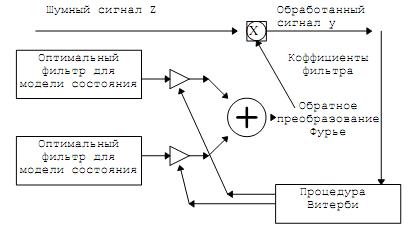
Рис. 2.2. Алгоритм фильтрации речевого сигнала с использованием
скрытой марковской модели
Для эффективной обработки нестационарных сегментов отдельно оценивалась Марковская модель шума. В отличие от простых моделей состояний полезного сигнала шум моделировался набором состояний, каждое из которых содержало несколько гауссовских компонент.
Во время обработки зашумленного сигнала при определении отсутствия полезного сигнала выполнялось декодирование сегмента паузы процедурой Витерби для выбора оптимальной модели шума. Модель шума, обеспечивающая максимальное правдоподобие наблюдаемой последовательности использовалась далее для обработки сигнала.
Для сохранения «преемственности» между итерациями применялись инерционная схема фильтра Винера.
В реальных экспериментах по фильтрации речевого сигнала описанными методами число состояний марковской модели речевого сигнала выбиралось равным 5, то есть фактически речевой сигнал моделировался как последовательность фонов, соответствующих широким фонетическим категориям (звонкий - шумный - глухой и т.п.).
Сравнительные исследования выполнялись на различных типах шумов (белый, симуляция шума вертолете, одновременный разговор нескольких мешающих дикторов). Объективные измерения (изменение отношения сигнал/шум на входе и выходе системы) показали очевидное превосходство описанной методики (в среднем улучшение +2.5 дБ, в диапазоне от 0 до +20 дБ, причем при отношении сигнал/шум > 10 дБ, превосходство составило в среднем +7 дБ) над стандартной системой фильтрации, построенной по методу вычитания амплитудных спектров. Субъективные тесты (оценка качества звучания обработанного сигнала на слух по пятибалльной шкале) также показали превосходство марковских моделей над стандартными методиками. По мнению авторов, разборчивость речи в результате обработки также повысилась, вероятно вследствие того, что низкоэнергетические звуки в данном случае обрабатываются существенно аккуратнее.
Последовательное развитие этого подхода привело к использованию алгоритма минимизации среднеквадратической ошибки вместо процедуры Витерби с улучшенными возможностями.
Следует отметить, что очевидным недостатком подхода является необходимость иметь априорную информацию о возможных типах шумов (в виде предварительно обученных марковских моделей состояний). Типов возможных шумов для различных практически важных условий много и требование наличия заранее вычисленных моделей представляется мало выполнимым.
Кроме того, известно, что качество обработки сигнала ухудшается в тех случаях, когда помеха имеет существенно нестационарный характер.
В связи с этим дальнейший прогресс в этом направлении может быть, достигнут за счет использования более гибких способов моделирования помех. В работе предлагается эффективный алгоритм для переоценки параметров вероятностной модели шума, основанный на адаптивной подстройке элементов кодовой книги (которая состоит из матрицы корреляционных коэффициентов для авторегрессионной скрытой марковской модели) по методу скользящего среднего. Показано, что подобная методика приводит к дополнительному выигрышу примерно 2.3 дБ (по сравнению с исходным алгоритмом фильтрации, основанным на марковской модели) на нестационарных шумах и не ухудшает качества обработки для стационарных помех.
Использование марковских моделей речевого сигнала оказывается выигрышным при наличии априорной информации синтаксического характера о зашумленном речевом сигнале. Довольно часто (например, при анализе черных ящиков с борта самолета или реставрации аудиозаписей) время обработки сигнала не играет определяющей роли.
В тех случаях, когда аудитор может приблизительно указать (дать гипотезы), что именно было произнесено, или на что похоже зашумленное высказывание, можно улучшить качество сигнала с помощью использования аппарата марковских моделей, построенных для предстазанных звуков.
Анализ метода фильтрации речевых сигналов с помощью марковских моделей при наличии гипотез о произносимом тексте выполнен в работе. Было продемонстрировало улучшение, в результате обработки, качества звучания сигнала в условиях различных типов помех и в широком диапазоне отношений сигнал/шум.
Методы, основанные на использовании, отдельных характерных свойств речевого сигнала
К методам этого типа относятся, прежде всего, класс методов
обработки зашумленных речевых сигналов, которые используют квазипериодичность
речевого сигнала. Первая группа методов использует периодичность речевых
сигналов для построения адаптивного компенсатора помех, с помощью которого
обрабатывается зашумленный речевой сигнал. Предполагается, что исходный речевой
сигнал  строго периодичен с периодом
 , кратным частоте дискретизации, а
случайный аддитивный шум
 некоррелирован с . В качестве опорного сигнала для
адаптивной компенсации помехи используется:
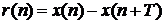 , где
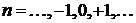 .
Вторая группа методов, использующих периодичность звонких звуков основана на представлении сигнала в кепстральной области. В этом случае периодический характер речевого сигнала используется для синтеза адаптивной гребенки фильтров.
Периодичность звонких звуков выражается в частотной области в том, что их спектр имеет линейчатый характер, причем соседние пики (спектральные максимумы) отстоят друг от друга на интервал (в частотной области) равный частоте основного тона. Поэтому, если гребенка фильтров такова, что гармоники основного тона (спектральные пики) попадают в полосы пропускания, то можно рассчитывать на повышение качества речевого сигнала.
Исследования, проведенные на синтетических гласных звуках показали, что при надлежащем выборе взвешивающих коэффициентов можно добиться значительного эффекта для улучшения восприятия речи в тех случаях, когда помеха или шум являются структурированными.
Обобщение метода является также известный адаптивный фильтр Фрезиера. В этом случае учитывается изменение частоты основного тона на интервале времени, равном длине импульсной характеристики гребенки фильтров. Исследование характеристик такого фильтра показали, что он может дать выигрыш в отношении сигнал/шум до 10 дБ, однако при этом несколько снижается разборчивость речи.
Описанные методы имеют существенные недостатки. Помимо того, что все методики, кроме фильтра Фрезиера, не учитывают изменений частоты основного тона, эти методы непригодны для фильтрации глухих звуков. Например, существенные для разборчивости речевого сигнала звуки «п», «т», «к» не могут быть успешно обработаны такими методами. Наконец, качество обработки сигнала зависит от точности оценки частоты основного тона в зашумленном речевом сигнале, что само по себе не всегда возможно.
То обстоятельство, что на разборчивость речи существенно влияет правильное восприятие согласных звуков, в частности, взрывных «п», «т», «к» и шумного «с», было использовано в системе. Фильтрация речевого сигнала заключалась в том, что перед взрывными звуками вставлялась короткая пауза, - смычка, а согласный «с» фильтровался специально подобранным фильтром.
Методы, основанные на оценке спектральных характеристик шума
Наиболее часто используемыми методами, основанными на использовании спектральных характеристик шума, являются методы, реализующие различные модификации алгоритма вычитания амплитудных спектров.
В качестве обоснования этих методов приводятся следующие
соображения. Если стационарный сигнал  ,
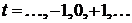 со спектральной плотностью мощности
 искажен аддитивным стационарным шумом
 со спектральной плотностью мощности
 , который предполагается некоррелированным
с
 , то спектральная плотность мощности
зашумленного сигнала равна
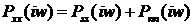 , следовательно спектральная плотность мощности полезного сигнала может быть оценена как:
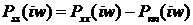 .