Материал: Оптимизация и моделирование в автоматизированных системах. труд. ФГБОУ В.О., Воронежский г.т.и
Vector Machine, SVM), классификация К-ближайших соседей (k-nearest neighbors algorithm, k-NN), наивный байесовский классификатор, деревья классификации, нейронные сети и метод максимальной энтропии. В связи с этими подходами был широко использован мультиномиальный наивный байесовский текстовый классификатор, благодаря своей простоте в обучении и классификации этапов. Многие исследователи доказали его эффективность при классификации неструктурированных текстовых документов в различных областях.
Врамках существующих исследований классификации текстовых данных были представлены общие стратегии автоматической классификации текста, которая включает такие фазы, как предварительная обработка, выбор функций, использование семантических или статистических методик, а также выбор соответствующих машинных методик обучения (Naive Bayes, дерево принятия решений, гибридные методики и другие). Также множество исследований было направленно на изучение особенностей подбора и использования алгоритмов на основе лингвистических особенностей различных языков.
Вданной статье рассматривается обзор некоторых основных техник по классификации текстовых данных. В процессе обработки текстовых данных различной структуры, большинство текстов и документов содержат много слов, которые являются избыточными для классификации текста, таких как стопслова, орфографические ошибки, сленговые выражения и т.д. Перед тем как рассмотреть основные техники и методы классификации, рассмотрим методы предварительной обработки тестовых данных [4]. Во многих алгоритмах, таких как статистические и вероятностные методы обучения, шум и ненужные особенности могут негативно влиять на погрешность результата классификации. Поэтому устранение этих особенностей крайне важно.
Рассмотрим основные техники предварительной обработки текстовых данных. Токенизация — это процесс разбиения потока текста на слова, фразы, символы или любые другие значимые элементы, называемые токенами. Основной целью этого шага является извлечение отдельных слов из предложения [3]. Наряду с классификацией текста, в процессе извлечения текста и его конвейерную обработку необходимо включать процесс токенизации.
Фрагменты текстовых данных могут содержать смесь заглавных и строчных букв. Несколько предложений составляют текстовый документ. Чтобы уменьшить проблемное пространство, наиболее распространенный подход заключается в сокращении всего до нижнего регистра. Это приводит к тому, что все слова в документе занимают одно и то же место, но часто меняет значение некоторых слов. Для решения этой проблемы можно применять преобразователи сленга и аббревиатур. Еще одной проблемой очистки текста на этапе предварительной обработки является удаление шума. Текстовые документы, как правило, содержат такие символы, как знаки препинания или специальные символы, и они не нужны для целей интеллектуального анализа
150
или классификации текста. Хотя пунктуация важна для понимания смысла предложения, она может отрицательно повлиять на алгоритмы классификации.
Самый важный шаг в процессе классификации текста — это выбор лучшего классификатора. В настоящее время алгоритмы текстовой классификации можно в основном классифицировать следующим образом: методы извлечения признаков, такие как Term Frequency-Inverse document frequency (TF-IDF), Termency frequency (TF), word-embed (например, Word2Vec,
контекстуальные представления слов, Global Vector for Word Representation (GloVe) и FastText), широко используются как в академических, так и в коммерческих приложениях [2]. Без полного концептуального понимания каждого алгоритма мы не сможем эффективно определить наиболее эффективную модель для применения текстовой классификации.
Непараметрические методы были изучены и использованы в качестве классификационных задач, таких как классификация К-ближайших соседей (k- NN). Этот метод используется в обработке естественного языка (NLP) как метод классификации текста во многих исследованиях последних десятилетий.
Среди различных методов машинного обучения, используемых для классификации текста, наивный байесовский классификатор всегда был наиболее популярным в течение многих лет. Благодаря своей простоте, а также быстроте и эффективности в решении задачи классификации. Байесовский классификатор принадлежат к семейству простых вероятностных классификаторов, основанных на предположении, что значение одного признака всегда отличается от других значений признака. На этом фоне классификаторы текстовых документов, основанные на технике наивного байесовского классификатора, были тщательно изучены многими исследователями. В классификаторах данного типа документы представлены в виде двоичного вектора признаков в зависимости от того, присутствует или отсутствует каждое слово.
Классификация методом опорных векторов - еще одна популярная методика, использующая дискриминирующий классификатор для классификации документов. Эта техника также, может быть, использована для различных типов данных, таких как изображения, видео, классификация человеческой деятельности и т.д. Эта модель также используется в качестве базы для многих исследователей для сравнения с их собственными работами, чтобы подчеркнуть новизну и вклад. Преимущества данного алгоритма заключаются в универсальности и эффективности в больших векторных пространствах. К недостаткам можно отнести то, что данный метод не даёт прямых оценок вероятности, они вычисляются с помощью дорогостоящей пятикратной перекрёстной проверки.
Одним из ранних алгоритмов классификации для поиска текста и данных является дерево решений. Классификаторы дерева решений (DTC) успешно используются во многих различных областях классификации [4]. Структура этой методики включает в себя иерархическое разложение пространства
151
данных. Дерево решений в качестве классификационной задачи было введено Д. Морганом. Основной идеей является создание деревьев на основе атрибутов точек данных, но задача заключается в определении того, какой атрибут должен быть на родительском уровне, а какой - на дочернем. Для решения этой задачи было введено статистическое моделирование для выделения признаков в дереве.
Задача классификации текстовых данных является важной задачей в системах машинного обучения и в системах поддержки принятия решений. По мере роста массивов текстовых данных разработка и исследование алгоритмов классификации становится всё более востребованным. Наличие более совершенной системы классификации текстовых данных требует правильного выбора методов и алгоритмов решения данной задачи, существующие алгоритмы классификации работают более эффективно, если мы лучше понимаем методы извлечения функций и способы их правильной оценки. В данной работе были рассмотрены некоторые из этих методов, а также методы предварительной обработки данных.
Литература
1.Feldman R., Sanger J. The Text Mining Handbok. Cambridge: Cambridge University Press, 2007. Christopher D. Manning, Prabhakar Raghavan, Hinrich Sch√Љtze. Introduction to Information Retrieval. Cambridge University Press, 2008, 544 p.
2.Turney, P. D. The latent relation mapping engine: Algorithm and experiments. // Journal of Artificial Intelligence Research, 33, 2008, P. 615-655.
3.Kumar, A., Kumar, D., Jarial, S. K. A novel hybrid K-means and artificial bee colony algorithm approach for data clustering. // Decision Science Letters . - 2018, Vol. 7, Issue 1, P. 65-76.
4.Abualigah, L. M., Khader, A. T., Al-Betar, M. A., Alomari, O. A. Text feature selection with a robust weight scheme and dynamic dimension reduction to text document clustering. / Expert Systems with Applications. - 2017, 84, P. 24-36.
5.Kanimozhi, K. V., Venkatesan, M. A novel map-reduce based augmented clustering algorithm for big text datasets. // Advances in Intelligent Systems and Computing. - 2018, Vol. 542, P. 427-436.
6.Jenhani, F., Gouider, M. S., Said, L. B. Social stream clustering to improve events extraction. // Smart Innovation, Systems and Technologies. - 2018, Vol. 73, P. 319-329.
7.Li, W., Joo, J., Qi, H., Zhu, S.-C. Joint Image-Text News Topic Detection and Tracking by Multimodal Topic And-Or Graph. // IEEE Transactions on Multimedia. - 2017, Vol. 19, Issue 2, 19(2), P. 367-381.
8.Bafna, P., Pramod, D., Vaidya, A. Document clustering: TF-IDF approach. // International Conference on Electrical, Electronics, and Optimization Techniques, ICEEOT 2016. - 2016, P. 61-66.
152
9. Lamari, Y., Slaoui, S. C. Parallel document clustering using iterative mapreduce. 2016 International Conference on Big Data and Advanced Wireless Technologies, BDAW 2016; Blagoevgrad; Bulgaria; 10 November 2016 to 11 November 2016. // ACM International Conference Proceeding Series.
Воронежский государственный технический университет
УДК 681.3
Э. Р. Саргсян
ВОЗМОЖНОСТИ ОПТИМИЗАЦИИ RAN СЕТЕЙ С ПОМОЩЬЮ СЕТЕЙ НОВОГО ПОКОЛЕНИЯ
Современные телекоммуникационные сети требуют постоянного улучшения для того, чтобы соответствовать всем требования нынешних потребителей. На данный момент любая мировая отрасль так или иначе зависит от телекоммуникационных сетей передачи данных, так как это позволяет автоматизировать любые процессы в любой отрасли, будь то производство чего-либо, продажи, торговля, социальные услуги и так далее. Для поддержки любой сферы используются устройства, которые имеют выход в интернет. А возможно это благодаря телекоммуникационным сетям.
На данный момент одним из наиболее использующихся типов сетей является Radio Access Network (RAN). Сеть радиодоступа доступна в различных стандартах сотовой связи. Основной задачей является установка соединения между абонентским оборудованием. RAN сеть представляет из себя набор элементов, который позволяет клиентам получать доступ в сеть. То есть сеть обслуживает телефонные звонки, выход в интернет, отправку сообщений и всю другую информацию, которую можно передать или получить по сети.
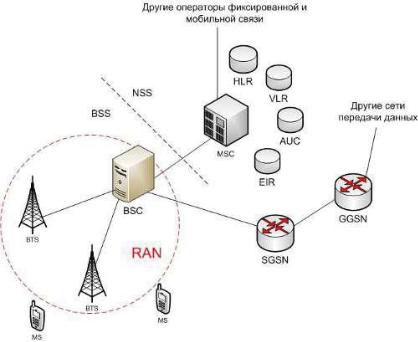
Сама структура RAN сети на верхнем уровне представляет собой набор базовых станций, которые состоят из оборудования, позволяющего получать, обрабатывать и передавать сигнал. Базовая станция состоит из следующих элементов:
корпус базовой станции;
компоненты питания базовой станции;
устройства для обработки данных;
антенны для обеспечения покрытия сети.
Однако помимо аппаратной составляющей, каждая RAN сеть также имеет большую зависимость от программного обеспечения. Так, например, любая RAN сеть имеет свой набор интерфейсов для обеспечения общения между оборудованием абонента и сетью. Соответственно, от этих интерфейсов зависят следующие параметры сети:
153
качество соединения;
количество обслуживаемых абонентов;
максимальная скорость передачи данных в сети;
максимальный размер данных для передачи в сети.
Рис. 1. Структура RAN сети
Большинство сетей, которые сейчас развёрнуты по всеми миру, базируются на технологии 4G, которая является основным способом передачи данных на данный момент. Однако на данный момент уже начинает интегрироваться технология 5G, которая имеет заметные преимущество в сравнении с 4G технологией. Основным изменением является то, что 5G работает в другом диапазоне радиочастот, что позволяет использовать ресурсы, которые недоступны для 4G. Для сравнения, 4G работает на частотах ниже 6 ГГц, а 5G может использоваться частоты от 30 ГГц до 300 ГГц. Повышение уровня частотности имеет множество преимуществ, одно из наиболее важных – это способно обеспечить высокую емкость и большую скорость передачи в сети.
Переход на 5G позволит оптимизировать расход энергии и улучшить регулировку направленности передачи сигнала. Вышки 4G излучают сигнал сразу во всех направлениях, что расходует слишком много энергии и зачастую эта энергия расходуется в местах, где это не требуется. В свою очередь 5G использует короткие волны и благодаря этому можно уменьшить размер используемых антенн, что позволит использовать на одной базовой станции большее количество антенн. В свою очередь это увеличит количество одновременно подключенных устройств к одной базовой станции.
154