Материал: Методические указания к выполнению лабораторных работ по дисциплине «Архитектура информационных систем». Горбунов В.Г
В качестве иллюстрации на рисунке 15 показана общая картина архитектуры информации.
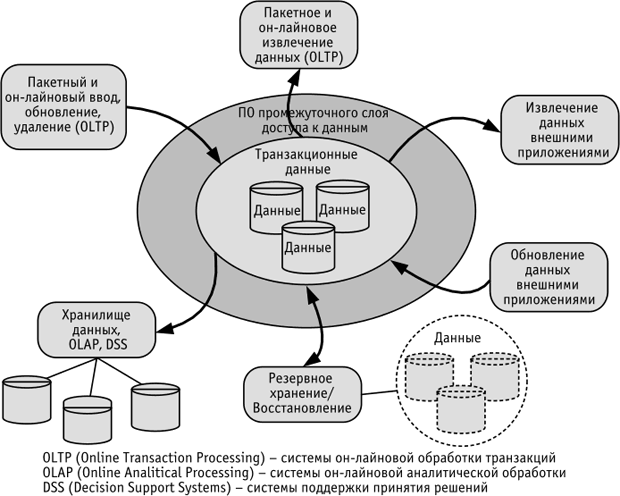
Рисунок 15.
Реализация архитектуры информации обеспечивает единый в масштабах всего предприятия доступ к определениям элементов данных, своевременный доступ к корректным данным и соответствующий уровень безопасности и защиты для всех данных. Это является основой для реализации систем поддержки принятия решений, систем обработки транзакций и аналитических систем.
Для понимания архитектуры информации и того, как данные хранятся и обновляются, важно отличать типы прикладных систем, которые обеспечивают доступ к данным. Два наиболее важных типа таких систем – это системы онлайновой обработки транзакций (OLTP – Online Transaction Processing) и системы он-лайновой аналитической обработки (OLAP – Online Analitical Processing). Третий тип – системы управления неструктурированными данными (контентом). OLTP-системы применяются для выполнения критически важных, повседневных операций. Чаще всего они используются многими пользователями одновременно для ввода, обновления и извлечения данных. OLTP-системы способны выполнять атомарные бизнес-функции и четко обозначенные единицы работ – как правило, в форме одной или нескольких транзакций, выполняемых как одно целое (например, транзакция "изменение адреса клиента").
OLAP-системы используются для анализа, планирования и управления получением отчетов путем обеспечения интерактивного доступа к широкому спектру информации. В OLAP-системах обычно обрабатываются агрегированные данные для получения ответа на такие вопросы: "Сколько было потрачено на покупку офисной техники в прошлом году?", "Каков был объем продаж изделия X в городе N в первом квартале?" Данные для OLAP-систем, как правило, извлекаются из транзакционных OLTP-систем и помещаются, или реплицируются в специальные базы данных – хранилища или витрины данных. Витрины данных являются специализированными хранилищами, которые ориентированы на предоставление информации, требующейся для бизнес-анализа на предприятии.
Таким образом, мы можем сказать, что архитектура информации включает в себя, в частности, такие области (а также связанные с ними стандарты, руководства и пр.), как:
федеративные данные (метаданные);
моделирование данных;
системы управления базами данных;
программное обеспечение промежуточного слоя (middleware) для доступа к данным;
механизмы доступа к данным;
безопасность данных.
Однако окончательный набор дисциплин, связанных с архитектурой информации, определяется, в конечном итоге, потребностями предприятия.
Безусловно, область архитектуры информации имеет пересечения с остальными доменами архитектуры предприятия. Типичным примером такого пересечения является стандарт XML, который имеет отношение одновременно как к архитектуре информации, так и к архитектуре приложений. Другим примером являются системы управления базами данных, которые относятся и к архитектуре информации, и к технологической архитектуре (инфраструктуре). Реализация сложных систем, таких, например, как хранилища и витрины данных, требует участия специалистов по архитектуре информации, прикладным системам и инфраструктуре.
Рекомендуемыми первыми шагами на пути создания архитектуры информации являются следующие шаги:
создание словаря данных и репозитория метаданных;
выбор системы записи информации о каждом элементе данных.
Эти шаги впоследствии будут способствовать созданию оперативного хранилища данных (ODS – Operational Data Store), которое обеспечивает стандартные процессы извлечения, трансформации и загрузки данных (ETL – Extract, Transform, Load), а также очистки данных и создания метаданных. Оперативное хранилище является краеугольным камнем для повторного, многократного использования данных, а в последующем – для создания хранилищ и витрин данных.
После того как решены эти первые задачи, необходимо обеспечить такие условия, чтобы все процессы создания и доступа к информации на предприятии соответствовали разработанной архитектуре.
1.2. Модели и инструменты описания архитектуры информации
Результатами процесса разработки архитектуры информации являются:
документированное описание существующих источников данных;
модели данных;
описание существующих и планируемых информационных потоков, соответствующих интерфейсов, алгоритмов преобразования или консолидации данных, а также необходимые соглашения по уровню сервиса, связанного с передачей данных;
описание решений по организации хранения данных – от общих каталогов до витрин и хранилищ данных;
используемые технологии и средства для преобразования и управления данными.
Целью разработки моделей информации и моделей данных является создание графических представлений потребностей организации и отдельных бизнес-процессов в информации. Это становится основой для реорганизации бизнес-процессов и конструирования новых прикладных систем, описания взаимодействий и информационного обмена, который происходит между организацией и клиентами, партнерами.
Для архитектурного процесса модели информации рассматриваются на различных уровнях абстракции. Так, на уровне контекста модели информации включают список бизнес-сущностей – объектов, важных для бизнеса («клиент», «счет»), связи между сущностями (бизнес-объектами).
На концептуальном уровне модели информации состоят из семантических моделей, моделей связи и моделей «сущность-связь». Здесь модели описывают информационные потоки между функциональными подразделениями организации в самом общем виде. Эти потоки не связаны с какой-то отдельной прикладной системой и не уточняют методы доступа или физического хранения информации, т.е. рассматриваются на бизнес-уровне без описания проблем практической реализации. В качестве примера для иллюстрации концептуальной динамической модели возьмем он-лайновую систему выполнения заказов некоторого гипотетического магазина. Динамическая модель для этого уровня должна отражать взаимодействия между клиентом и магазином. При этом сама проектируемая система выступает как один из акторов процесса в качестве "черного ящика". Клиент и сотрудник(и) магазина выступают как внешние по отношению к системе акторы. Весь процесс рассматривается с точки зрения клиента и сотрудника. Клиент осуществляет заказ через Интернет. Оплата выполняется с помощью кредитной карты. Заказ посылается по указанному адресу. Уведомление о выполнении заказа посылается по электронной почте. Модель на самом высоком уровне описывает бизнес-процессы продавца и содержит простой сценарий использования (use case), описывающий взаимодействия между системой и акторами. Рисунок 16 иллюстрирует такую концептуальную динамическую модель и содержит простую нотацию сценария использования для этого бизнес-взаимодействия.
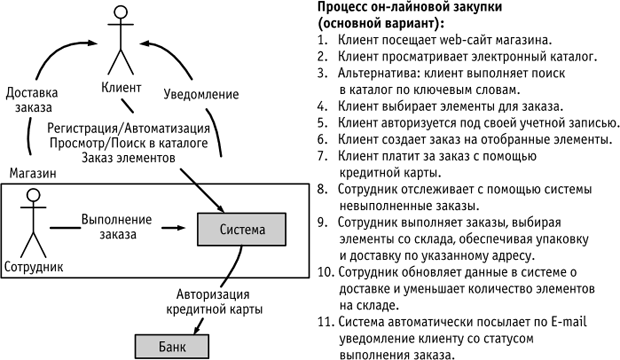
Рисунок 16.
На уровне логического описания модели информации и данных описывают требования к информации в форме и терминах, понятных бизнес-пользователям. Процесс моделирования на логическом уровне обеспечивает средства обнаружения, анализа, определения, стандартизации и нормализации отношений между бизнес-процессами и прикладными системами, идентификацию потоков информации и соответствующих элементов данных, которые требуются организации. Процессы, информационные потоки и элементы данных являются логическими фактами, которые организация должна поддерживать для выполнения бизнес-операций. Этот уровень анализа уже позволяет идентифицировать общие элементы данных, которые используются разными организационными единицами и разными бизнес-процессами, что позволяет уменьшить пересечения и конфликты между этими элементами. Однако он не зависит от способа хранения информации в базе данных.
При этом модель используется для сбора и анализа требований к данным и включает в себя такие элементы, как сущности, атрибуты, отношения и количество вхождений.
Сущностями являются такие объекты, как "клиент", "гражданин", "заказ", "место", "вещь или объект" и т.д. Совокупность сущностей одного типа становится таблицей в базе данных, а строка этой таблицы – это одна реализация некоторой сущности.
Атрибут является характеристикой, которая обеспечивает более детальную информацию о сущности (объекте), например, "фамилия", "имя", "пол" и т.д. Атрибут становится колонкой в таблице базы данных. Ключевой атрибут, или первичный ключ, является уникальным идентификатором сущности. Примером является серийный номер.
Отношения показывают, как одна сущность соотносится с другой. При описании связи представлены глаголами, поскольку означают действие. Примером может быть высказывание "гражданин владеет недвижимостью": сущность "гражданин" "владеет" некоторой другой сущностью "недвижимость". Когда между сущностями установлены связи, то одна сущность является "родителем", а другая "потомком".
Количество вхождений показывает, какое количество сущностей может состоять в отношениях с другой сущностью. Например, гражданин может владеть несколькими объектами недвижимости.
Одним из способов моделирования данных на логическом уровне является построение моделей "Сущности-Отношения" (ERM – Entity-Relationship Model).
На физическом уровне даются точные ответы на вопросы типа: "Какие данные требуются для того, чтобы реализовать логику бизнес-процесса соответствующей прикладной системой?", "Сколько требуется различных информационных объектов (сущностей)?", "Каков набор элементов данных каждой сущности?". Физическая модель данных служит, по сути, представлением того, как данные, приведенные в логической модели, будут храниться в системе управления базами данных. На этом уровне модель данных включает схемы БД, код доступа к данным, справочники данных.
При разработке данной архитектуры необходимо помнить об использовании в организации как структурированной, так и неструктурированной информации. Многие исследования показывают, что люди, принимающие решения, только на одну треть полагаются на информацию из структурированных источников (документы и отчеты, генерируемые компьютерными системами). Две трети источников по значимости в плане принятия решений – это информация, получаемая в результате встреч, телефонных разговоров, участия в конференциях и пр. Это должны помнить и учитывать специалисты, отвечающие за разработку архитектуры информации.
Еще одним важным понятием, относящимся к архитектуре информации ), является управление федеративными данными и метаданными (federated data management). Под управлением федеративными данными понимается архитектура, которая обеспечивает управление и доступ к данным и метаданным независимо от их внутренней логической структуры и физических границ их расположения, в целях организации взаимодействия систем и различных подразделений внутри организации и с внешними организациями.
Рисунок 17 показывает общее видение принципов управления федеративными данными.
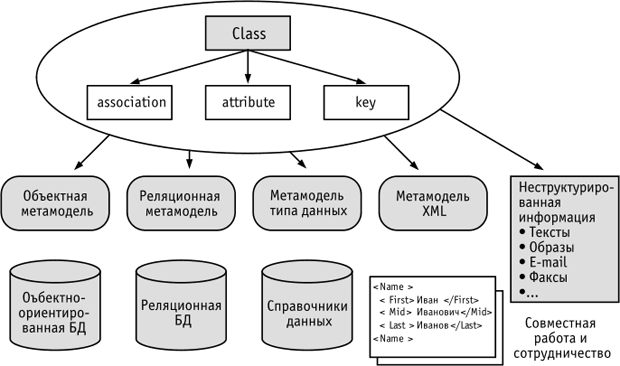
Рисунок 17.
Идея заключается в использовании общей метамодели, которая позволяет управлять отношениями между различными "оригинальными" (native) моделями данных и таким образом делать их прозрачными на корпоративном уровне.
Любая попытка интегрировать данные и информацию между различными системами в конечном итоге основывается на обнаружении и использовании метаданных этой системы (метаданные – это данные о данных системы). Получение информации о метаданных – это только половина проблемы. Вторая, гораздо более важная половина проблемы связана с определением отношений между метаданными одной системы с аналогичными метаданными другой.
Суть федеративных данных состоит в одинаковом определении на некотором новом уровне абстракции общих элементов данных для различных информационных систем предприятия. При этом данные (например, о клиенте или гражданине) могут быть описаны различным образом в каждой системе, таблице базы данных, в которых они встречаются. Определения включают такие атрибуты, как имена полей, длину, формат чисел, формат дат, диапазон значений и т.д. Однако при этом имеются объединяющие их общие виртуальные модели. Если это достигнуто, то гораздо проще реализовать обмен данными между системами.
Рисунок 18 иллюстрирует принципы интеграции информации на основе управления федеративными данными.
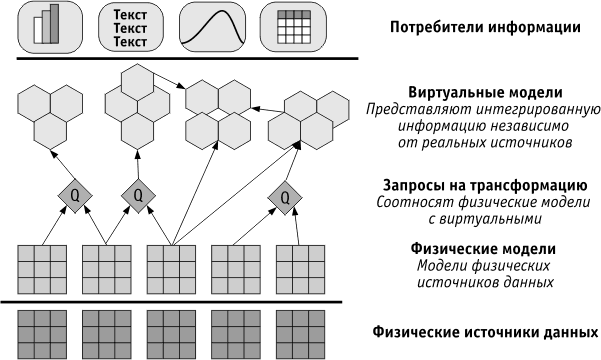
Рисунок 18.
В нижней части рисунка мы имеем набор различных физических систем управления данными. Уровень выше представляет набор моделей этих систем, независимых от платформы реализации. Уровень запросов выполняет трансформацию и устанавливает соответствие для создания виртуальных моделей объектов, чьи физические аналоги могут и не существовать в физических системах. Эти виртуальные модели для различных пользователей могут представляться по-разному – например, базами данных, бизнес-объектами, представлениями (выборки из базы), моделями данных предприятия, документами, сервисами или компонентами в зависимости от потребностей. Важно то, что определения этих объектов создаются с помощью моделей. В связи с этим серьезную роль может играть стандарт Meta Object Facuility (MOF), который и помогает определять все необходимые модели для метаданных.
Частью процесса описания архитектуры является сбор информации, которая определяет объекты в виде "как есть", определение целевого состояния, а также плана перехода из текущего состояния в целевое. Это верно и для Архитектуры информации, и для моделей информации. Как правило, текущее состояние архитектуры информации описывается с использованием логических и физических моделей данных, многие из которых могут отсутствовать в репозитории метаданных предприятия. Эти модели обычно являются платформенно-зависимыми. Целевое состояние, как правило, описывается в форме платформенно-независимых семантических или виртуальных моделей. Для перехода от текущего состояния в желаемое будущее потребуется установление отображения (mapping) и трансформации между платформенно-зависимыми моделями и виртуальными моделями. Со временем, когда понадобится создание новой прикладной системы, может потребоваться отображение виртуальной модели на новую, специфическую для выбранной платформы реализации модель.