Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
3 КОДИРОВАНИЕ ДЛЯ ОБНАРУЖЕНИЯ ОШИБОК
В системах радиосвязи цифровой сигнал перед подачей его на модулятор подвергают обработке в кодере канала, который является общим, как для сигнала канала трафика, поступающего от кодера речи, так и для сигналов логических каналов, поступающих из логического блока (рисунок 1.5). В самом общем случае в кодере канала осуществляется перемежение входных символов, скремблирование, шифрование и введение корректирующего кода (Forward Error Correction – FEC) рисунок 3.1.
|
|
|
|
|
Ключ |
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
От |
|
шифрования |
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|||
логического |
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|||
блока |
|
|
|
|
|
|
|
К |
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
модулятору |
|
От кодера |
Перемежитель |
|
Скремблер |
FEC |
|
|
||||
|
|
|
||||||||
речи |
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
Рисунок 3.1 Функциональная схема кодера канала
В процессе передачи по каналу связи происходит искажение сигнала, а так же на него накладываются шумы и помехи. В результате на выходе канала связи в сигнале появляются ошибки, частота появления которых зависит от скорости передачи данных и отношения сигнал/шум в канале. Ошибки будут всегда, независимо от конструкции системы передачи, так что в переданном кадре один или несколько битов обязательно изменят свое значение.
Существуют три наиболее распространенных способа борьбы с ошибками в процессе передачи данных:
 коды для обнаружения ошибок;
 коды для коррекции ошибок, называемые также схемами прямого исправления ошибок (Forward Error Correction — FEC);
Код обнаружения ошибок позволяет довольно легко установить наличие ошибки. Как правило, подобные коды используются совместно с определенными протоколами канального или транспортного уровня имеющими схему ARQ. В схеме ARQ приемник попросту отклоняет блок данных, в котором была обнаружена ошибка, после чего передатчик передает этот блок повторно. Коды прямого исправления ошибок позволяют не только обнаружить ошибки, но и исправить их, не прибегая к повторной передаче. Схемы FEC часто используются
86
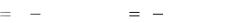
в беспроводной передаче, где повторная передача крайне неэффективна, а уровень ошибок довольно высок.
Далее будем считать, что данные передаются как одна или несколько непрерывных последовательностей битов, которые называют кадрами или блоками. Определим вероятности, связанные с возникновением ошибок в переданных кадрах:
Pb – вероятность появления единичного ошибочного бита, именуемая также частотой появления ошибочных битов (bit error rate — BER);
P1- вероятность безошибочного приема кадра;
Р2 — вероятность того, что используемый алгоритм выявления ошибок позволяет обнаружить ошибку в кадре;
Р3 — вероятность того, что используемый алгоритм выявления ошибок позволяет обнаружить все ошибки в кадре;
Рассмотрим для начала пример, когда при передаче данных схемы выявления ошибок не используются. В этом случае вероятность обнаружения всех ошибок Р3 равна нулю. Чтобы найти значения остальных вероятностей, предположим, что каждый бит может быть ошибочным с равной вероятностью, т.е. Pb – постоянная независимая величина для каждого бита. Тогда можно записать
P |
(1 P )F , |
P |
1 P, |
1 |
b |
2 |
1 |
где F – число битов в кадре. Иными словами, вероятность получения кадра без ошибок уменьшается с ростом вероятности битовой ошибки. Кроме того, вероятность отсутствия ошибок в полученном кадре уменьшается с увеличением длины кадра – чем длиннее кадр, тем больше в нем битов и тем больше вероятность ошибочности одного из них.
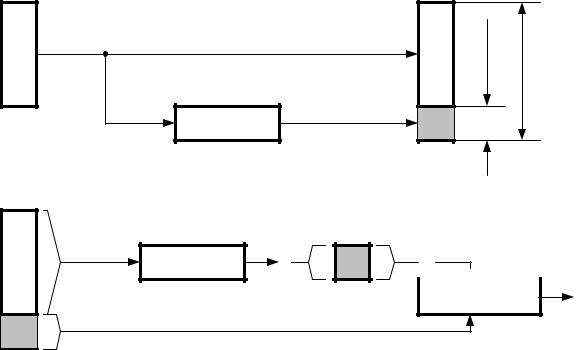
Из этого следует необходимость применения схем обнаружения ошибок. Работа всех методов обнаружения ошибок основывается на следующем принципе: к информационному кадру на передающей стороне добавляется последовательность битов, которые составляют код обнаружения ошибок (рис. 3.2).
Этот код вычисляется как функция переданных битов. Обычно для информационного блока из k бит алгоритм обнаружения ошибок дает код, имеющий n-k бит, причем (n-k)<k. Код обнаружения ошибок (иногда называемый контрольными битами) присоединяется к блоку данных, в результате чего получается последовательность из п бит, которая и передается. Приемник разделяет полученную последовательность на k бит данных и (п - k) бит кода обнаружения ошибок. Основываясь на k битах данных, приемная сторона вычисляет код, после чего сверяет результат с принятым кодом обнаружения (п - k) бит кода обнаружения ошибок. После чего сверяет полученный код с принятым кодом обнаружения ошибок.
87
Данные k бит |
(n-k) бит |
n бит |
|
Кодер |
|
|
а) |
|
Данные
Кодер
б)
 Ошибки Сравнение
Рисунок 3.2 Процесс обнаружения ошибок: а) формирование кода обнаружения ошибок; б) использование кода на приемной стороне
Если два кода не совпадают, в канале произошла ошибка. Следовательно, параметр P3 – это вероятность того, что в кадре присутствует ошибка и она обнаружена с помощью используемой схемы. Параметр Р2 называют остаточным уровнем ошибок. Р2 – это вероятность того, что ошибка не будет обнаружена, несмотря на использование схемы выявления ошибок.
3.1 Проверка четности
Наиболее простой метод обнаружения ошибок – добавление бита четности в конец каждого блока данных.
Коды с контролем четности (parity-check code) для обнаружения или исправления ошибок используют линейные суммы информационных битов,
которые называются символами (parity symbols), или битами четности (parity bits). Код с одним контрольным битом — это прибавление к блоку информационных битов одного контрольного бита. Этот бит (бит четности) может быть равен нулю или единице, причем его значение выбирается так, чтобы сумма всех битов в кодовом слове была четной или нечетной. В операции суммирования пользуется арифметика по модулю 2 (операция исключающего ИЛИ), описанная в данном параграфе ниже.
Если бит четности выбран так, что результат четный, то говорят, что схема имеет положительную четность (even parity); если при добавлении бита четности результирующий блок данных является нечетным, то говорят, что он имеет отрицательную четность (odd parity). На рис. 3.3, а показана
88
последовательная передача данных (первым является крайний справа бит). К каждому блоку добавляется один бит четности (крайний слева бит в каждом блоке), дающий положительную четность.
Бит четности
001010 |
|
|
100111 |
|
111010 |
|
|
|
|
|
|
|
|
|
|
|
|
|
а) |
|
|
||
110101 |
111111 |
|
|
||||
100001 |
101110 |
|
|
||||
011000 |
011000 |
|
|
||||
000011 |
011110 |
|
|
||||
110011 |
010001 |
Горизонтальный |
|||||
111100 |
000110 |
||||||
контроль четности |
|||||||
|
|
|
|
|
|||
Вертикальный контроль четности
б)
Рисунок 3.3 Проверка четности для последовательной а) и парпллельной б) структуры кода
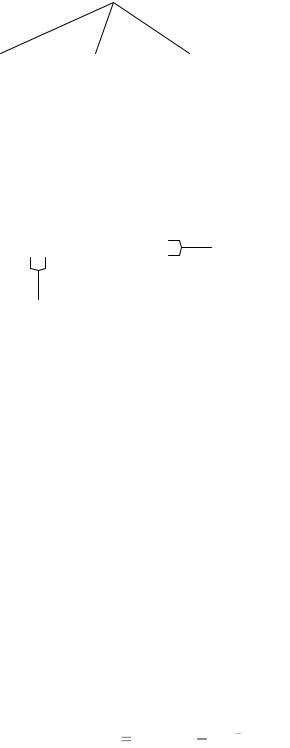
В приемном оконечном устройстве производится декодирование, заключающееся и проверке, дают ли нуль суммы принятых битов кодового слова по модулю 2 (положительная четность). Если полученный результат равен 1, то кодовое слово заведомо содержит ошибки. Скорость кодирования такого кода можно записать как k/(k + 1). С помощью такого кода можно только обнаружить, что в кодовом слове присутствует нечетное количество ошибок. (Если ошибка была внесена в четное число битов, то проверка четности покажет отсутствие ошибок; данный случай – это пример необнаруженной ошибки). Предполагая, что ошибки во всех разрядах равновероятны и появляются независимо, можно записать вероятность появления j ошибок в блоке, состоящем из п символов
P( j,n) |
n |
p j (1 p)n j . |
(3.1) |
|
j |
|
|
Здесь р — вероятность получения канального символа с ошибкой, а через
89
n |
n! |
(3.2) |
j j!(n j)!
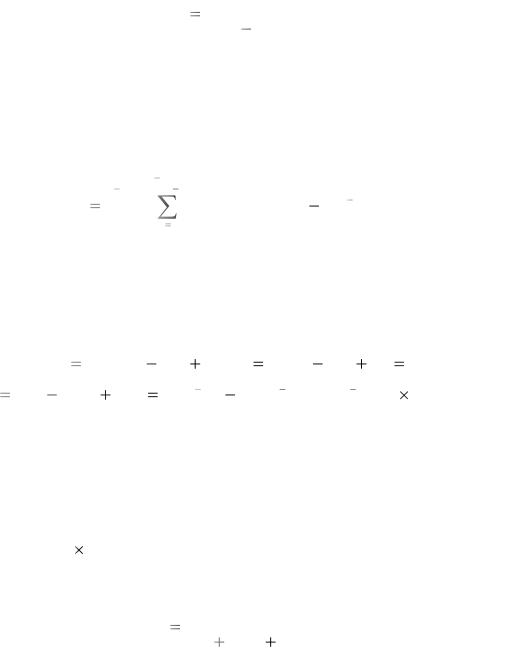
обозначается число различных способов выбора из п бит j ошибочных. Таким образом, для кода с одним битом честности вероятность необнаруженной ошибки Pnd в блоке из п бит вычисляется следующим образом
n / 2(при n четном)
(n 1) / 2(при n нечетном)
Pnd
j 1
n |
p2 j (1 p)n 2 j . |
(3.3) |
2 j |
|
|
Например, для кода (n,k) = (4,3) положительной четности вероятность необнаруженной ошибки равна вероятности появления где-либо в кодовом слове из четырех символов двух или четырех ошибок
P |
|
4 |
p2 (1 p)2 4 |
p4 6 p2 (1 p)2 p4 |
nd |
2 |
4 |
(3.4) |
|
|
|
|
||
6 p2 |
12 p3 |
7 p4 6(10 3 )2 |
12(10 3 )3 +7(10 3 )4 =6 10-6. |
|
Прямоугольный код (rectangular code), называемый также композиционным
(product code), можно представить в виде параллельной структуры кода, изображенной на рис. 3.3, б. Код создается следующим образом. Вначале из битов сообщения строятся прямоугольники, состоящие из М строк и N столбцов; затем к каждой строке и каждому столбцу прибавляется бит четности, что в результате дает матрицу размером (М+ 1) (N+ 1). Скорость кодирования прямоугольного кода, k/n, может быть записана следующим образом
k |
|
MN |
(3.5) |
|
|
|
|
. |
|
n |
(M 1)(N 1) |
|||
Насколько прямоугольный код мощнее кода, который имеет один контрольный бит и предоставляет только возможность обнаружить ошибку? Отметим, что любая отдельная ошибка в разряде приведет к нарушению четности в одном столбце и в одной из строк матрицы. Следовательно, прямоугольный код может исправить любую единичную ошибку, поскольку расположение такой ошибки однозначно определяется пресечением строки и столбца, в которых была нарушена четность. В примере, показанном на рис. 3.3, б, размеры матрицы равны М = N = 5; следовательно, на рисунке изображен код (36,25), способный исправлять единичные ошибки, расположенные в любом из 36 двоичных разрядов. Вычислим для такого блочного кода с коррекцией ошибок вероятность появления неисправленной ошибки, для чего учтем все возможные варианты появления ошибки сообщения. Исходя из вероятности наличия j ошибок в блоке из п символов, можно записать вероятность ошибки
90