Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
простирается от голосовой щели (отверстия между голосовыми складками в гортани) до губ. В процессе речеобразования его форма меняется.
Если произносятся звонкие звуки (гласные, носовые, звонкие согласные), голосовые складки в гортани смыкаются и размыкаются с той или иной частотой, которая называется частотой основного тона. Получается последовательность импульсов воздушного потока, которые возбуждают полости голосового тракта.
Таблица 2.4 Типы вокодеров и их производители
Наименование |
Фирма |
Страна |
Скорость |
Цена, $ |
|
производитель |
|
передачи, бит/с |
|
3600 |
AT&T |
США |
4800 |
3500 |
4100 |
AT&T |
США |
1200 |
1800 |
|
|
|
2400 |
|
|
|
|
9600 |
|
SecurePhone |
Cylink |
США |
4800 |
4400 |
|
|
|
9600 |
|
Sectel9600 |
Motorola |
США |
9600 |
8000 |
Omnisec210 |
Omnisec |
Швейцария |
1200 |
18000 |
|
|
|
2400 |
|
Vodacoder9600 |
Нет данных |
Австрия |
2400 |
Нет данных |
CVAS-III |
A-O Electronics |
США |
2400 |
Нет данных |
Telecrypt –VOC |
ANT |
Нет данных |
2400 |
Нет данных |
|
Telecommunication |
|
|
|
1,2/2,4 |
Ин-В |
Россия |
1200 |
Нет данных |
|
|
|
2400 |
|
АТ-240 |
Анкрипт |
Россия |
Нет данных |
4100 |
Орех-4М |
Орех |
Украина |
2400 |
1200 |
|
|
|
4800 |
|
|
|
|
9600 |
|
|
|
|
12000 |
|
VoiceCrypt |
Финтроник |
Украина |
48000 |
800 |
Говоря, человек меняет геометрические размеры этих полостей, соответственно меняются и их резонансные частоты, которые называют формантами. Звонкие звуки называются также вокализованными.
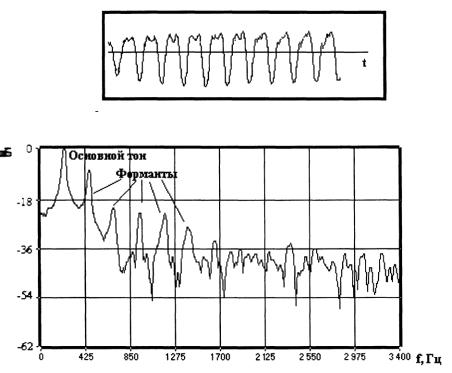
Частота основного тона обычно находится в интервале от 50 до 400 Гц. На рис. 2.22 приведены временная зависимость а и спектр б, соответствующие гласному звуку "и". Хорошо виден периодический характер сигнала; в спектре ярко выражены основной тон и форманты.
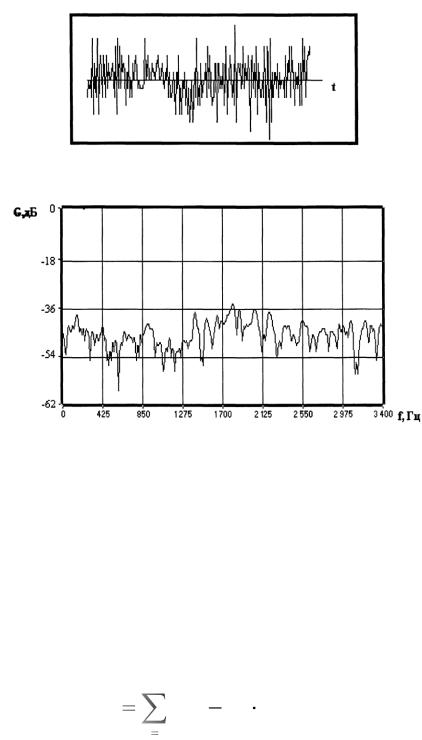
При произнесении глухих (невокализованных) звуков голосовые складки расслаблены. Проходя по суженному голосовому тракту, воздух создает турбулентный поток. Полости рта и носа возбуждаются при этом шумоподобным сигналом. На рис. 2.23 показаны временная зависимость а
76
испектр б, соответствующие глухому согласному звуку "с". Сигнал не содержит периодических составляющих и подобен шуму, в его спектре отсутствуют форманты и основной тон.
Сигнал не содержит взрывные (смычные) звуки получаются путем кратковременного выхлопа -полного перекрытия речевого тракта, нагнетания давления и внезапного открытия тракта. Взрывные звуки бывают звонкие (б, д, г)
иглухие (п, т, к), то есть могут образовываться с участием голосовых складок и без них. Органы речи обладают инерционностью: на интервале 20 - 30 мс параметры речи можно считать постоянными.
а)
б)
Рис. 2.22 Временное а) и спектральное б) представление речевого сигнала, соответствующего гласному звуку «и»
2.3.4 Построение кодера
В современных вокодерах информацию о квазипериодических и шумоподобных составляющих речи передают раздельно в закодированном виде, причем для анализа и фильтрации квазипериодических составляющих используют процедуру линейного предсказания. Поэтому современные вокодеры часто называют кодерами с линейным предсказанием.
Рассмотрим упрощенную структуру вокодера, приведенную на рис. 2.24. На подготовительном этапе выполняют квантование сигнала. При передаче телефонных сообщений, верхняя частота спектра которых FВ = 3.4 кГц, применяют частоту дискретизации FД = 8 кГц. Здесь же выполняют
77
сегментацию сигнала – для последующей обработки выбирают отсчеты сигнала на интервале длительностью 20 – 30 мс. При обычно используемой длительности сегмента 20 мс и FД = 8 кГц число обрабатываемых отсчетов равно 160. На следующем интервале длительностью 20 мс обрабатывают новые 160 отсчетов.
а)
б)
Рис.2.23 Временное а) и спектральное б) представление речевого сигнала, соответствующего согласному глухому звуку «с»
После сегментации 160 отсчетов сигнала повергают процедуре
кратковременного или формантного анализа. Его проводят, как уже отмечалось, с
использованием процедуры линейного предсказания.
При этом оценку текущего отсчета определяют как сумму p предшествующих отсчетов
p |
|
|
sˆ n |
s n k ak , |
(2.27) |
k |
1 |
|
где ak - коэффициенты предсказания. При формантном анализе порядок предсказания р выбирают равным 8 - 12.
78
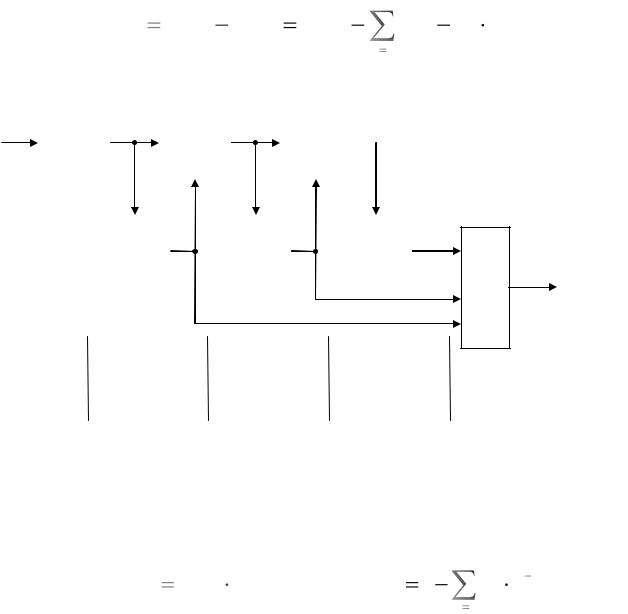
Разность между истинным и предсказанным значением отсчета определяет ошибку предсказания или первый остаточный сигнал:
n |
|
|
r1 n s n sˆ n s n |
s n k ak . |
(2.28) |
k |
1 |
|
S(t) |
Дискретизация |
S(n) |
Фильтр |
r1(n) |
Фильтр |
r2(n) |
|
|
, квантование |
|
удаления |
|
удаления |
|
|
|
и сегментация |
|
формант |
|
осн. тона |
|
|
|
|
|
|
|
|||
|
|
|
A1(z) |
|
A2(z) |
|
|
|
|
|
|
|
|
|
|
|
|
Анализ |
|
Аппроксима |
Формант- |
|
|
ция 2-го |
|
|
основного |
|
||
ный анализ |
|
|
остаточного |
|
|
тона |
|
||
|
|
|
сигнала |
|
|
|
|
|
|
|
|
|
|
|
Этап |
Этап |
Этап |
кратковременного |
долговременного |
аппроксимации |
анализа |
анализа |
2-го остаточного |
|
|
сигнала |
Мультиплексор
Цифровой
сигнал
Рис. 2.24 Структура кодера с линейным предсказанием
В результате z – преобразования этого разностного уравнения имеем
|
|
p |
|
|
|
|
r (z) |
S(z) A (z), где |
A (z) 1 |
a |
z |
k . |
(2.29) |
1 |
1 |
1 |
k |
|
|
|
|
|
k |
1 |
|
|
|
Функция A1(z) является передаточной характеристикой цифрового фильтра, частотная характеристика которого обратна по отношению к частотной характеристике голосового тракта.
Значения коэффициентов предсказания ak являются параметрами этого фильтра. Они остаются постоянными на интервале анализируемого сегмента речи (20 мс). Определение коэффициентов ak производят в блоке формантного анализа (рис. 2.24) из условия минимизации среднеквадратичного значения первого остаточного сигнала на интервале сегмента.
Вычисленные значения коэффициентов предсказания используют в фильтре удаления формант кодера. Кроме того, их вместе с другими параметрами передают по каналу связи в декодер, где используют при синтезе речевого сигнала.
79
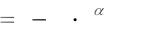
На выходе фильтра удаления формант получают первый остаточный сигнал r1(n) – сигнал свободный от квазипериодических составляющих - формант. Информацию о формантах несут переданные на приемный конец параметры фильтра ak , либо связанные с ними коэффициенты частичной корреляции (коэффициенты отражения). Иногда используют функции от коэффициентов отражения – так называемые логарифмические отношения площадей.
Первый остаточный сигнал все еще содержит квазипериодические составляющие, прежде всего основной тон. Для определения параметров основного тона на этапе долговременного анализа также используют процедуру линейного предсказания. С учетом того, что основной тон характеризуется всего двумя параметрами, – амплитудой и периодом, передаточная функция фильтра удаления основного тона A2(z) описывается более простым выражением
A2 (z) 1 G z , |
(2.30) |
где G - единственный коэффициент предсказания, характеризующий амплитуду основного тона. Задержка α определяет период основного тона, ее значение обычно заключается в пределах от 20 до 160 интервалов дискретизации сигнала, что соответствует диапазону частот основного тона 50 - 400 Гц.
Несмотря на относительную простоту выражения (4.4), анализ и удаление основного тона является более сложной процедурой по сравнению с формантным анализом. Это обусловлено существенно большим периодом основного тона и сложностью выявления корреляции между отсчетами на большом временном интервале. Кроме того, период и амплитуда основного тона очень важны для точного восстановления речи. Именно поэтому на этапе долговременного анализа сегмент речи разделяют на 4 подсегмента. Каждый подсегмент имеет длительность 5 мс и содержит 40 отсчетов. Значения G и α определяют для каждого подсегмента по отдельности.
Найденные параметры G и α используют в фильтре удаления основного тона. Их также передают на приемный конец в декодер, где используют при синтезе речевого сигнала.
На выходе фильтра удаления основного тона получают второй остаточный сигнал r2(n), который свободен от всех квазипериодических составляющих, как формант, так и основного тона. Фактически второй остаточный сигнал является шумоподобным сигналом – между отсчетами отсутствует корреляция.
Задача последующего этапа – аппроксимировать второй остаточный сигнал таким образом, чтобы при минимальном объеме информации о нем обеспечить приемлемое качество восстановленного сигнала. Обработку второго остаточного сигнала производят отдельно для каждого подсегмента из 40 отсчетов. Суть аппроксимации состоит в том, что второй остаточный сигнал моделируют в виде определенного числа импульсов на интервале подсегмента.
Если процедуры кратковременного и долговременного анализа сходны во всех современных вокодерах, то методы аппроксимации второго остаточного сигнала существенно отличаются.
80