Дипломная (вкр): Исследование геморгамм больных сепсисом
Эти факторные нагрузки следует понимать как корреляционные коэффициенты между переменными и факторами.
Так, выбраны наибольшие абсолютные значения нагрузок:
Фактор 1 : pO2, мм.рт.ст. (0,842), sO2, % (0,938), FO2Hb, % (0,936), FHHb, % (0,937), рО2(Т), мм.рт.ст. (0,839).
Фактор 2 : pH, мм.рт.ст. (0,864), cCI-, ммоль/л (0,802), рН(Т) (0,862), р50,с, мм.рт.ст. (0,852).
Фактор 3 : ctHb, г/дл (0,935), FCOHb, % (0,886), Hct ,c (0,934), ctO2.c, Vol% (0,815).
Фактор 4 : Глюкоза, ммоль/л (0,726).
Фактор 5 : Лактат, ммоль/л (0,887).
Фактор 6 : сК+ (0,800).
Интерес представляют факторы 1, 2 и 3, так как они являются наиболее решающими, нежели 4, 5 и 6, их значимость падает из-за малого наличия компонентов. 1, 2 и 3.
Вербально вывод для полученных результатов можно описать как предположение о том, что такое распределение нагрузок и принадлежность их к факторам является либо следствием лечения заболевания и применения определенного вида препаратов, которые имели влияние на формирование показателей именно в таком представлении, либо особенностями течения заболевания, при которых показатели нагрузок объединяются в факторные группы.
Можно заметить, что фактор 1 вызывает рост парциального давления О2, а также увеличение содержания кислорода. Возможно предположение о том, что больному было оказано лечение в виде оксигенотерапии или ингаляции, с целью повышения уровня содержания кислорода в крови.
Фактор 2 можно связать с влиянием на кислотность крови, этот фактор
вызывает рост кислотности рН. Можно предположить, что пациенту были прописаны магниево-, кальциево- и калиево- содержащие препараты с целью восстановления кислотности и обменных процессов, а так же оказана против-стрессовая терапия и специальная диета.
Фактор 3 влияет на увеличение гемоглобина в крови. Соответственно, можно выдвинуть предположение о том, что пациенту были выписаны железосодержащие препараты с целью повышения гемоглобина.
Можно сделать вывод о том, что возможно выявить общность нагрузок в зависимости от медицинских препаратов и методов лечения.
Факторы можно визуально изобразить в виде
трехмерной модели рассеяния компонентов.
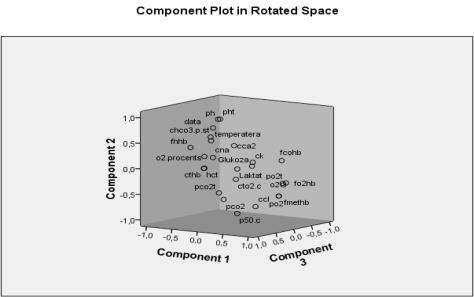
Рисунок 8 - Диаграмма компонентов в повернутом
пространстве
3.4 Кластерный
анализ
В результате кластерного анализа при помощи предварительно заданных переменных формируются группы наблюдений - любые объекты. Члены одной группы (одного кластера) должны обладать схожими проявлениями переменных, а члены разных групп различными.
В иерархических методах каждое наблюдение образовывает сначала свой отдельный кластер. На первом шаге два соседних кластера объединяются в один; этот процесс может продолжаться до тех пор, пока не останутся только два кластера. В методе, который в SPSS установлен по умолчанию (Between-groups linkage (Межгрупповые связи)), расстояние между кластерами является средним значением всех расстояний между всеми возможными парами точек из обоих кластеров. Представим при помощи простой диаграммы рассеяния частные случаи кластерного анализа относительно известных данных газов крови и проведем иерархический кластерный анализ с двумя переменными.
Для обозначения переменной наблюдения мы
использовали дату забора.
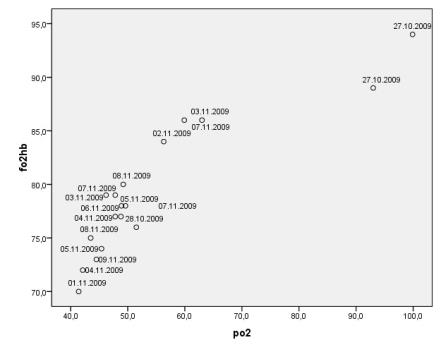
Рисунок 9 - Диаграмма рассеяния переменных FO2Hb
(фракции оксигемоглобина) и pO2 (кислородное парциальное давление)
Легко заметить, в пределах каких величин лежит основное число точек.
Можно увидеть две отдельных отчётливых группировки точек, два кластера в нижней половине диаграммы и пара точек в верхнем правом углу. Следовательно, переменные FO2Hb (фракции оксигемоглобина) и pO2 (кислородное парциальное давление), явно распадаются на два различных кластера по да-там забора крови.
Данные, которые по значениям двух рассмотренных переменных похожи друг на друга, принадлежат к одному кластеру; данные, находящиеся в различных кластерах, не похожи друг на друга. Решающим критерием для определения схожести и различия двух данных является расстояние между точками на диаграмме рассеяния, соответствующее им. Подробно разберем один пример.
После обычной обшей статистической сводки итогов по наблюдениям, проводим обзор принадлежности, из которого можно выяснить очерёдность построения кластеров, а также их оптимальное количество. По двум колонкам, расположенным под общей шапкой Cluster Combined (Объединение в кластеры), можно увидеть, что на первом шаге были объединены наблюдения 11 и 12 (т.е. 5 и 6 число месяца). Эти два дня максимально похожи друг на друга и отдалены друг от друга на очень малое расстояние. Эти два наблюдения образовывают кластер с номером 11, в то время как кластер 12 в обзорной таблице больше не появляется. На следующем шаге происходит объединение наблюдений 11 и 13 (5 и 7 число месяца), затем 17 и 18 (8 и 9 число месяца) и т.д.
Для определения, какое количество кластеров
следовало бы считать оптимальным, решающее значение имеет показатель, выводимый
под заголовком "Coefficients" в таблице 6, приведенной ниже. По этим
коэффициентом подразумевается расстояние между двумя кластерами, определенное
на основании выбранной дистанционной меры с учётом предусмотренного
преобразования значений. В нашем случае это квадрат евклидового расстояния,
определенный с использованием стандартизованных значений. На этом этапе, где
эта мера расстояния между двумя кластерами увеличивается скачкообразно, процесс
объединения в новые кластеры необходимо остановить, так как в противном случае
были бы объединены уже кластеры, находящиеся на относительно большом расстоянии
друг от друга.
Таблица 6 - Agglomeration Schedule (порядок агломерации) для FO2Hb и pO2
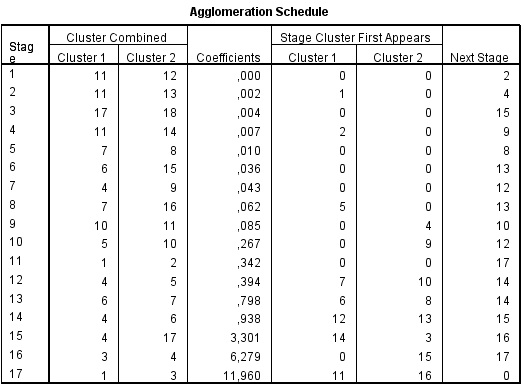
В приведенном примере - это скачок с 3,301 до
6,279. Это означает, что после образования трёх кластеров мы больше не должны
производить никаких последующих объединений, а результат с тремя кластерами
является оптимальным. Визуально же мы ожидали результат с двумя кластерами.
Оптимальным считается число кластеров равное разности количества наблюдений
(здесь: 17) и количества шагов, после которого коэффициент увеличивается
скачкообразно (здесь: 14). Далее по отдельности для результатов расчёта
содержащих 5, 4, 3 и 2 кластеров, ниже приводится таблица 7 - Cluster
Membership (принадлежность к кластеру) для FO2Hb и pO2 с информацией о
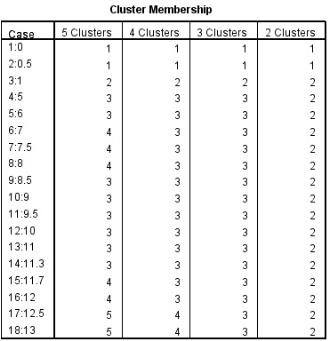
принадлежности каждого наблюдения к кластеру. Таблица 7 показывает, что два
наблюдения 17 и 18 (12 и 13 день лечения или 8 и 9 число месяца) при переходе к
3-х кластерному решению были включены в кластеры, соседствующие на диаграмме
рассеяния; эти дни при оптимальном кластерном решении рассматриваются как
принадлежащие к одному кластеру. Если посмотреть на 2-х кластерное решение, то
оно группирует наблюдения 11, 12, 13 и 14 (5, 6, 7 число месяца), то есть дни
нижних крупных кластеров диаграммы рассеяния.
Таблица 7 - Cluster Membership (принадлежность к кластеру) для FO2Hb и pO2
Процесс слияния мы можем пронаблюдать на
дендрограмме ниже.
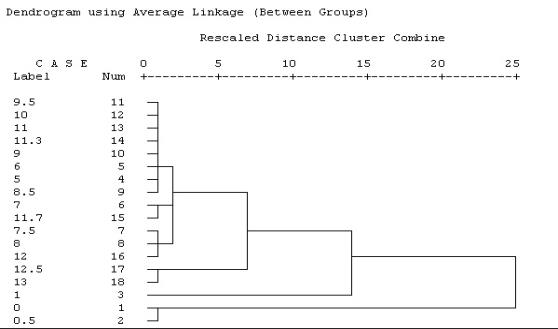
Рисунок 10 - Дендрограмма процесса слияния
кластеров для FO2Hb и pO2
Рассмотрим еще один интересный случай
кластерного анализа и его иерархического представления на примере анализа
данных газов pCO2 (парциальное давление двуокиси углерода) и cNa+ (концентрация
ионов натрия). Переменная наблюдения так же, дата забора анализов.
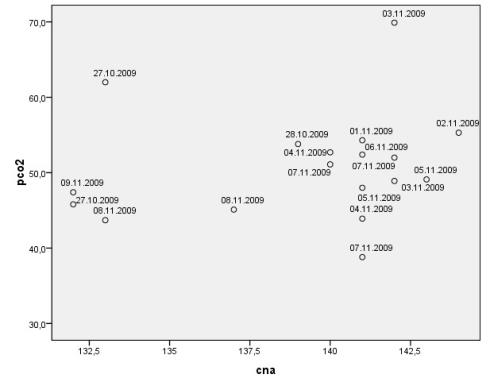
Рисунок 11 - Диаграмма рассеяния переменных pCO2 (парциальное давление двуокиси углерода) и cNa+ (концентрация ионов натрия)
Проводим обзор принадлежности в таблице 8,
приведенной ниже, из которой можно выяснить очерёдность построения кластеров, а
также их оптимальное количество и определим, на каком этапе мера расстояния
между двумя кластерами увеличивается скачкообразно, следовательно, процесс
объединения в новые кластеры необходимо остановить.
Таблица 8 - Agglomeration Schedule (порядок агломерации) для pCO2 и cNa+
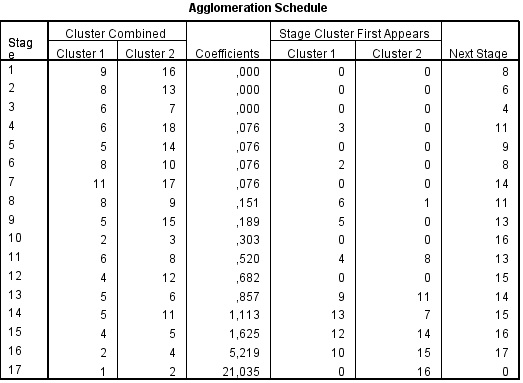
Отчетливо видно, что после трех крупных скачков коэффициентов нам необходимо остановить образование кластеров, так как мы не нуждаемся в большем их количестве.
По диаграмме рассеяния переменных мы заметили, что группы точек образую два кластера и несколько отдельных точек, что видно по таблице порядка агломерации, наибольшее расстояние у нас между двумя отдельными кластерами, именно они и представляют интерес для рассмотрения.
Процесс слияния мы снова можем пронаблюдать на
дендрограмме. Она идентифицирует объединённые кластеры и значения коэффициентов
на каждом шаге. При этом отображаются не исходные значения коэффициентов, а
значения, приведенные к шкале от 0 до 25. Кластеры, получающиеся в результате
слияния, отображаются горизонтальными пунктирными линиями.
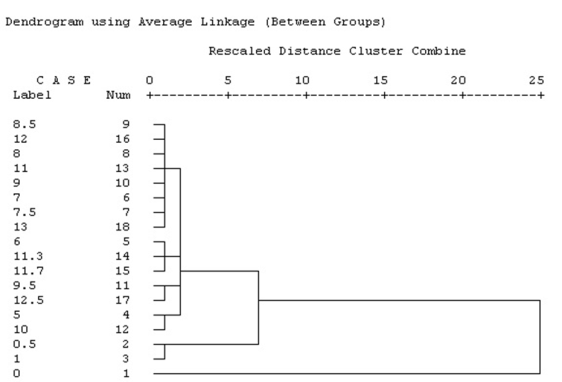
Рисунок 12 - Дендрограмма процесса слияния
кластеров для pCO2 и cNa+
Для переменных FO2Hb (фракции оксигемоглобина) и pO2 (кислородное парциальное давление) и pCO2 (парциальное давление двуокиси углерода) и cNa+ (концентрация ионов натрия), рассмотренных нами и проанализированных с помощью иерархического кластерного анализа с двумя переменными, очевидно кластерное слияние показаний по переменной времени (или дня лечения), что можно увязать с прогрессированием заболевания и спецификой выбранного лечения, что сказывалось на данных показателей.
Переменные схожи между собой в большей или
меньшей степени, соот-ветственно, схожие в больше степени, можно объединить в
группы с общими свойствами - кластерами. Как можно заметить по диаграммам
рассеяния переменных, для FO2Hb и pO2, основная масса, составляющая наибольший
кластер лежит в области, находящейся в пределах значений 70-80 и 40-55
соответственно. Аналогично, для переменных pCO2 и cNa+, основная масса значений
кластера принадлежит области в пределах значений 40-50 и 140-145
соответственно. При правильной интерпретации этих данных они могут оказать
большую помощь в мониторинге развития заболевания и отслеживании процесса
лечения пациента.
3.4 Roc анализ
анализ основан на использовании ROC-кривой (Receiver Operator Characteristic), которая показывает результаты бинарной классификации, когда модель предсказывает вероятность того, что наблюдение относится к одному из двух классов. В таком случае важен выбор точки отсечения, то есть порога отсечения, разделяющего классы. ROC-кривая позволяет построить зависимость количества верно классифицированных положительных примеров от количества неверно классифицированных отрицательных примеров.
Количественную интерпретацию ROC даёт показатель AUC (англ. area under ROC curve, площадь под ROC-кривой) - площадь, ограниченная ROC-кривой и осью доли ложных положительных классификаций.
Чтобы четко провести анализ, взяты значения данных пациента больного сепсисом, которые максимально расходятся с нормальными значениями у здорового человека. Анализируемыми значениями в данном случае будут показатели pCO2 (парциальное давление двуокиси углерода) и pO2 (парциальное давление кислорода). В норме у здорового человека эти показатели колеблются в пределах: 35-45 мм. рт. ст. для pCO2, 83-108 мм. рт. ст. для pO2.
Для показателя рСО2 выведем таблицу 9 Case
Processing Summary (Обработанные наблюдения).
Таблица 9 - Case Processing Summary (Обработанные наблюдения) для рСО2
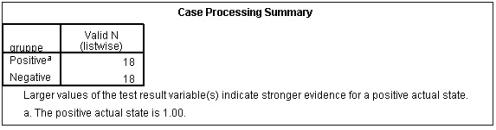
Это означает, что высокие значения переменных указывают на скорее положительный результат теста, а единица означает, что положительный результат теста соответствует состоянию «болен».
Кривая ROC графически представлена на рисунке 13, где в качестве чувствительности теста выступает доля верно положительных предсказаний в суммарном количестве больных. Эта величина характеризует способность теста как можно точнее отфильтровывать пациентов с сомнительным наличием болезни. Под представительностью теста понимают долю верно отрицательных среди здоровых пациентов. Эта величина характеризует способность теста обнаруживать исключительно пациентов с сомнительным наличием болезни.
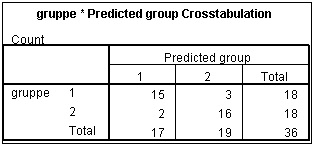
По результатам таблицы 10 можно увидеть, что
Среди 18 фактически больных 15 были верно расценены как больные (Rightly
Positive (Верно положительный), RP), а 3 не верно отнесены к группе здоровых
(Wrong Negative (Ложно отрицательный), WN). Из 18 фактически здорового человека
16 были верно отнесены к группе здоровых (Rightly Negative (Верно
отрицательный), RN) и 2 не верно расценены больными (Wrong Positive (Ложно
положительный), WP).
Таблица 10 - Predicted group Crosstabulation (GRUPPE * Прогнозируемая группа таблица сопряженности) для рСО2
Ведем два понятия: чувствительность и
специфичность модели. Ими определяется объективная ценность любого бинарного
классификатора.или чувствительность есть доля истинно положительных случаев.
Чувствительность (sensitivity) рассчитывают по формуле (2):
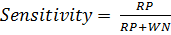 (2)
Чувствительность =15/(15 + 3) = 0,834или
специфичность - доля истинно отрицательных случаев, которые были правильно
идентифицированы моделью. Представительность рассчитывают по формуле (3):
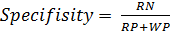 (3)
Представительность = 16/(15 + 2) = 0,941
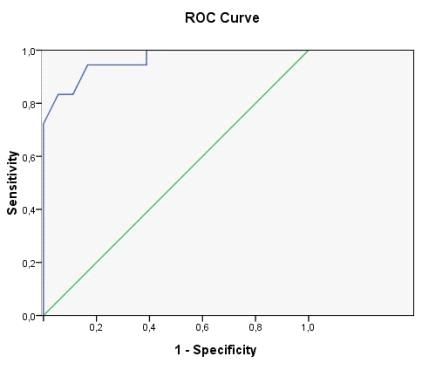
Рисунок 13 - ROC Curve (Кривая ROC) для рСО2
С помощью кривой кривой ROC чувствительность и комплиментарное значения представительности приводятся к единице. Диагностируемое значение с нулевой степенью прогнозирования изображается здесь линией, наклоненной под углом 45 градусов (диагональю). Чем больше выгнута кривая ROC, тем более точным является прогнозирование результатов теста. Индикатором этого свойства служит площадь под кривой ROC, которая для теста с нулевой степенью прогнозирования равна 0,5, а для случая с максимальной степенью прогнозирования - 1.
Площадь под ROC-кривой можно увидеть в расчетной
таблице 11, которую при анализе выведет программа.
Таблица 11 - Area Under the Curve (Площадь под кривой) для рСО2
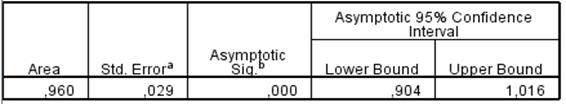
Для рассматриваемого примера получилось значение равное 0,960, причём 95 % доверительный интервал соответствует значениям площади, принадлежащим диапазону от 0,904 до 1,016. Площадь покрытия близка к единице.
Проанализируем данные показателя рО2, зная, что
диапазон показателей здоровых людей колеблется в интервале 83-108 мм. рт. ст. и
отразим результаты в таблице сопряженности.
Таблица 12 - Predicted group Crosstabulation (GRUPPE * Прогнозируемая группа таблица сопряженности) для рО2
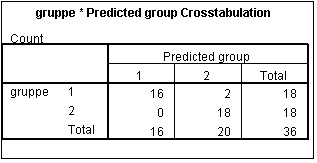
Рассчитаем значения чувствительности и представительности:
Чувствительность =16/(16 + 2) = 0,889
Представительность = 18/(16 + 0) = 1,125
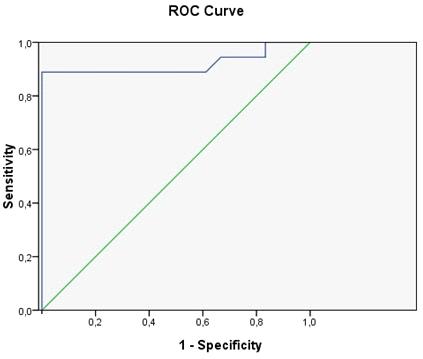
Рисунок 14 - ROC Curve (Кривая ROC) для рО2
Площадь под кривой ROC можно определить из
расчетной таблицы 13, которую программа выводит автоматически, при анализе.
Таблица 13 - Area Under the Curve (Площадь под кривой) для рО2
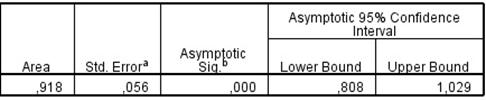
Для рассматриваемого примера получилось значение равное 0,918, причём 95 % доверительный интервал соответствует значениям площади, принадлежащим диапазону от 0,808 до 1,029. Проанализировав при помощи ROC анализа показатели пациента, выяснилось, что выгнутость кривой ROC и рассчитанная под ней площадь указывает на то, что проведенный анализ имеет высокую точность прогнозирования результатов теста. Именно этот факт позволяет с уверенностью сказать, что параметры крови пациента имеют явное отклонение от нормальных величин показателей здоровых людей.
На основе приведенных исследований были сделаны определенные выводы:
. Между показателями крови можно установить математические зависимости.
. Установлены значения коэффициента корреляции. По результатам корреляции можно определить силу зависимости в виде коэффициента корреляции.
. Выявлены факторы, влияющие на гемодинамические показатели, и установлено их количество.