Дипломная (вкр): Оптимизация аэродинамических характеристик крыла в условиях стохастической неопределенности
Каждый входной и выходной вектор нормируется по среднему значению и дисперсии. То есть перед сжатием из компонент вектора вычитаются средние значения и далее они делятся на дисперсию, а после восстановления каждая компонента вектора умножается на дисперсию и добавляется к среднему значению.
Для генерации компоновок крыла следует выделить
множество сжатых векторов. И использовать только разжимающую часть репликатора,
то есть
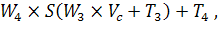
где Vc - сжатый входной вектор.
Аппроксиматор.
Аппроксиматор - это нейронная сеть, которая аппроксимирует функции аэродинамических параметров для крыла и представляет собой четырехслойную сеть персептронного типа. Первые две компоненты входного вектора аппроксиматора: число Маха и угол атаки. Далее идут 17 компоненты вектора, отвечающие за представление компоновки крыла в плане и параметров фюзеляжа, без использования компоненты Y0, которая характеризует расположение крыла на фюзеляже. А после них идут компоненты 10-ти независимых сечений крыла, по 61 значению в каждом. Каждый входной и выходной вектор нормируется по среднему значению и дисперсии. В этой нейронной сети два нелинейных скрытых слоя. Количество нейронов на каждом слое
 768 768
8
Формула для вычисления выхода по входу
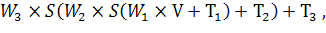
где V
- входной вектор, “ ” - матричное
умножение,
 - сигмоидная
функция активации.
Выходной вектор аппроксиматора состоит из:  и
шести служебных переменных.
нейронный аппроксиматор робастный крыло
4 Ускорение расчётов
Нейроны в одном слое нейронной сети полностью
независимы друг от друга, что позволяет выполнять процесс обучения на
параллельной архитектуре. Для получения приемлемого времени обучения необходимо
увеличить вычислительную мощность в 250-500 раз относительно одного CPU. Для
преодоления этого барьера производительности применялась технология CUDA.
4.1 CUDA
Рост частот универсальных процессоров упёрся в физические ограничения и высокое энергопотребление, и увеличение их производительности всё чаще происходит за счёт размещения нескольких ядер в одном чипе. Продаваемые сейчас процессоры содержат лишь до четырёх ядер (дальнейший рост не будет быстрым) и они предназначены для обычных приложений, используют MIMD - множественный поток команд и данных. Каждое ядро работает отдельно от остальных, исполняя разные инструкции для разных процессов.
Специализированные векторные возможности (SSE2 и SSE3) для четырехкомпонентных (одинарная точность вычислений с плавающей точкой) и двухкомпонентных (двойная точность) векторов появились в универсальных процессорах из-за возросших требований графических приложений, в первую очередь. Именно поэтому для определённых задач применение GPU выгоднее, ведь они изначально сделаны для них.
Итак, перечислим основные различия между архитектурами CPU и GPU. Ядра CPU созданы для исполнения одного потока последовательных инструкций с максимальной производительностью, а GPU проектируются для быстрого исполнения большого числа параллельно выполняемых потоков инструкций. Универсальные процессоры оптимизированы для достижения высокой производительности единственного потока команд, обрабатывающего и целые числа и числа с плавающей точкой. При этом доступ к памяти случайный. У видеочипов работа простая и распараллеленная изначально. Видеочип принимает на входе группу полигонов, проводит все необходимые операции, и на выходе выдаёт пиксели. Обработка полигонов и пикселей независима, их можно обрабатывать параллельно, отдельно друг от друга. Поэтому, из-за изначально параллельной организации работы в GPU используется большое количество исполнительных блоков, которые легко загрузить, в отличие от последовательного потока инструкций для CPU.отличается от CPU ещё и по принципам доступа к памяти. В GPU он связанный и легко предсказуемый - если из памяти читается тексель текстуры, то через некоторое время придёт время и для соседних текселей.
Есть множество различий и в поддержке многопоточности. CPU исполняет 1-2 потока вычислений на одно процессорное ядро, а видеочипы могут поддерживать до 1024 потоков на каждый мультипроцессор, которых в чипе несколько штук. И если переключение с одного потока на другой для CPU стоит сотни тактов, то GPU переключает несколько потоков за один такт.
Кроме того, центральные процессоры используют SIMD (одна инструкция выполняется над многочисленными данными) блоки для векторных вычислений, а видеочипы применяют SIMT (одна инструкция и несколько потоков) для скалярной обработки потоков. SIMT не требует, чтобы разработчик преобразовывал данные в векторы, и допускает произвольные ветвления в потоках.
Вкратце можно сказать, что в отличие от
современных универсальных CPU, видеочипы предназначены для параллельных вычислений
с большим количеством арифметических операций. И значительно большее число
транзисторов GPU работает по прямому назначению - обработке массивов данных, а
не управляет исполнением (flow control) немногочисленных последовательных
вычислительных потоков. Это схема того, сколько места в CPU и GPU занимает
разнообразная логика
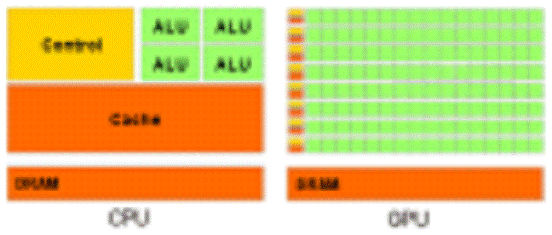
Риc.9
Схема распределения функции вычислительных блоков для CPU
и GPU
В итоге, основой для эффективного использования мощи GPU в научных и иных неграфических расчётах является распараллеливание алгоритмов на сотни исполнительных блоков, имеющихся в видеочипах.
Выполнение расчётов на GPU показывает отличные результаты в алгоритмах, использующих параллельную обработку данных. То есть, когда одну и ту же последовательность математических операций применяют к большому объёму данных, как в случае нейронов, в каждом слое работающих аналогично, но с разным набором данных. При этом лучшие результаты достигаются, если отношение числа арифметических инструкций к числу обращений к памяти достаточно велико.
В результате всех описанных выше отличий,
теоретическая производительность видеочипов значительно превосходит
производительность CPU. Компания NVIDIA приводит такой график роста
производительности CPU и GPU за последние несколько лет
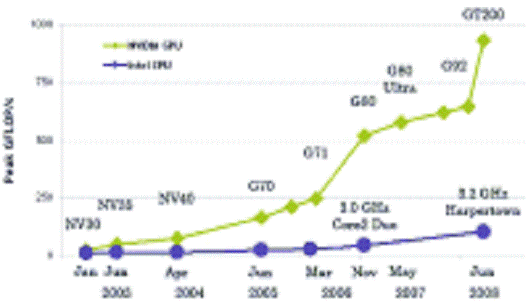
Рис.10 Сравнение теоретической
производительности CPU
и GPU
4.2 Ускорение обучения
Для работы с нейронными сетями больших
размерностей была написана программа реализующая алгоритм Back Propagation на
языке CUDA С. Обучение выполнялось на видеокарте NVidia GTX 570, с
теоретической производительностью 1405 Гигафлоп. Фактически, удалось добиться
увеличения производительности в 300 раз относительно CPU. Зависимость ускорения
от размерности задачи при использовании CUDA представлена на Рис.11.
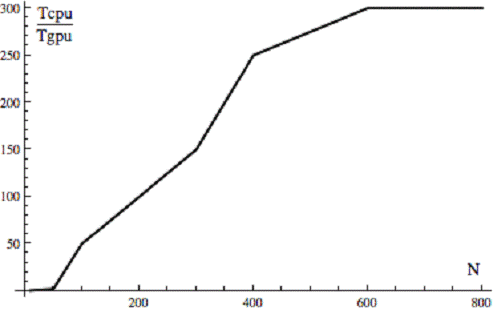
Рис.11 Зависимость прироста ускорения от
размерности задачи
Использование параллельных вычислений на платформе CUDA позволило впервые получить следующие результаты:
Для обучения нейросетей использовалась база
данных из 28000 компоновок ЛА, каждая из которых заранее обсчитывалась в
нескольких режимах угла атаки и числа маха. Часть данных использовалась для
обучения, и около 5% оставлялось для проверки интерполяционных свойств
нейронной сети.
4.3 Обучение аппроксиматора
Для аппроксимации с помощью нейронной сети
использовалась выборка из 19200 различных режимов обтекания 1200 различных
компоновок. Средняя ошибка деленная на дисперсию составила 14% для основного
множества и 15.6% для проверочного.
4.4 Обучение репликатора
Создание сжимающего и восстанавливающего
отображения для компоновок, 14848 входных векторов. Отношение средней ошибки к
дисперсии - 11%, для проверочного множества также 11%. 662 координаты отобразились
в 55. Диаграмма рассеяния на Рис.12 дает некоторое представление о качестве
обучения.
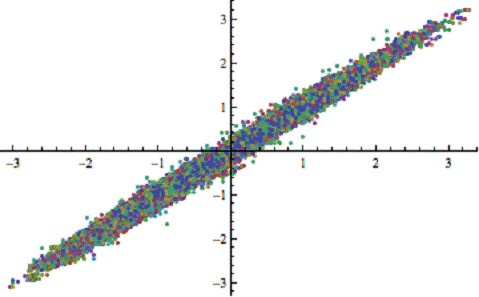
Рис.12 По оси Х - компоненты искомого вектора,
по оси У - вектора компоновки, получаемого нейронной сетью
5 Блок схема алгоритма робастной
оптимизации крыла. И описание реализации метода
Опишем алгоритм робастной оптимизации компоновки крыла:
. С помощью генератора компоновок, порождаем новую случайную компоновку (точнее изменяемую её часть), путём генерации 60 случайных чисел в заданных интервалах. (G)
. Для компоновки G, повторяем Ngist раз следующую процедуру:
1.1 Генерируем случайное число Маха M с плотностью вероятности p(M).
1.2 Из условия
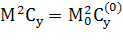
находим необходимый коэффициент подъемной силы  .
.3 По данному и
G находим
соответствующий угол атаки  .
1.4 По углу атаки ,
G, M
находим коэффициент 
. Имея Ngist
значений  находим
вероятность
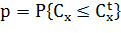 по формуле

Если  ,
то
 ,
 .
Если  ,
то
 оставляем
без изменений.
. Проверяем условие остановки алгоритма
и если оно не выполнено, то переходим к пункту 1. Если условие остановки
выполнено, то выдаем в качестве ответа .
Условие остановки: если число итераций превышает заданное Natt .
G - компоновка крыла
M - число Маха
- коэффициент
сопротивления
- коэффициент
подъемной силы
 - случайная
генерация компоновок
 - случайная
генерация числа M
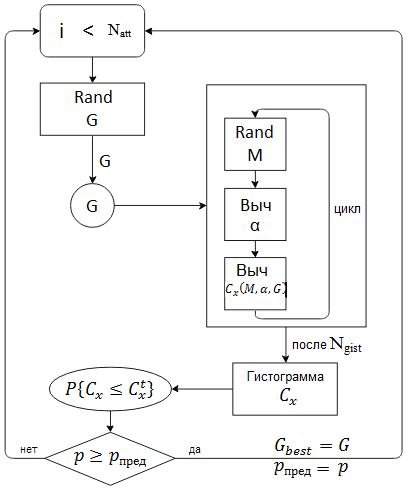
Рис.13 Блок схема программы
Результаты
Была решена модельная задача конечномерной оптимизации при заданных граничных параметрах.
В целом по полученным результатам можно сформулировать следующие выводы:
. С помощью нейронных сетей и статистической выборки можно быстро сгенерировать компоновку оптимального крыла при заданном граничном пороге определяющей характеристики.
. Заданные параметры определяют границы
устойчивости, которые в малом ряде случаев могут быть превышены, в связи с
вероятностным подходом к решению задачи.
Список использованной
литературы
1. Дорофеев Е.А. Введение в теорию искусственных нейронных сетей. Курс лекций. - ФАЛТ МФТИ, 2008/2009 уч. г.
2. Cybenko G.V. Approximation by Superpositions of a Sigmoidal Function. //Jr. Mathematics of Control, Signals and Systems /Springer-Verlag - New York, 1989 - vol. 2 no. 4 - pp. 303-314
3. Колмогоров А.Н. О представлении непрерывных функций нескольких переменных в виде суперпозиции непрерывных функций одного переменного. Докл. АН СССР, 1957. Т. 114, No 5. С. 953-956.
4. Хайкин С. Нейронные сети. Полный курс. /Второе издание. - С.-Пб.: «Вильямс», 2006
. Применение искусственных нейронных сетей в задачах прикладной аэродинамики. //Труды «ЦАГИ»: сб.ст. под ред. Свириденко Ю.Н. /ЦАГИ - 2008 - вып. 2678
. Е.А.Дорофеев. Задачи оптимизации в условиях статистической неопределенности. Москва, 2010.
7. Arthur Earl Bryson, Yu-Chi Ho (1969). Applied optimal control: optimization, estimation, and control. Blaisdell Publishing Company or Xerox College Publishing. pp. 481
8. NVIDIA
CUDA Programming Guide Version 2.3.1 // NVIDIA - World Leader in Visual
Computing Technologies. 2011. URL:
#"805715.files/image103.gif">
Угол стреловидности по задней кромке
базовой трапеции (cwBTE) (см.
Рис.2):
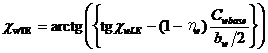
где Cwbase - длина
центральной хорды базовой трапеции крыла (см. Рис.2) есть:
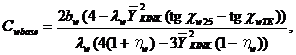
Площадь крыла (Sw):

Длина Средней Аэродинамической Хорды
(Сwmac) (Mean aerodynamic chord (MAC)):
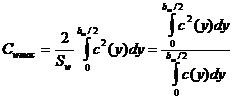 ,
где: c(y) - длина
хорды крыла, лежащей в плоскости с уравнением Y = y. Величина Сwmac равна:
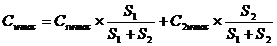 ,
здесь S1 и S2 - площади
трапеций, образующих крыло в плане (см. Рис.2):
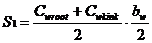
 ;
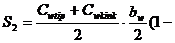 );
Компоненты С1wmac и C2wmac есть:
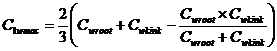 ,
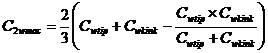 ,
где: длина центральной хорды крыла Cwroot (см. Рис.2)
равна:
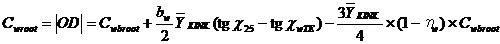 ,
длина концевой хорды крыла Cwtip (см. Рис.2) равна:
Cwtip = hw ´ Cwbroot,
длина хорды в точке излома Cwkink (см. Рис.2) равна:
Cwkink = (1 -) ´ Cwbroot + ´ Cwtip.
Положение Средней Аэродинамической
Хорды (MAC location) (Xwmac, Ywmac, Zwmac) в Системе
Координат Крыла, определяемое координатами носка Средней Аэродинамической
Хорды:
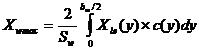
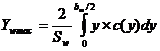
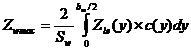 ,
здесь Xle(y) и Zle(y) - X- и Z-координаты передней кромки крыла в системе координат крыла как функции значения координаты Y = y.
Величины Xle(y) и Zle(y) равны:
Xle(y) = y ´ tgcwLE;(y) = y ´ tgVw,
поэтому:= Ywmac ´ tgcwLE;= Ywmac ´
tgVw,
Величина Ywmac равна:
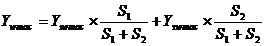 ,
Где 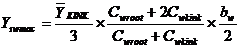 ,
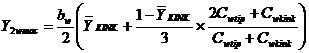 ,
Положение X-координаты
25%-точки Средней Аэродинамической Хорды (X-coordinate of 25%MAC location) Xwmac25 в Системе
Координат Крыла:
Xwmac25 = Xwmac + 0.25 ´ Cwmac.
Приложение 2
Параметры фюзеляжа
Таблица 2 Модельные параметры фюзеляжа
|
Обозначение |
Модельные параметры фюзеляжа |
|
dmax |
Максимальная ширина фюзеляжа |
|
|
|
|
|
|
|
|
|
|
|
|
|
e |
|
|
zt= |
|
 Удлинение
носовой части фюзеляжа
 Удлинение
центральной части фюзеляжа
 Удлинение
хвостовой части фюзеляжа
 Отношение
высоты к ширине центральной части фюзеляжа
 Отклонение
вверх хвостовой части фюзеляжа. Здесь z0(Lf) есть z-координата
центра сечения S(Lf).