Материал: Оптимизация и моделирование в автоматизированных системах. труд. ФГБОУ В.О., Воронежский г.т.и
Важно понимать, что и существующие программные решения работают с журналом, но строят отчеты на основе аналитических моделей. Это позволяет визуализировать текущее состояние только в виде различных графиков и статистических данных. Для более детального анализа бывает полезно знать, например, наличие и размеры очереди на доступ к программным средствам при сокращении количества закупленных лицензий. Для реализации такого функционала хорошо подойдут имитационные модели [1], так как они позволяют собирать информацию, которую сложно получить аналитически.
Основной идеей создания системы является предоставление возможности использовать гибкие имитационные модели. Эти модели, с одной стороны, могут быть отредактированными администраторами (при помощи визуального конструктора моделей), а с другой стороны, подстраиваются под текущую конфигурацию системы (например, изменяют количество блоков, имитирующих отделы компании в зависимости от их реального количества).
Для реализации такого функционала необходим алгоритм расчета имитационных моделей. На вход поступает модель в виде специализированного описания (аналог представления модели в среде GPSS) и данные из журнала использования ПО. Расчет модели происходит путем прогона потока заявок через элементы системы, имитирующие стандартные объекты моделирования: очередь, ключ, обработка и т.д. Взаимное расположение таких объектов определяется путем анализа описания имитационной модели.
Для поддержки возможности оптимизации таких моделей требуется создать компонент, который будет работать на основе генетических алгоритмов. Такое решение обусловлено тем, что изначально неизвестен весь перечень оптимизируемых моделей, поэтому сложно подобрать какой-то более специализированный алгоритм оптимизации [2]. Для реализации оператора репродукции система должна использовать имитационную модель в качестве целевой функции. Популяцию будут составлять наборы входных параметров имитационной модели. Результаты работы модели – это совокупность параметров, которые рассматриваются как значения целевой функции. Остальные операторы генетического алгоритма работают так же, как операторы простого ГА.
Активное развитие компьютеров и технологий создает все большую зависимость бизнеса от IT-индустрии, так как она способна обеспечить планомерное развитие и усовершенствовать бизнес-процессы. В связи с этим возникает потребность в анализе и планированию затрат на ПО. При использовании системы на основе гибких моделей данных, конечный потребитель получит относительно простое решение, которое будет включать какие-то базовые имитационные и аналитические модели и далее сможет сделать его настолько сложным, насколько это понадобится.
70
Литература
1.Воробьев Э. И. Моделирование и анализ сложных систем: учеб. пособие. – Воронеж: ВГТУ, 2005. - 118 с.
2.Гладков Л. А., Курейчик В. В., Курейчик В. М Генетические алгоритмы системы - М.: Физматлит, 2010. - 368 с.
3.Google Trends. – Электрон. дан. – Режим доступа: https://trends.google.ru
Воронежский государственный технический университет
УДК 004.04
Д. В. Романов
БАЙЕСОВСКИЙ КЛАССИФИКАТОР ТРАНЗАКЦИЙ ДЛЯ ЛОГИСТИЧЕСКОЙ СИСТЕМЫ
Классификация транзакций по классам безопасности – основная задача антифрод-системы – комплексного инструмента по обнаружению и пресечению неправомерных действий клиента сервиса [1]. Для логистической сферы характерна бинарная классификация, то есть каждая транзакция может принадлежать либо к классу «подозрительных», либо «безопасных».
Наиболее современным подходом к классификации принято считать алгоритмы машинного обучения, модели которых настраиваются на обучающей выборке с последующим использованием на реальных данных. Проведенные исследования показывают, что при малых объемах такие алгоритмы показывают точность распознавания до 90% [1]. Однако в ходе эксплуатации выявляются некоторые проблемы. Во-первых, адаптивность к изменениям существенно понижает точность алгоритмов. Это объясняется ложной корреляцией между параметрами транзакций – то есть связь между отдельными параметрами, которые в действительности никак не связаны. А вовторых, при большом количестве анализируемых параметров классификация может быть противоположной, видной только при анализе данных экспертом. В конечном итоге подход оказывается бесполезным и непригодным в использовании.
Возможным решением может быть использование вероятностного классификатора. Байесовский подход к классификации предполагает выбор максимальной апостериорной вероятности, которая вычисляется с помощью функции правдоподобия [1]. Наиболее простой и эффективной реализацией такого подхода является строгий (наивный) байесовский классификатор.
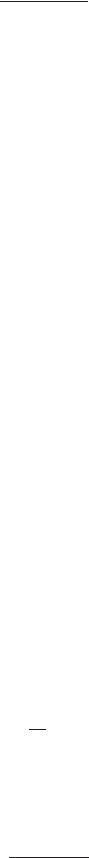
Основу классификатора составляет теорема Байеса с условием независимости событий:
71
ȁݐ |
ݐȁ |
ǡ |
(1) |
ݐ |
|
где ȁݐ – вероятность, что транзакция ݐ принадлежит к классу безопасности ; ݐȁ – вероятность встретить транзакцию ݐ среди класса ;– безусловная вероятность транзакции класса ; ݐ – безусловная вероятность транзакции ݐ среди других.
Важной особенностью здесь является взаимовыражение причины и следствия.
Для того, чтобы определить класс безопасности, перейдем от вероятностей к оценке апостериорного максимума, т.е. наиболее вероятному классу. Упростив форм. 1 – убрав из рассмотрения вероятность транзакции, которая не оказывает влияния на итоговую оценку классов, получим:
Так как транзакция в |
ݔ ݐȁ Ǥא |
|
|
|
(2) |
нашем случае представляет собой набор данных по ней, а также ретроспективные данные по клиенту, то ее условную вероятность можно представить в виде произведения условных вероятностей этих
характеристик [2]: |
|
|
ݐȁ ݓ ȁ ݓ ȁǥ ݓ ȁ ݓ ȁ Ǥ |
(3) |
|
|
|
|
Для удобства вычисления можно воспользоваться свойством логарифма произведения, который не изменяет параметров, при которых достигается максимум, и таким образом форм. 2 примет вид:
|
|
ݔא |
ݓ ȁ Ǥ |
|
(4) |
|||
|
|
|
|
|
|
|
|
|
Вероятность класса безопасности определяется как: |
|
|
||||||
где |
|
– общее |
|
|
|
ǡ |
|
(5) |
|
|
|
количество транзакций в выборке; |
|
– количество |
|||
транзакций определенного класса. |
|
|
|
|
||||
Для определения условной вероятности каждой характеристики |
||||||||
транзакции воспользуемся мультиномиальным распределением [2]: |
||||||||
|
|
|
|
|
|
|
(6) |
|
|
|
|
ݓ ȁ σ א ǡ |
|
|
|||
72
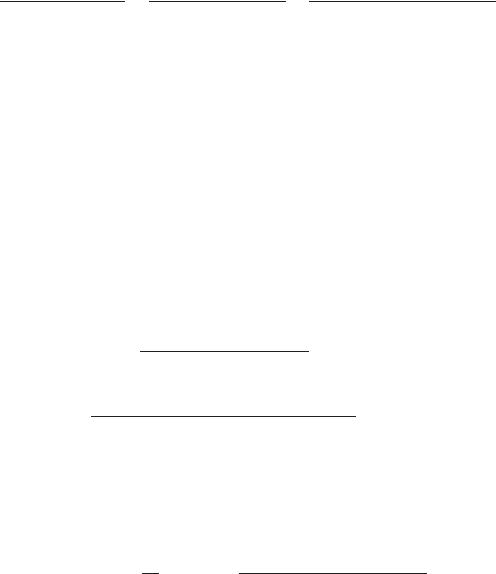
где – количество раз, в которых характеристика встречается в транзакциях текущего класса; – набор из всех возможных характеристик оценки транзакции.
Использование такого подхода накладывает особенность – при появлении новой характеристики транзакции ее условная вероятность становится нулевой, что делает классификацию невозможной. Одним из вариантов решения может служить сглаживание Лапласа – добавление некоторого коэффициента размытия ݖ для каждой характеристики. Для рассматриваемой задачи за коэффициент возьмем минимальное количество появления одной характеристики [1]. Преобразовав форм. 6 получим:
ݓ ȁ |
ݖ |
|
ݖ |
|
|
Ǥ |
(7) |
σ א ݖ |
ȁ ȁݖ σ א |
ȁ ȁ σ א |
|
Сравним на примере оценку, полученную таким преобразованием. Возьмем 3 характеристики и добавим новую (4 – более 4 устройств захода на аккаунт):
|
|
Таблица 1 |
|
|
Характеристики транзакций |
||
|
|
|
|
Номер |
Характеристика |
Количество транзакций |
|
1 |
Более 5% неудачных платежей с карты |
3428 |
|
2 |
Есть адреса доставки в разных странах |
2731 |
|
3 |
Не подключены профили социальных сетей |
4965 |
|
Исходя из табл. 1 коэффициент размытия будет равен 2731, а
вероятности: |
|
|
͵ ʹͺ |
|
|
|
ݓ ȁ |
|
ǡ͵Ǣ |
(8) |
|||
͵ ʹͺ ʹ ͵ ͻ |
|
|||||
כ |
|
|
͵ ʹͺ ʹ ͵ |
|
(9) |
|
ݓ ȁ |
ʹ ͵ ͵ ʹͺ ʹ ͵ ͻ ǡʹͺǤ |
|
||||
где * – с применением сглаживания Лапласа. Изобразим сравнение оценок и убедимся, что для новой характеристики будет ненулевая оценка.
Таким образом, форм. 4 примет вид:
ݔא |
|
|
|
|
Ǥ |
(10) |
|
|
ȁ ȁ σ א |
|
Рассчитав вероятность для каждого класса безопасности выбираем наибольший, и именно к этому классу будет определена транзакция.
73
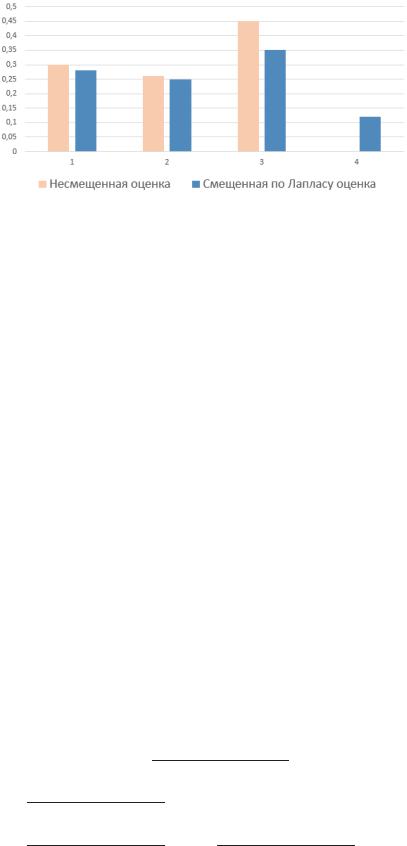
Рис. График сравнения оценок
Целиком продемонстрируем работу байесовского классификатора на примере данных по нескольким характеристикам транзакций.
|
|
|
|
|
|
|
|
|
|
Таблица 2 |
||
|
Статистика транзакций по классам безопасности |
|||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
Характеристика |
|
|
|
|
Безопасные |
|
Подозрительные |
|||||
Более 5 адресов доставки |
|
|
|
207 |
|
146 |
|
|
||||
Заход не из страны регистрации более 5% |
|
1533 |
|
572 |
|
|
||||||
Более 10% подозрительных платежей |
|
4581 |
|
3995 |
|
|
||||||
2 и более банковских карт оплаты |
|
784 |
|
802 |
|
|
||||||
Нет профиля социальной сети |
|
4965 |
|
748 |
|
|
||||||
|
|
|
|
|
|
|
|
|
|
Таблица 3 |
||
Сводная статистика транзакций и их характеристик |
||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Параметр |
|
|
|
|
Безопасные |
|
Подозрительные |
||||
Общее количество транзакций |
|
|
120436 |
|
|
85709 |
|
|
||||
Суммарное количество характеристик |
|
|
12070 |
|
|
6263 |
|
|
||||
Классифицируем транзакцию, которая обладает 1-ой, 3-ей и 5-ой |
||||||||||||
характеристиками для обоих классов безопасности: |
|
|
|
|
||||||||
|
|
|
ʹ ͵ |
|
|
|
|
|
||||
|
ʹ ʹ |
ʹ ͵ ͺ ͻ |
(11) |
|
||||||||
|
ʹ ʹ |
|
|
ͻ ʹ |
|
|
|
|
||||
|
ͺ ʹ |
|
|
|
|
|
|
|||||
|
ʹ ʹ |
|
|
ʹ ʹ |
ʹǡ Ǣ |
|||||||
74