Материал: Оптимизация и моделирование в автоматизированных системах. труд. ФГБОУ В.О., Воронежский г.т.и
УДК 004.853
С. В. Коноплёв
ПРОЕКТИРОВАНИЕ ТИПОВОГО РАБОЧЕГО ПРОЦЕССА НАУЧНОГО ИССЛЕДОВАНИЯ ДЛЯ СИСТЕМ ВИЗУАЛЬНОЙ АНАЛИТИКИ
Современные аналитические платформы позволяют решать сложные задачи исследования данных без непосредственного написания кода. Их преимущества очевидны – пользователи без специальной подготовки, не имеющие серьезных навыков программирования, могут использовать готовые шаблоны анализа данных и адаптировать их под свои нужды, создавая тем самым сложные аналитические модели, которые они не смогли бы сами создать. Кроме того, визуальные среды являются прекрасным инструментом для документирования. Нет необходимости читать код, потому что визуальное представление само по себе дает пользователю информацию о том, какие действия были или будут выполнены. Более того, конфигурация каждого модуля построена так чтобы быть интуитивно понятной. Эти особенности позволяют создавать широкий спектр удобных, многократно используемых средств обработки данных, заключающих в себе передовые достижения Data Science [1].
В настоящее время на рынке программного обеспечения присутствует большое количество продуктов анализа данных, похожих по своим возможностям и спектру решаемых задач, но для введения студенческой проектной деятельности главным требованиям к такой системе являются – доступность, простота освоения и использования. Анализ известного и доступного ПО позволил выбрать KNIME [2].
Knime Analytics Platform – открытая программная среда анализа данных. Она позволяет реализовывать полный цикл анализа данных – чтение данных из различных источников, преобразование и фильтрацию, собственно анализ, визуализацию и экспорт. KNIME позволяет пользователям визуально создавать потоки данных, выборочно выполнять некоторые или все этапы анализа, а затем проверять результаты, модель и интерактивные представления. KNIME написана на языке программирования Java на платформе Eclipse, что дополнительно делает возможным ее расширение путем добавления плагинов, обеспечивающих дополнительную функциональность. Это инструментальное средство анализа данных может быть максимально эффективно для проведения научных исследований студентов, поскольку позволяет наглядно отобразить процесс обработки данных, а также не требует специальных навыков программирования. Кроме того, студенты направлений информационного профиля могут изучать реализацию существующих узлов, дописывать свои компоненты (узлы), дополнять существующие библиотеки и создавать новые [3].
110
Несмотря на удобство использования и широкие возможности, работа с KNIME требует хорошего владения информационными технологиями анализа данных и знания особенностей использования разнообразных методов машинного обучения, что изучают не на всех инженерных специальностях. Преодолеть эту проблему и облегчить вхождение в Data Science можно путем создания простых шаблонов часто решаемых задач исследования данных с интерактивной навигацией. Для этого необходимо создание типового процесса научного исследования, который мог бы быть использован на платформе KNIME исследователями любого уровня квалификации.
В информационных системах под рабочим процессом понимается описание потока задач для получения конечного результата. Самая простая структура такого процесса работает с некоторыми входными данными для получения выходных данных. Несколько таких заданий обработки данных могут быть объединены последовательно для создания структуры типа конвейер, где каждое задание с выхода одного этапа обработки (задания) передается на вход следующего.
Рабочий процесс в KNIME состоит из узлов и направленных ребер, образующих направленный ациклический граф (DAG) [4]. В нем отсутствуют направленные циклы, но могут быть параллельные пути, выходящие из одного узла, и разными путями приходящие в конечный узел. Каждый узел является процессором обработки данных с одним или несколькими входными и/или выходными портами. Возможно использование портов трех типов: плоские таблицы данных, модели данных и базы данных. Тип обработки варьируется от базовых операций с данными – вычисление среднего, регрессионный анализ и другие методы статической обработки или машинного обучения, до создания отчетов и моделирования данных с интенсивными вычислениями. Все категории доступных узлов перечислены в репозитории узлов. Вдоль направленных ребер данные или модели передаются из выходного порта во входной порт другого узла.
Для представления научного исследования в виде рабочего процесса вычислительной системы можно ввести понятие жизненного цикла по аналогии с информационной технологией обработки данных [5], где каждая фаза (этап обработки) имеет независимый цикл и производит явные метаданные.
Жизненный цикл исследования начинается с определения протокола эксперимента. На этом этапе ученые формулируют гипотезу, планируют эксперимент, определяют необходимые ресурсы и данные. В рабочем процессе KNIME его можно представить, как выбор источника данных, например, данные будут сгруппированы в таблицу, столбцы которой – параметры эксперимента, каждая строка – одно наблюдение (Table Reader на рис. 1).
На втором этапе происходит само экспериментальное исследование, когда исследователь выполняет экземпляры конкретных рабочих процессов в соответствии со своими потребностями, используя реальные параметры и наборы данных в производственной среде или полевых условиях.
111
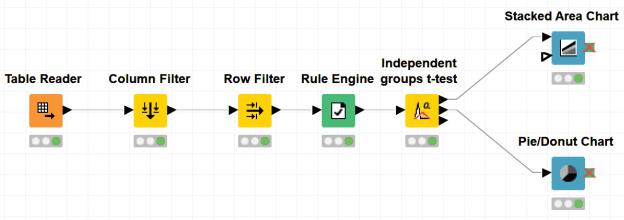
Рис. Типовой рабочий процесс научного исследования
Естественно, аналитическая платформа не будет сама проводить эксперимент, но сможет проводить мониторинг получаемых данных в соответствии с заданным фильтром (Column Filter). Такой фильтр может быть настроен на удаление выбросов, поиск повторяющихся значений и другие методы «очистки» данных. Второй фильтр (Row Filter) на схеме предназначен для поиска и/или заполнения пропущенных параметров каждого наблюдения, что требуется в статическом анализе.
На этапе анализа могут быть использованы методы машинного обучения, такие как Нейронные сети, Деревья решений, Метод опорный векторов, Баессовская сеть, Генетические алгоритмы, а также средства интеллектуального анализа данных. Также для удобства исследователя включены средства визуальной аналитики (два вида Chart на рис. 1). Запрос результатов и их актуализации облегчает понимание эксперимента, а также позволяет увидеть новые и интересные гипотезы и факты, поэтому он был вынесен в отдельный этап типового процесса.
Таким образом, предложенная схема проведения научного исследования в системе KNIME обеспечивает молодого исследования требованиями к проведению эксперимента, показывает возможности включения разнообразных методов анализа данных для получения новых научных знаний и актуализирует полученные результаты в наглядной форме.
Литература
1.Vicario G., Coleman S. A review of data science in business and industry and a future view //Applied Stochastic Models in Business and Industry. – 2019.
2.Коноплёв С. В. Выбор программных инструментов анализа данных для студенческого научного исследования // Информационные технологии в строительных, социальных и экономических системах, 2019. – С 157-161.
3.Meinl T., Jagla B., Berthold M. R. Integrated data analysis with KNIME //Open Source Software in Life Science Research. – Woodhead Publishing, 2012. – С. 151-171.
112
4.Goble C., Missier P., De Roure D. Scientific workflows. – 2008.
5.Львович И. Я., Минакова О. В., Ситникова В. П. Информационная технология интеллектуализации процесса диагностики физического развития детей// Вестник Воронежского института высоких технологий. – 2008. – № 3. –
С. 112-115.
Воронежский государственный технический университет
УДК 378.147
О. В. Минакова, О. В. Курипта
ОРГАНИЗАЦИЯ ИНФОРМАЦИОННО-ОБРАЗОВАТЕЛЬНОЙ СРЕДЫ ВУЗА НА ОСНОВЕ МИКРОСЕРВИСОВ
Постоянное развитие информационно-образовательной среды (ИОС) ВУЗа закреплено в требованиях Федерального закона №273-ФЗ «Об образовании в Российской Федерации», а в условиях реализации Федеральных государственных образовательных стандартах высшего образования нового поколения (ФГОС ВО) отдельно указаны требования к электронной информационно-образовательной среде [1].
В настоящее время во многих ВУЗах развернут информационный портал, включающий типовые компоненты учебного заведения: электронная библиотека, электронный отдел кадров, приемная комиссия, электронный деканат, подсистема контроля знаний, подсистема интерактивного взаимодействия, подсистема авторизации, а также информационно-справочная система по всем направлениям деятельности – образовательная, научная, воспитательная и прочие, включая текущие события и новости.
Этот принцип построения ИОС базируется на предоставлении пользователям продукта – образовательной услуги, как в широком смысле – получение профессиональных компетенций, так и в узком – знакомство с научной статьей, инновационной разработкой и другими достижениями [2].
Личностно-ориентированная образовательная парадигма [3] определяет систему образования как совокупность условий для развития человека, что переводит образовательные системы от механизмов передачи обучающемуся суммы знаний, умений, навыков в сторону комплексного развития обеспечивает соответствие интересов развития общества и индивида. Сегодня ИОС – «стратегическая модель образовательного процесса образовательной организации, которая реализуется через систему средств коммуникации коллективных и индивидуальных субъектов, и систему средств фиксации, хранения и трансляции учебного материала и взаимодействия с ним» [4]. Кроме того, «цифровая образовательная среда» как вариант социального пространства должна учитывать социальные механизмы – конкуренцию, кооперацию,
113
взаимообучение и взаимооценивание: «лишь в режиме совместной деятельности можно преодолеть отчуждение, научиться вести конструктивную дискуссию, реагировать на критику, устанавливать и поддерживать общение» [5].
Обучающиеся, начиная действовать в информационно-образовательной среде, видоизменяют ее, подстраивают под собственные потребности, одновременно сами интегрируются в нее. Обучение в ИОС требует от учащихся умения самостоятельно организовать работу с ее ресурсами, т.е. находить, перерабатывать, использовать и создавать информацию, ориентироваться в информационном пространстве. Это требует изменения концепции построения всей ИТ-инфраструктуры ВУЗа, предоставляющей образовательную услугу к среде, которая “структурируется”, “культивируется” субъектами и динамической сетью их взаимодействий [4].
Наиболее отвечает этим задачам микросервисная архитектура информационных систем, которая представляет набор микросервисов из которых можно в любом сочетании построить систему, ориентированную на конкретную цель.
Модель микросервисов имеет разную трактовку. В широком смысле, это разновидность сервис-ориентированной архитектуры программного обеспечения, в которой приложения на стороне сервера строятся путем объединения множества однозадачных, минимальных сетевых сервисов. Более точно – это архитектура приложения, полностью состоящего из множества взаимодействующих через внутренний интерфейс компонентов. Полностью независимые микросервисные компоненты обеспечивают абсолютно автономное функционирование, что в результате обеспечивают максимальную гибкость и масштабируемость, упрощение тестирования, эффективную функциональную композицию, изоляцию окружения и возможность полностью автономной разработки. Именно автономность позволит каждому студенту строить свою собственную, удобную и целенаправленную среду. Огромным плюсом такого подхода является и то, что отдельные сервисы могут быть разработаны самостоятельно – для себя, коллег и для новых возникших потребностей, что делает ИОС адаптируемой под каждого студента и станет, действительно, средой для получения и развития общекультурных и профессиональных компетенций.
Идеальный микросервис должен полностью изолировать свои данные от внешнего мира и предоставлять их только с помощью API (интерфейс программных приложений). Такой интерфейс пользователя обеспечивает доступ к функциям информационной системы, но в роли пользователя выступает другое приложение. API – это средство для распределения ключевого функционала в таком виде, чтобы им могли пользоваться потребители сервисов, чья задача – создавать важные механизмы взаимодействия с пользователем на самых разных аппаратных платформах [6].
114