Материал: 1484
3.2.3. Основные методы и задачи Data Mining
Data Mining – это не один, а совокупность большого числа различных методов обнаружения знаний. Все задачи, решаемые методами Data Mining, можно условно разбить на пять классов:
1.Классификация – это установление зависимости дискретной выходной переменной от входных переменных.
2.Регрессия – это установление зависимости непрерывной выходной переменной от входных переменных.
3.Кластеризация – это группировка объектов (наблюдений, событий) на основе данных, описывающих свойства объектов. Объекты внутри кластера должны быть «похожими» друг на друга и отличаться от других, которые вошли в другие кластеры.
4.Ассоциация – выявление закономерностей между связанными событиями. Примеров такой закономерности служит правило, указывающее, что из события Х следует событие Y. Такие правила называются ассоциативными. Впервые эта задача была предложена для нахождения типичных шаблонов покупок, совершаемых в супермаркетах, поэтому иногда ее называют анализом рыночной корзины (market basket analysis).
5.Последовательные шаблоны – установление закономерно-
стей между связанными во времени событиями. Примером такой закономерности служит правило, указывающее, что из события Х спустя время t последует событие Y.
Можно говорить еще о задаче анализа отклонений – выявление наиболее нехарактерных шаблонов, например, при анализе мошеннических схем.
Классификация отличается от задачи регрессии тем, что в классификации на выходе присутствует переменная дискретного вида, называемая классом. Решение задачи классификации сводится к определению объекта по его входным характеристикам, при этом множество классов, к которым может быть отнесен объект, известно заранее. В задаче регрессии выходной переменной является непрерывное поле – множество действительных чисел, например, сумма продаж (рис. 7). К задаче регрессии сводится, в частности, прогнозирование временного ряда на основе исторических данных.
61
Вход 1 |
|
Класс |
|
||
|
Алгоритм |
«Плохой |
|
заемщик» |
|
….. |
классификации |
|
|
|
|
Вход N |
|
|
|
|
Вход 1  Сумма
Алгоритм продаж регрессии 
…..
Вход N
Рис. 7. Иллюстрация задачи регрессии
Кластеризация отличается от классификации тем, что выходная переменная не требуется, а число кластеров, в которое необходимо сгруппировать все множество данных, может быть неизвестным. Выходом кластеризации является не готовый ответ (например – плохо/удовлетворительно/хорошо), а группы похожих объектов – кластеров. Кластеризация указывает только на «схожесть» объектов и не более того, для объяснения образовавшихся кластеров необходима их дополнительная интерпретация (рис. 8).
Вход 1 |
|
Номер |
|
||
|
Алгоритм |
кластера |
|
|
|
…. |
кластеризации |
|
|
|
|
Вход N |
|
|
|
|
Рис. 8. Иллюстрация задачи кластеризации
Перечислим наиболее известные применения этих задач в экономике.
Классификация используется в случае, если заранее известны классы отнесения объектов, например отнесение нового товара к той или иной товарной группе, отнесение клиента к какой-либо катего-
62
рии. При кредитовании это отнесение клиента по каким-то признакам к одной из групп риска.
Кластеризация может использовать для сегментации и построения профилей клиентов. При достаточно большом количестве клиентов становится трудно подходить к каждому индивидуально, поэтому их удобно объединить в группы – сегменты с однородными признаками. Выделять сегменты по географическому расположению. После кластеризации можно узнать, какие именно сегменты являются наиболее активными, какие приносят наибольшую прибыль, выделить характерные для них признаки. Эффективность работы с клиентами повышается за счет учета их персональных предпочтений.
Регрессия используется для установления зависимостей в факторах. Например, в задаче прогнозирования зависимой величины являются объемы продаж, а факторами, влияющими на эту величину, могут быть предыдущие объемы продаж, изменение курса валют, активность конкурентов и т.д. Или, например, при кредитовании физических лиц вероятность возврата кредита зависит от личных характеристик человека, сферы его деятельности, наличия имущества.
Ассоциации помогают выявлять совместно приобретаемые товары. Это может быть полезно для более удобного размещения товара на прилавках, стимулирования продаж. Тогда человек, купивший пачку спагетти, не забудет купить к ней бутылочку соуса.
Последовательные шаблоны могут быть использованы при планировании продаж или предоставлении услуг. Они похожи на ассоциации, но в анализе добавляется временной показатель, т.е. важна последовательность совершения операций. Например, если заемщик взял потребительский кредит, то с вероятностью 60% через полгода он оформит кредитную карту.
Ассоциации и последовательные шаблоны иногда объединяют в одну задачу, называемую анализом связей (link analisys).
Для решения вышеперечисленных задач используются различные методы и алгоритмы Data Mining. Ввиду того, что Data Mining развивался и развивается на стыке таких дисциплин, как математика, статистика, теория информации, машинное обучение, теория баз данных, вполне закономерно, что большинство алгоритмов и методов Data Mining были разработаны на основе различных методов из этих дисциплин.
В общем случае не принципиально, каким именно алгоритмом будет решаться одна из пяти задач Data Mining, главное иметь метод
63
решения для каждого класса задач. На сегодня наиболее распространение в Data Mining получили методы машинного обучения: деревья решений, нейронные сети, ассоциативные правила и т.д.
Определение. Машинное обучение (англ.: Machine Learning) – обширный подраздел искусственного интеллекта, изучающий методы построения алгоритмов, способных обучаться на данных.
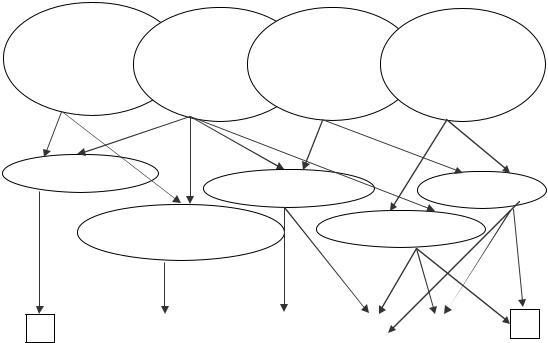
Общая постановка задачи обучения следующая. Имеется множество объектов (ситуаций) и множество возможных ответов (откликов, реакций). Существует некоторая зависимость между ответами и объектами, но она не известна. Известна только конечная совокупность прецедентов – пар вида «обьект-ответ», называемая обучающей выборкой. На основе этих данных требуется восстановить зависимость, т.е. построить модель, способную для любого объекта выдать достаточно точный ответ. Для измерения точности ответов определенным образом вводится критерий качества. Ниже приводится схема, которая иллюстрирует некоторые популярные бизнес-задачи, которые решаются алгоритмамиDM (рис. 9).
Бизнес-решения
|
Анализ событий |
|
Маркетинговая |
|
Анализ рисков |
|
Почтовые |
|
|
Анализ рыночной |
|||||||
|
сегментация |
|
Скоринг |
|
рассылки |
|||
|
корзины |
|
|
|||||
|
|
Профайлинг |
|
Прогнозирование |
|
Борьба с |
||
|
Стимулирование |
|||||||
|
Анализ аварий |
|
|
|
мошенничеством |
|||
|
спроса |
|
|
|
||||
|
|
|
|
|
|
Оптимизация |
||
|
|
|
|
|
|
Ассоциация
Кластеризация Регрессия
Последовательные |
Классификация |
шаблоны |
|
|
|
|
|
|
|
|
|
|
|
|
|
Анализ |
Сферическая |
Нейронные Деревья |
|||||||||
последовательностей |
кластеризация |
|
сети |
решений |
|||||||
Рис. 9. Схема, иллюстрирующая некоторые популярные бизнес-задачи, которые решаются алгоритмами DM
64
3.3. Технология KDD
Несмотря на большое количество разнообразных бизнес-задач почти все они могут решаться по единой методике. Эта методика, за-
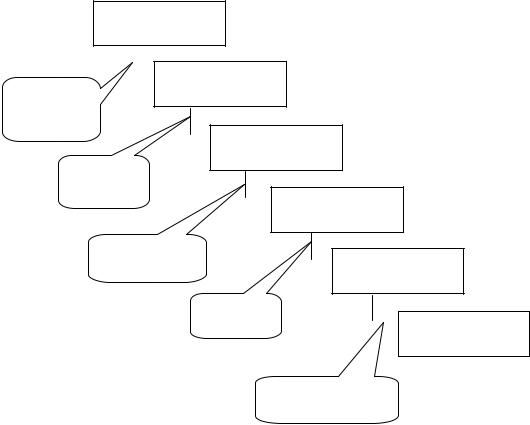
родившаяся в 1989 г., получила название Knowledge Discovery in Databases – извлечение знаний из баз данных. Она описывает не конкретный алгоритм или математический аппарат, а последовательность действий, которую необходимо выполнить для построения модели (извлечения знания). Методика не зависит от предметной области, это набор атомарных операций, и, комбинируя их, можно получить нужное решение. KDD включает в себя этапы подготовки данных, выбора информативных признаков, очистки, построения моделей, постобработки и позволяющие обнаруживать закономерности и знания (рис. 10).
Источники
данных
 Источники Выборка данных данных
 Источники
данных
Очистка
 Источники данных
Трансфор- мация  Источники
данных
Data
Mining  Источники данных
Интерпретация
Рис. 10. Этапы KDD
Определение. Knowledge Discovery in Databases (KDD) – это процесс получения из данных знаний в виде зависимостей, правил, моделей и состоящий, как правило, из следующих этапов: отбор, очи-
65