Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
алгоритмов, обеспечивающих значительное сжатие, продолжительность задержки может составлять около сотни миллисекунд, что вполне ощутимо при разговоре. К счастью, недавние достижения в области обработки цифровых сигналов (digital signal processing – DSP) и сверхбольших интегральных схем (very large scale integration – VLSI) сделали реализацию таких кодирующих устройств возможной и экономически эффективной.
Вторая важная проблема состоит в том, что сжатие речи, как правило, снижает качество звука. Известно, что больших степеней сжатия цифровой информации можно достичь только при использовании алгоритмов, не допускающих полного восстановления сжимаемой информации.
Наконец, в-третьих, чем выше степень сжатия информации, тем сложнее (и соответственно дороже) оборудование требуется для осуществления этой операции. По мере усовершенствования технической базы сжатия речи это ограничение теряет свою жесткость, однако появляются все новые, более сложные алгоритмы, потребляющие большие вычислительные мощности.
Сжатие речи называют также эффективным кодированием. Раньше, чем все остальные способы, для эффективного цифрового преобразования речи были разработаны вокодеры. Основываясь на выбранной модели речеобразования, вокодер с помощью алгоритма передачи анализирует параметры речевого сигнала, который поступает по каналу связи в приемник; приемный алгоритм позволяет проводить синтез сигнала. Осциллограммы исходного и синтезированного сигнала не совпадают, и речь может носить "искусственный" характер.
Значительные результаты в области эффективного кодирования речи достигнуты на базе общего подхода "кодирования с предсказанием". Большая часть стандартизированных Международным союзом электросвязи алгоритмов кодирования относится именно к этому направлению. Среди кодеров формы сигнала первыми появились методы дельта-модуляции (ДМ). Аналитически они являются предельными случаями разностной дифференциальной ИКМ, но по ряду причин могут быть выделены в отдельный класс. Скорость передачи при дельта-модуляции соответствует частоте дискретизации (одноразрядное квантование); при скоростях 40-30 кбит/с ДМ обеспечивает более высокое качество восстановления, чем ИКМ. Дельта-модуляция обладает наилучшими параметрами помехоустойчивости среди всех методов кодирования. Соответствующие системы не теряют работоспособности при возникновении одиночных ошибок и их пакетов (серий) малой длительности.
Еще один класс кодеров формы – методы дифференциальной (разностной) ИКМ (ДИКМ). Их классификационными признаками считаются наличие блока линейного предсказания авторегрессионных последовательностей (предсказателя) и использование многоуровневого (больше двух уровней) квантователя. Блок линейного предсказания может состоять из двух частей – долговременного и кратковременного предсказателей. В канал передается разность истинного и предсказанного значений сигнала (сигнал-остаток, он же – погрешность предсказания). Системы с ДИКМ обеспечивают такое качество
71
восстановления сигнала, которое сопоставимо с предоставляемым ИКМ качеством, и на порядок более высокую помехоустойчивость.
К достижениям в области кодирования речи можно отнести кодеры, реализующие алгоритмы анализа через синтез. Они сохраняют форму речевого сигнала (во всяком случае, к ним применима среднеквадратическая мера оценки восстановления – среднеквадратическая ошибка). В этих кодерах используются алгоритмы сжатия, основанные на оценке параметров модели речеобразования, которые прежде применялись исключительно в вокодерах.
Все описанные методы предполагают передачу большого количества параметров речевого сигнала и эквивалента сигнала-остатка (используемого разностной ИКМ), которые квантуются с разной точностью. Прежде оценка признака тон/шум считалась отличительной чертой вокодера, теперь же она осуществляется и в кодерах анализа через синтез, что стирает границы между кодерами формы и вокодерами (поэтому их иногда называют полу вокодерами).
Работа кодеков с многополосным кодированием МПК (SubBand Coder), основана на различной чувствительности слуха к звукам, принадлежащим к разным частотным полосам. Это позволяет кодировать сигналы в полосах с разной точностью. Число полос может колебаться от 3 до 16. В кодерах с ортогональным преобразованием скорость передачи снижается за счет грубого квантования спектральных составляющих, полученных разложением в ряд в каком-либо базисе. Особенностью помехоустойчивости систем, основанных на последних двух методах, является то, что благодаря различной точности кодирования в полосах отсутствует пороговый переход к области неработоспособности.
Появление методов с линейным предсказанием связано с совершенствованием кодеров формы, которое было предпринято для сохранения качества восстановленного речевого сигнала при менее высоких скоростях. В этих методах выявляется избыточность погрешности предсказания. В кодерах с линейным предсказанием и усеченным возбуждением ЛПУВ (RELP – Residual Excited Linear Prediction) сигнал погрешности ограничивается по частоте и прореживается. Кодеры с многоимпульсным возбуждением ЛПМВ (MPE – MultiPulse Excitation) используют вместо сигнала-остатка искусственную последовательность возбуждения речевого сигнала на некотором временном интервале, параметры которой передаются в декодер. Выбор фазы такой последовательности осуществляется с помощью интерактивной процедуры по критерию близости формы исходного и синтезированного сигналов. На основе этого метода разработан алгоритм кодека стандарта GSM для подвижной связи, реализующий скорость передачи 13,8 кбит/с.
В последнее время большую популярность приобрели кодеры CELP (Code Excited Linear Prediction), разновидностями которых являются SELP, LD – CELP, V
– CELP и A – CELP. Эти высокоэффективные кодеры обеспечивают отличное качество звука при низких скоростях (2,4-8 кбит/с). Для кодирования погрешности предсказания в них используются кодовые книги, состоящие из блоков с конечным числом символов. Перечисленные разновидности кодеров различаются способами формирования и хранения этих последовательностей.
72
Чаще всего последовательность хранится в сжатом виде. Дополнительные буквы в названии кодера (LD, V и др.) указывают на способ реализации предсказателя, синтеза квантователя или кодовой книги.
2.3.2 Особенности вокодерного кодирования
Вокодеры предназначены исключительно для кодирования речевого сигнала. При их построении максимально учитывают особенности образования речи и ее восприятия человеком. Форма восстановленного сигнала при этом может радикально отличаться от формы исходного сигнала.
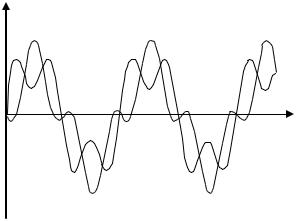
В качестве примера на рис. 2.21 приведены осциллограммы двух сигналов, внешне весьма различных. Тем не менее, при их воспроизведении человек не заметит разницы. Дело в том, что спектральный состав обоих сигналов одинаков: они являются суммой первой и третьей гармоник синусоиды. Различны лишь значения начальной фазы третьей гармоники. Органы же слуха человека не реагируют на фазовые соотношения.
U(t)
t
Рис. 2.21 Осциллограммы сигналов с различными фазами третьих гармоник
Задача различных способов получения цифрового сигнала ИКМ, ДИКМ, ДМ, – максимального точно передать информацию о форме сигнала. Именно поэтому эти методы кодирования называют кодированием формы.
Задача вокодерной обработки другая - обеспечить, чтобы восстановленный сигнал звучал как можно более сходно с исходным сигналом.
Принципиальное отличие вокодерного кодирования от кодирования формы состоит в том, что по каналу связи передают не сам сигнал, а параметры модели его образования. На приемном конце восстанавливаемый сигнал синтезируют.
Существует большое число идей построения вокодеров. По принципу определения параметров фильтровой функции речи различают вокодеры:
73
•полосные (канальные, channel);
•формантные;
•ортогональные;
•липредеры (с линейным предсказанием речи);
•гомоморфные.
Вполосных вокодерах спектр речи делится на 7 - 20 полос (каналов) аналоговыми или цифровыми полосовыми фильтрами. Большее число каналов в вокодере дает большую натуральность и разборчивость. С каждого полосового фильтра сигнал поступает на детектор и фильтр низких частот с частотой среза 25 Гц. Таким образом, сигналы на выходе каждого канала изменяются с частотой менее 25 Гц. Их передача возможна в аналог овом или цифровом виде. В формантных вокодерах огибающая спектра речи описывается комбинацией формант (резонансных частот голосового тракта). Основные параметры формант – центральная частота, амплитуда и ширина.
Вортогональных вокодерах огибающая мгновенного спектра раскладывается в ряд по выбранной системе ортогональных базисных функций. Вычисленные коэффициенты этого разложения передаются на приемную сторону. Распространение получили гармонические вокодеры, использующие разложение в ряд Фурье.
Вокодеры с линейным предсказанием (LPC – Linear Prediction Coding) или
липредеры основаны на оригинальном математическом аппарате.
Гомоморфная обработка позволяет разделить генераторную и фильтровую функции, образующие речевой сигнал.
Из-за сложности определения параметров генераторной функции появились полувокодеры (VEV – Voice Excited Vocoder), в которых вместо сигналов основного тона и тон-шума используете полоса речевого сигнала. Полоса частот до 800 – 1000 Гц кодируется АДИКМ, АДМ или с помощью линейного предсказания малого порядка, а в некоторых моделях передается в аналоговом виде.
Есть разные типы полувокодеров-липредеров:
•вокодеры VELP (Voice Excited Linear Prediction);
•вокодеры RELP (Residual Excited Linear Prediction).
Гомоморфная обработка разделяет речевой сигнал на генераторную и фильтровую функции. Для этого последовательность отсчетов речевого сигнала длиной около 40 мс взвешивается временным окном и подвергается прямому дискретному преобразованию Фурье (ДПФ). Затем находится логарифм модуля спектра, к нему применяется обратное ДПФ. Результат называется кепстром. По области 4 – 40 мс кепстра можно определить признак "тон-шум" и частоту основного тона. Если участок вокализованный, то в кепстре будет пик в точке, равной периоду основного тона.
В начале кепстра ( 0 – 4 мс) содержится информация об огибающей спектра речи. Чтобы ее получить, нужно обнулить в кепстре участок 4 – 40 мс и подвергнуть кепстр прямому ДПФ.
Вокодеры VELP используют голосовое возбуждение и коэффициенты линейного предсказания КЛП. В вокодерах RELP по исходному сигналу также
74
вычисляются КЛП. Так как КЛП описывает фильтровую функцию, то сигнал ошибки предсказания (сигнал-остаток предсказания, prediction residial) содержит информацию о генераторной функции речи. Он и передается на приемную сторону (возможно его сжатие АДИКМ, АДМ или с помощью линейного предсказания малого порядка).
В последнее время все шире используются липредеры с кодовым возбуждением (CELP – Code Excited Linear Prediction). Такие вокодеры имеют на приемном и передающем концах кодовую книгу (codebook). Кодовая книга – это матрица, строки которой являются последовательностями чисел (отсчетов сигналов генераторных функций, то есть это сигналы в озбуждения).
По исходному сигналу вычисляются КЛП. Затем, на фильтр с найденными КЛП подаются по очереди все сигналы возбуждения из кодовой книги. По каждому сигналу возбуждения синтезируется речь. На приемную сторону передаются КЛП и номер того сигнала из кодовой книги, для которого разница межд у исходным и синтезированным сигналом минимальна .
В таблице 2.3 приведены основные виды вокодеров и требуемая пропускная способность канала связи.
Сегодня вокодеры применяют для кодирования телефонных сигналов в военных и коммерческих цифровых системах связи. Перспективно применение вокодеров для организации служебной телефонной связи со скоростью передачи данных 1 200 - 2 400 бит/с. Формантные и полосные вокодеры находят применение также при цифровой передаче телефонных сигналов по КВ-каналам радиосвязи.
Таблица 2.3 Основные виды вокодеров
|
Полоса пропускания канала связи в режиме передачи |
|
Вид вокодера |
Аналоговом, Гц |
Цифровом, бит/с |
Фонемный |
– |
75 |
Формантный |
140 |
1200 |
Полосный ортогональный |
400 |
2400 |
Полувокодер |
900 |
9600 |
Современные вокодеры обеспечивают хорошее качество речи при скорости передачи 2400 - 4800 бит/с и качество речи, пригодное для ведения служебных переговоров, при скорости передачи 1200 бит/с.
В таблице 2.4 приведен краткий список вокодеров, которые производятся в настоящее время.
2.3.3 Процесс речеобразования
Рассмотрим особенности процесса речеобразования. При разговоре грудная клетка сжимается и расширяется, поток воздуха проходит из легких через трахею и гортань в полости глотки, рта и носа. Голосовой тракт
75