Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
4.3 Циклические коды
Большинство используемых на практике блочных кодов с коррекцией ошибок относятся к категории циклических. Для циклических кодов справедливо следующее: если n-битовая последовательность (c0 ,c1,...,cn 1)
является кодовым словом, то последовательность (cn 1,c0 ,c1,...,cn 2 ) полученная с
помощью циклического сдвига n-битовой последовательности с на одну позицию вправо, также используется в качестве кодового слова. Данный класс кодов можно легко кодировать и декодировать с использованием линейных регистров сдвига с обратной связью (Linear Feedback Shift Register — LFSR). Примерами циклических кодов являются коды Боуза-Чоудхури-Хоквенгема (БЧХ) и коды Рида-Соломона. I
Реализация циклического кодера как регистра LFSR подобна реализации приведенной на рис. 3.9 для кодов обнаружения ошибок. Основное отличие состоит в том, что вход кода CRC имеет произвольную длину и в результате получается контрольный код CRC фиксированной длины, тогда как циклический код с коррекцией ошибок генерирует контрольный код (п - k бит) на основе входной последовательности фиксированной длины (k бит). На рисунках 4.7 и 4.8 представлены реализации в виде LFSR кодера и декодера циклического блочного кода.
|
2 |
Xn-k |
|
Xn-k-1 |
|
X2 |
X1 |
X0 |
|
|
|
|
|
|
|
|
|
Вх |
П1 |
|
Tn-k-1 |
Tn-k-2 |
|
T1 |
|
T0 |
|
|
|
|
|
||||
|
1 |
|
|
|
|
|
|
|
|
|
П2 |
2 |
|
|
|
|
|
|
|
1 |
An-k-1 |
An-k-2 |
A1 |
|
A0 |
|
|
|
|
|
|||||
|
Вых |
|
|
|
|
|
|
|
|
|
|
Рис. 4.7 Структурная схема кодера циклического кода |
|
|
|||
Как и при проверке четности с избыточностью, конкретный циклический код можно представить полиномиальным делителем, именуемым порождающим многочленом (или генераторным полиномом). Для кода (п, k) порождающий многочлен можно записать в таком виде
n k |
1 |
|
|
P( X ) X n k |
A X i |
1, |
(4.12) |
|
i |
|
|
i 1 |
|
|
|
где каждый из коэффициентов Аi, может принимать значения 0 или 1, что соответствует двоичному разряду в делителе. Например, для Р = 11001
порождающий многочлен имеет вид P(X ) |
X 4 |
X 3 |
1. |
Порождающий полином циклического кода (n, k) является |
|||
множителем при разложении полинома |
X n |
1. |
Например, для кода с |
116 |
|
|
|
длиной кода |
n = 7 полином |
X 7 1 |
можно разложить на |
следующие |
сомножители |
|
|
|
|
|
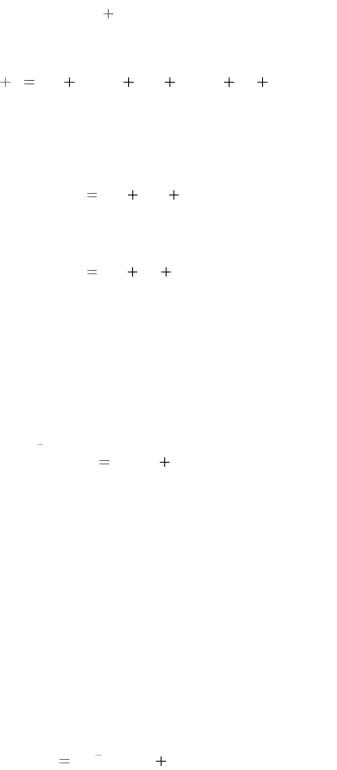
X 7 1 (X |
1)(X 3 |
X 2 1)(X 3 X 1). |
(4.13) |
Чтобы синтезировать циклический код (7, 4) можно использовать один из двух порождающих полиномов
P( X ) |
X 3 |
X 2 |
1 |
или |
|
|
(4.14) |
P( X ) |
X 3 |
X |
1. |
Аналогично представлению порождающего полинома последовательность битов данных можно представить полиномом D(Х), а контрольный код – полиномом R(Х) (см. обсуждение циклической проверки четности с избыточностью). Напомним, что контрольный код определяется следующим образом
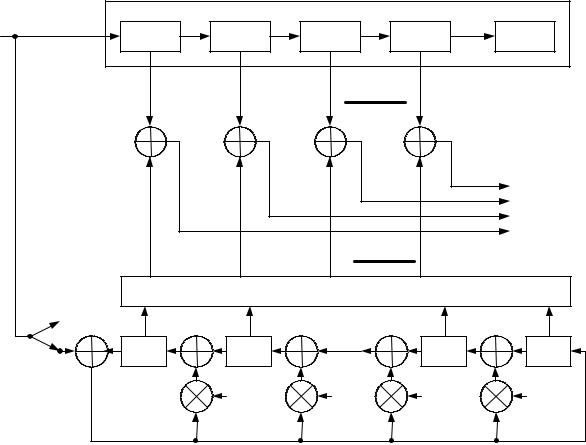
X n k D( X ) |
Q( X ) |
R(X ) |
(4.15) |
|
P(X ) |
P(X ) |
|||
|
|
Т.е. блок данных D(Х) сдвигается влево на (п – k) бит и делится на P(X). В результате получим частное Q(X) и остаток R(Х) длиной (п – k) бит.
Для проведения этой операции ключи П1 и П2 рисунок 4.7 находятся в положении 1 и на вход схемы деления поступают информационные символы D(Х), одновременно эти же символы поступают и на выход. После k тактов работы кодера в его регистре образуется остаток от деления R(Х). На (k+1) такте ключи П1 и П2 переключаются в положение 2 и символы остатка один за другим поступают на выход кодера.
Передаваемый на модулятор блок битов T(X) – это конкатенация D(Х) и
R(Х)
T (X ) X n k D(X ) R(X ). |
(4.16) |
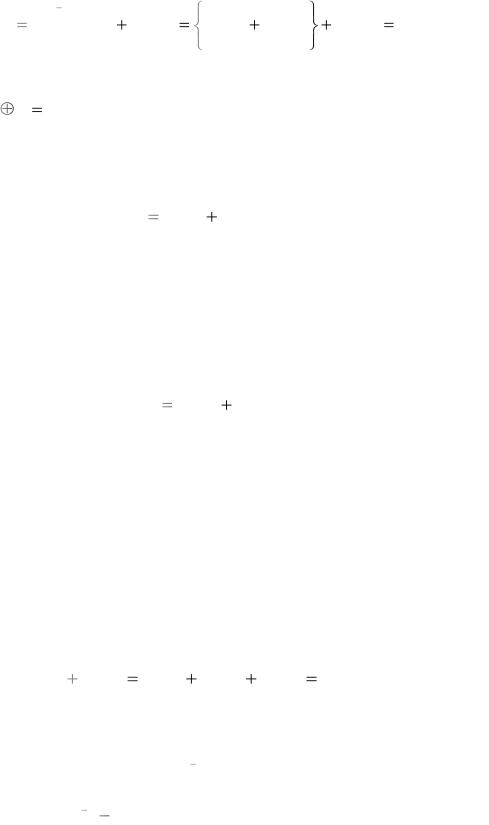
После прохождения канала передачи этот блок поступает на декодер циклического кода рисунок 4.8.
Для декодера входом являются полученные п бит T(X), которые содержат k бит данных D(X) за которыми следуют (п - k) контрольных битов R(X). Ключ П1 находится в положении 1 на время прохождения всех n бит входного блока T(X). При отсутствии ошибок после первых k тактов регистр сдвига порождающего многочлена будет содержать последовательность контрольных битов, идентичную переданной R(X).
117
После прохождения оставшихся (п - k) входных бит регистр сдвига порождающего многочлена будет содержать код-синдром. После прохождения всех n бит входного блока T(X) переключатель П1 переводится в положение 2.
Для декодирования циклического кода используется следующая процедура:
1.С помощью полученных битов вычисляется код-синдром. Вычисления проводятся аналогично тому, как кодер обрабатывает биты данных для получения контрольного кода;
2.Если все биты синдрома равны нулю — ошибки отсутствуют;
3.Если синдром отличен от нуля, производится дополнительная обработка для исправления ошибки.
Вход |
|
|
|
|
РС |
|
n |
бит |
T1 |
T2 |
T3 |
Tk |
Tn |
|
|
|||||
i1 |
i2 |
i3 |
ik |
Выход k бит |
|
|
e1 |
e2 |
e3 |
ek |
|
|
|
|
|
Корректирующая логика |
|
|
|
2 |
sn-k |
sn-k-1 |
s2 |
s1 |
|
|
|
|||||
П1 |
|
Tn-k-1 |
Tn-k-2 |
|
T1 |
T0 |
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
An-k-1 |
An-k-2 |
A1 |
A0 |
Рис. 4.8 Структурная схема декодера циклического кода
Значения синдромов можно понять, изучив блочный код с использованием полиномов.
При отсутствии ошибок передачи T(X) должно делиться на порождающий полином P(X) без остатка, что можно легко показать, используя формулы (3.24)
и (3.25)
118
T ( X ) |
|
X n k D( X ) |
|
R( X ) |
Q( X ) |
R( X ) |
|
R( X ) |
Q( X ). |
(4.17) |
P( X ) |
|
P( X ) |
|
P( X ) |
P( X ) |
|
P( X ) |
|||
|
|
|
|
|
|
Выражение (3.26) справедливо в соответствии с правилами арифметики по модулю 2 ( a a 0 ). Следовательно, если ошибки отсутствуют, T(X) делится на P(X) без остатка.
Если один или более бит являются ошибочными, полученный на приемной стороне блок бит Z(X) будет иметь вид
Z(X ) T (X ) E(X ), |
(4.18) |
где E(X) = (e1, e2, e3, … , en)– n – битовый полином ошибок, содержащий 1 в каждом двоичном разряде , где в Z(X) имеется ошибка. Если Z(X) проходит через регистр порождающего полинома, то фактически в нем производится деление Z(X)/P(X), что в результате дает синдром S(X) = (s1, s2,s3, …, sn-k) длиной
(n-k) бит
Z (X ) |
B( X ) |
S(X ) |
, |
(4.19) |
|
P( X ) |
P( X ) |
||||
|
|
|
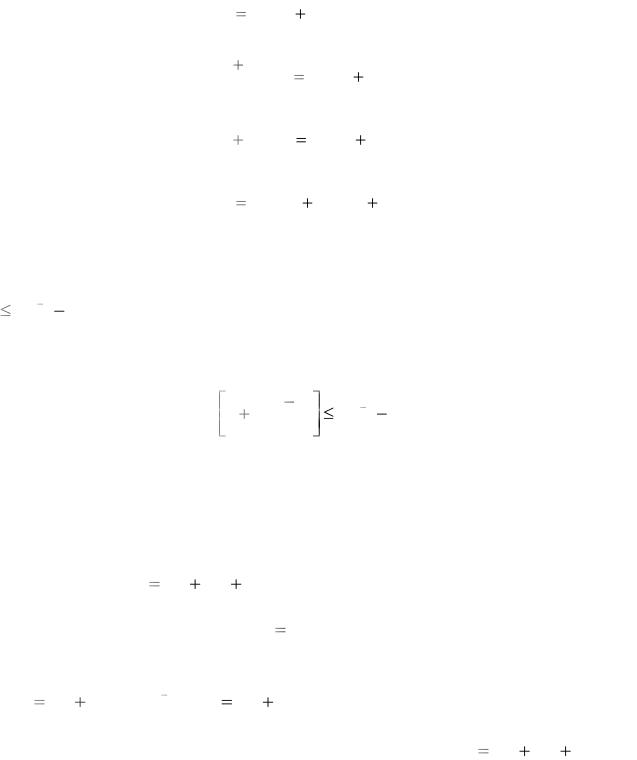
где B(X) – частное, S(X) – остаток деления. Следовательно, S(X) является функцией Z(X). Теперь определим, каким образом полученный результат можно использовать для исправления ошибок. Запишем уравнение (4.19) с учетом выражений (4.15) –(4.18) и получим выражение (4.20), из которого видно, что деление E(X)/P(X) дает тот же остаток, что и Z(X)/P(X). Таким образом, значение синдрома S(X) зависит только от ошибочных битов и не зависит от начальной последовательности битов (переданного значения T(X)). Если ошибочные биты E(X) можно получить из синдрома S(X), то ошибки в Z(X) можно исправить с помощью простого сложения
Z(X ) E(X ) T (X ) E(X ) E(X ) T (X ).
Поскольку S(X) зависит только от E(X), возможности блочного циклического кода определить очень легко. Синдром состоит из (n-k) бит, следовательно он может принимать 2n k возможных значений. Если все биты синдрома равны нулю, это указывает на отсутствие ошибок. Следовательно, всего можно исправить 2n k 1 различных ошибочных комбинаций.
119
Z ( X ) |
|
|
B( X ) |
S ( X ) |
, |
|
|
|
|
|
|
||
P( X ) |
P( X ) |
|
|
|
|
|
|
||||||
|
|
|
|
|
|
|
|
|
|
|
|
||
T ( X ) E( X ) |
|
B( X ) |
|
|
S ( X ) |
|
, |
|
|||||
P( X ) |
|
P( X ) |
|||||||||||
|
|
|
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
(4.20) |
|
Q( X ) |
|
|
E( X ) |
|
B( X ) |
|
|
S ( X ) |
, |
|
|||
|
|
P( X ) |
|
|
P( X ) |
||||||||
|
|
|
|
|
|
|
|
||||||
E( X ) |
|
|
Q( X ) |
B( X ) |
|
|
S ( X ) |
. |
|||||
|
|
|
|
|
|||||||||
P( X ) |
|
|
|
|
|
|
|
|
|
P( X ) |
|||
Чтобы с помощью блочного кода (n, k) можно было исправить все возможные однобитовые ошибки, должно выполняться неравенство n (2n k 1).
Исправление всех 1- и 2-битовых ошибок требует выполнения следующего неравенства
n |
n(n |
1) |
(2n k 1). |
(4.21) |
|
|
|||
2 |
|
|||
|
|
|
|
Способ получения E(X) из S(X) может зависеть от используемого кода. Наиболее простой подход – построить таблицу, которая ставила бы в соответствие значениям E(X) значения S(X). После этого потребуется простой способ выполнения поиска в этой таблице.
Пример. Рассмотрим блочный циклический код (7 ,4) с порождающим многочленом P(X ) X 3 X 2 1. В соответствии с (4.21) имеем 7 = 23 -1,
следовательно, с помощью этого кода можно исправить все однобитовые ошибки, что соответствует dmin 3. В таблице 4.4 а приведены все
используемые кодовые слова. |
|
|
|
|
|
||
Например, |
для |
блока |
данных |
1010 |
имеем |
||
D(X ) X 3 |
X и |
X n k D(X ) |
X 6 |
X 4. |
Деление |
выполняется |
согласно |
уравнению (4.17) и приведено на рисунке 4.9. |
|
|
|||||
Далее, |
используя уравнение |
(4.16) |
получаем |
T (X ) X 6 |
X 4 1, что |
||
соответствует кодовому слову 1010001.
Для коррекции ошибок требуется таблица синдромов, приведенная в таблице 4.4 б. Например, для последовательности ошибок 1000000 E(X) будет равно X 6 .
Используя последнюю строку уравнения (4.20) рассчитаем для данной одиночной ошибки еѐ синдром рисунок 4.10.
120