Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
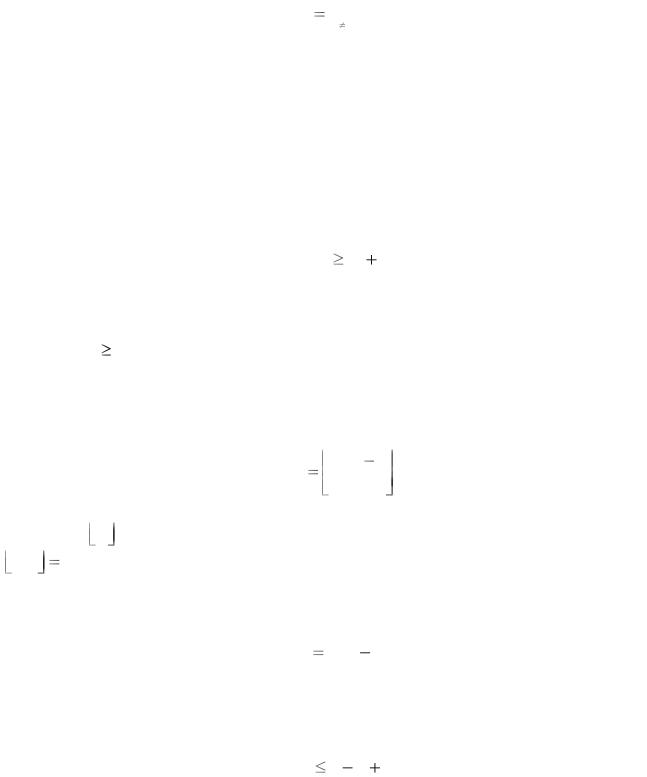
соответствует ни одному из кодовых слов, приемник обнаружил ошибку. Как можно ее исправить? Точно узнать какой из блоков данных был передан, невозможно, поскольку шум мог изменить 1, 2, 3, 4 или даже все 5 переданных блоков. Отметим, впрочем, что для преобразования приемлемого кодового слова 00000 в полученную последовательность достаточно изменения одного бита. Соответственно, для преобразования 00111 в 00100 нужно изменить два бита; 11110 в 00100 – три бита; 11001 в 00100 – четыре бита. Таким образом, можно сделать вывод, что с наибольшей вероятностью был передан блок 00000, т.е. искомый блок данных – 00. Подобное рассуждение и есть логика коррекции ошибки. Используя понятие «расстояние Хэмминга», его можно представить в следующем виде
d(00000, 00100) = 1 |
d(00111, 00100) = 2 |
d(11001, 00100) = 4 |
d(11110, 00100) = 3 |
Таким образом, искомое правило коррекции ошибок можно сформулировать так: если получено кодовое слово с ошибкой, его истинное значение принимается равным кодовому слову, которое находится на минимальном расстоянии Хэмминга от искаженного слова. Это правило применимо только тогда, когда для каждого ошибочного кодового слова имеется только одно реальное кодовое слово, находящееся от него на минимальном расстоянии Хэмминга. Для нашего примера приведенное условие не выполняется. Полное количество возможных последовательностей равно 25 = 32, из которых 4 используются как кодовые слова, а 28 являются ошибочными. Для ошибочных кодовых слов можно составить таблицу 4.1.
Из таблицы 4.1 следует, что в 8 случаях ошибочная последовательность находится на расстоянии 2 от различных существующих кодовых слов. Любая такая последовательность может возникнуть в результате двух битовых ошибок, и при этом приемник не может однозначно выбрать правильное кодовое слово. Таким образом, ошибка обнаруживается, но не исправляется. В то же время для всех 1-битовых ошибок полученная последовательность находится на расстоянии 1 только от одного правильного кодового слова, что позволяет принять правильное решение. Следовательно, данный код можно использовать для исправления всех 1-битовых ошибок, но в то же время он не позволяет исправлять ошибки в двух битах. Для иллюстрации сказанного рассмотрим расстояния между существующими (корректными) кодовыми словами
d(00000, 00111) = 3 |
d(00000, 11001) = 3 |
d(00000, 11110) = 4 |
d(00111, 11001) = 4 |
d(00111, 11110) = 3 |
d(11001, 11110) = 2 |
Минимальное расстояние между двумя правильными кодовыми словами равно 3. Следовательно, при появлении 1-битовой ошибки
106
расстояние между исходной и ошибочной последовательностями составит 1; а расстояние между ошибочной последовательностью и всеми прочими правильными кодовыми словами будет не менее 2. Таким образом, рассмотренный код позволяет всегда исправлять 1-битовые ошибки. Кроме того, будут обнаружены все 2-х битовые ошибки.
Таблица 4.1 Ошибочные кодовые слова
Ошибочное |
Минимальн |
Существующее |
Ошибочное |
Минимал |
Существующее |
кодовое |
ое |
кодовое слово |
кодовое |
ьное |
кодовое слово |
слово |
расстояние |
|
слово |
расстоян |
|
|
|
|
|
ие |
|
00001 |
1 |
00000 |
10000 |
1 |
00000 |
00010 |
1 |
00000 |
10001 |
1 |
11001 |
00011 |
1 |
00111 |
10010 |
2 |
00000 или |
|
|
|
|
|
11110 |
00100 |
1 |
00000 |
10011 |
2 |
00111 или |
|
|
|
|
|
11001 |
00101 |
1 |
00111 |
10100 |
2 |
00000 или |
|
|
|
|
|
11110 |
00110 |
1 |
00111 |
10101 |
2 |
00111 или |
|
|
|
|
|
11001 |
01000 |
1 |
00000 |
10110 |
1 |
11110 |
01001 |
1 |
11001 |
10111 |
1 |
00111 |
01010 |
2 |
00000 или |
11000 |
1 |
11001 |
|
|
11110 |
|
|
|
01011 |
2 |
00111 или |
11010 |
1 |
11110 |
|
|
11001 |
|
|
|
01100 |
2 |
00000 или |
11011 |
1 |
11001 |
|
|
11110 |
|
|
|
01101 |
2 |
00111 или |
11100 |
1 |
11110 |
|
|
11001 |
|
|
|
01110 |
1 |
11110 |
11101 |
1 |
11001 |
01111 |
1 |
00111 |
11111 |
1 |
11110 |
Приведенные выше примеры иллюстрируют важные свойства блочных кодов с коррекцией ошибок. Блочный код (п, k) преобразует k бит данных в п-битовые кодовые слова. В большинстве случаев каждое корректное кодовое слово – это исходные k бит данных плюс (n-k) контрольных битов. Таким образом, структура блочного кода эквивалентна структуре функции вида vс = f (vd), где vd – вектор, состоящий из k бит данных; vс – вектор, состоящий из п бит кодового слова.
В блочном коде (п, k) имеется 2k приемлемых кодовых слов из 2n возможных. Отношение числа избыточных битов к числу битов данных (п - k)/k принято называть избыточностью кода (code redundancy); отношение количества битов данных к полному числу битов R = (k/п) называют степенью кодирования или скоростью кода (code rate). Скорость кодирования это мера того, какая дополнительная полоса потребуется после кодирования, если скорость передачи данных мы хотим сохранить такой же, какая была до кодирования. Например, при степени кодирования R = 1/2 для сохранения скорости передачи данных системе потребуется полоса, в два раза большая, чем та, которая необходима для передачи некодированного сигнала. Для рассмотренного выше примера степень
107
кодирования равна 2/5, следовательно, для сохранения скорости передачи потребуется увеличить ширину полосы в 2,5 раза. Т.е. если скорость передачи сигнала на входе кодера равна 1 Мбит/с, то для сохранения прежних параметров скорость выходного сигнала должна быть равна 2,5 Мбит/с.
Для кода, состоящего из кодовых слов w1, w2,…, ws, где s = 2n, минимальное расстояние кода dmin определяется следующим образом
dmin |
min[d(wi , wj ]. |
(4.1) |
|
i j |
|
Можно показать, что если для кода выполняется неравенство dmin > 2t + 1 (t – некоторое положительное целое число), то с помощью данного кода можно исправить все символы, содержащие до t ошибочных битов, включительно. Если dmin > 2t , то можно исправить все символы, содержащие до (t - 1) ошибочных битов. Кроме того, будут обнаружены все символы с t ошибочными битами, исправить которые, в общем случае нельзя. Верно и обратное утверждение — каждый код, позволяющий исправлять до t ошибочных битов, должен удовлетворять условию
dmin |
2t 1. |
(4.2) |
Для каждого кода, позволяющего исправлять до (t-1) ошибочных |
||
битов и обнаруживать все символы с t |
ошибками, |
должно выполняться |
условие dmin 2t.
Связь между dmin и t можно записать другим способом, выразив максимальное количество битовых ошибок в кодовом слове, гарантированно исправляемых кодом в таком виде
t |
dmin |
1 |
, |
(4.3) |
2 |
|
|||
|
|
|
|
где x – наибольшее целое число, не превышающее х (например,
6,3 6). Более того, если нас интересует только обнаружение ошибок, но
не их исправление, количество обнаруживаемых ошибок t удовлетворяет следующему равенству:
t dmin 1. |
(4.4) |
Простая верхняя граница для минимального расстояния по Хэммингу dmin двоичного или недвоичного линейного блочного кода (n, k) согласно [20]
dmin n k 1. |
(4. 5 ) |
108 |
|
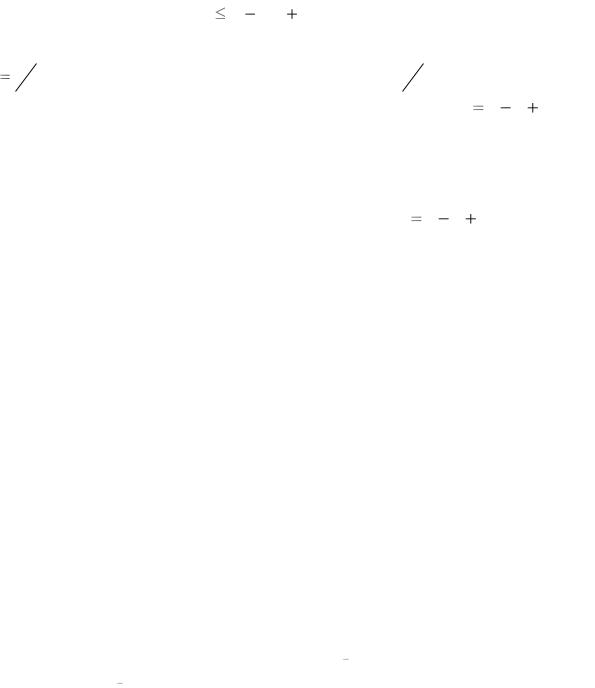
Удобно нормировать выражение (4.4) через длину блока п. Это даѐт
|
|
|
|
dmin |
(1 Rc ) |
1 |
, |
|
(4.6) |
|
|
|
|
|
n |
|
n |
|
|||
|
|
|
|
|
|
|
|
|
||
где R |
k |
n |
– скорость кода. Для больших п слагаемым |
1 |
можно пренебречь. |
|||||
c |
|
|
|
|
|
|
|
n |
|
|
|
|
|
|
|
|
|
|
|
|
|
Если |
код |
имеет наибольшее возможное |
расстояние, |
т.е. |
dmin n k 1 его |
|||||
называют разделимым кодом с максимальным расстоянием. Исключая случаи тривиального кода (п, 1) для передачи двоичных сообщений с повторением, не существует двоичных разделимых кодов с максимальным расстоянием. Фактически верхняя граница в (3.19) для двоичных кодов весьма неточная. С другой стороны, существуют недвоичные коды с dmin n k 1. Например,
коды Рида-Соломона, которые представляют подкласс БЧХ кодов, являются разделимыми кодами с максимальным расстоянием.
Задаваясь |
линейным двоичным кодом (п, k) |
с минимальным |
расстоянием dmin |
мы можем синтезировать линейный двоичный код (n + 1, k) |
|
путѐм добавления одного дополнительного проверочного символа к каждому кодовому слову Проверочный символ обычно выбирается так, чтобы быть проверочным символом по всем символам кодового слова. Таким образом, добавляемый проверочный символ равен 0, если исходное кодовое слово имеет чѐтное число единиц, и равен 1, если кодовое слово имеет нечетное число единиц. Следовательно, если минимальное расстояние кода dmin нечѐтно,
добавляемый проверочный символ увеличит минимальное расстояние на 1. Код
(п +1, k) называется расширенным кодом.
Систематический (п, k) код может быть также укорочен размещением в начале информационного блока нулевых символов. Это значит, что линейный код (п, k), состоящий из k информационных символов и (n-k) проверочных может быть укорочен до линейного кода (n – l, k-l), если установить первые l информационных символов (во всех кодовых комбинациях) нулями. Эти l символов не передаются по каналу, а (п –k) проверочных символа рассчитываются обычным образом, как в исходном коде.
Укороченный код (n – l, k-l) состоит из 2k l кодовых слов. Минимальное расстояние этих 2k l кодовых слов по крайней мере не меньше, чем минимальное расстояние исходного (п, k) кода.
Теперь рассмотрим конкретные примеры кодов с коррекцией ошибок.
4.2 Коды Хэмминга
Коды Хэмминга – это семейство блочных кодов с коррекцией одиночных ошибок, которые характеризуются следующими параметрами:
109
Длина блока |
n |
2r |
1; |
Количество битов данных |
k |
2r |
r 1; |
|
|
|
(4.7) |
Количество контрольных битов r |
n |
k; |
|
Минимальное расстояние |
dmin |
3. |
|
Для кодов Хэмминга r  3. Согласно (4.7) существуют коды Хэмминга при r = 3 – (7,4), r = 4 – (15,11), r = 5 – (31,11) и т.д.
Коды Хэмминга просты в использовании и легко поддаются анализу, поэтому рассмотрим этот тип кодов, чтобы, проиллюстрировать на их примере некоторые фундаментальные принципы работы блочных кодов.
Коды Хэмминга созданы для исправления 1-битовых ошибок. Для начала определим необходимую длину кода. Коды Хэмминга реализуются так же, как методы обнаружения ошибок (см. рис. 3.2) – в процессе кодирования сохраняются k бит данных и добавляются r = (n-k) контрольных битов. При декодировании используются две последовательности из r = (n-k) бит, одна из которых является кодовым словом входящего сигнала, а другая рассчитывается на основе полученных битов данных Последовательности побитно сравниваются с помощью логического исключающего ИЛИ. Результат сравнения называют синдромом. Биту синдрома присваивается значение 0, если биты двух последовательностей совпадают, и 1 – в противном случае. Синдром – это r = (n-k) – битовое слово в диапазоне от 0 до 2(n-k) - 1. Значение 0 свидетельствует об отсутствии ошибки. Если же ошибка присутствует, ее местоположение определяется из синдрома.
Для удобства генерируемый синдром должен обладать следующими свойствами:
•Если синдром состоит только из нулей — ошибки не обнаружены;
•Если один и только один бит синдрома равен 1 — ошибка присутствует в одном из контрольных битов; в этом случае исправлять ошибку не нужно;
•Если синдром содержит более одного бита со значением 1, он является указателем на положение ошибки в слове, для исправления которой указанный бит инвертируется.
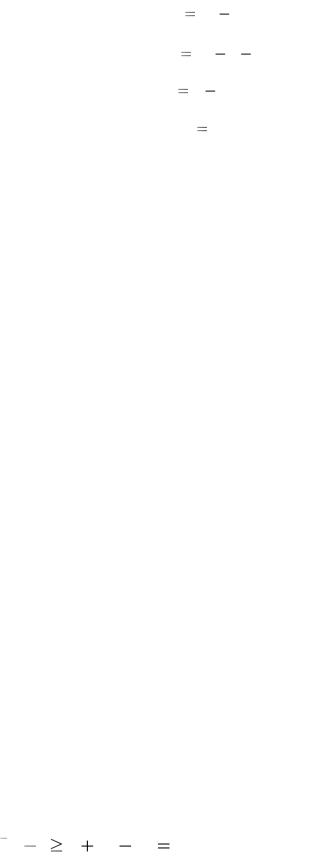
Поскольку ошибочным может быть любой из k бит данных или r = (n-k) проверочных битов, должно выполняться следующее соотношение
2(n k ) |
1 k (n k) n. |
(4.8) |
Приведенное уравнение определяет количество битов, необходимое для исправления 1-битовой ошибки в слове, содержащем k бит данных.
Из (4.8) следует
110