Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
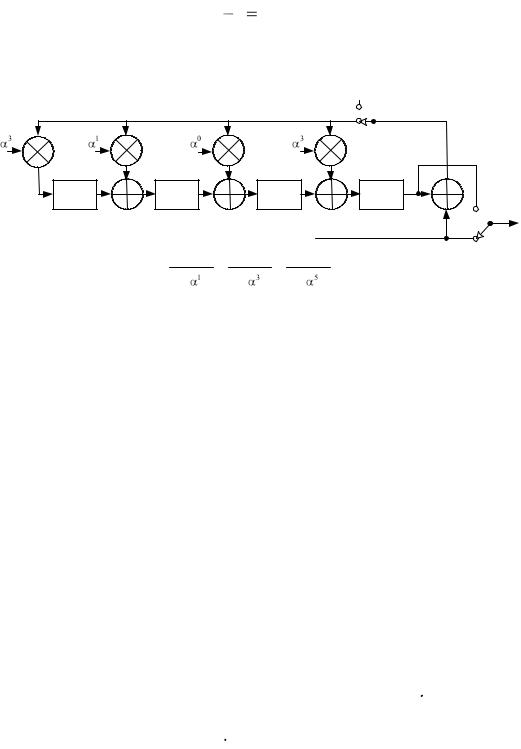
Как показано на рисунке 4.15, кодирование последовательности из 3-х символов в систематической форме на основе кода Рида-Соломона (7, 3), определяемого генератором Р(X) из уравнения (4.40), требует реализации регистра сдвига с обратными связями (LFSR). Нетрудно убедиться, что элементы умножителя на рис. 4.15, взятые справа налево, соответствуют коэффициентам полинома в уравнении (4.40). Этот процесс кодирования является недвоичным аналогом циклического кодирования, которое описывалось выше. Здесь, в соответствии с алгоритмом кодирования для кода Рида-Соломона ненулевые
кодовые слова образованы 2m |
1 |
7 символами, |
и каждый символ состоит из т |
|
= 3 бит. |
|
|
|
|
X0 |
X1 |
X2 |
X3 2 |
X4 |
|
|
|
1 |
П1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
2 |
Выходная |
|
|
|
|
|
|
|
|
|
П2 последователь |
Входная последовательность символов сообщения |
|
|
ность кодовых |
||||||
|
1 |
символов |
|||||||
|
|
|
|
|
|
|
|
||
0 |
1 |
0 |
0 |
1 |
0 |
0 |
1 |
0 |
|
Рис. 4.15 Кодер для кода (7, 3) Рида-Соломона
Следует отметить сходство между рисунками 4.15 и 4.7. В том и другом случаях количество разрядов в регистре равно п - k. Рисунок 4.7 для циклического кодирования отображает пример двоичного кодирования, где каждый разряд содержит 1 бит. В данном разделе приведен пример недвоичного кодирования, так что каждый разряд регистра сдвига, изображенного на рис. 4.15, содержит 3-битовый символ. На рис. 4.7 коэффициенты, обозначенные А1, А2, ..., являются двоичными. Поэтому они принимают одно из значений 0 или 1, просто указывая на наличие или отсутствие связи в LFSR. На рис. 4.15 каждый коэффициент является 3- битовым, так что они могут принимать одно из 8 значений.
Недвоичные операции, осуществляемые кодером, показанным на рис, 4.15, создают кодовые слова в систематической форме, так же как и в двоичном случае.
Эти операции определяются следующими шагами:
1.Переключатель 1 в течение первых k m тактовых импульсов находится в положении 1, для того чтобы подавать символы сообщения в (n - k) m-разрядный регистр сдвига;
136
2.В течение первых k m тактовых импульсов переключатель 2 находится в положении 1, что обеспечивает одновременную передачу всех символов сообщения непосредственно на регистр выхода (на рис. 3.19 не показан);
3.После передачи k - го символа на регистр выхода, переключатели 1 и 2, переходят в положение 2;
4.Остальные (n - k) m тактовых импульсов очищают контрольные символы, содержащиеся в регистре, подавая их на регистр выхода;
5.Общее число тактовых импульсов равно n m, и содержимое регистра
выхода является полиномом кодового слова R(X ) X n k D(X ) , где
R(X) представляет собой кодовые символы, а D(Х) – символы сообщения в полиномиальной форме.
Для проверки возьмем ту же последовательность символов, что и в выражении (3.53).
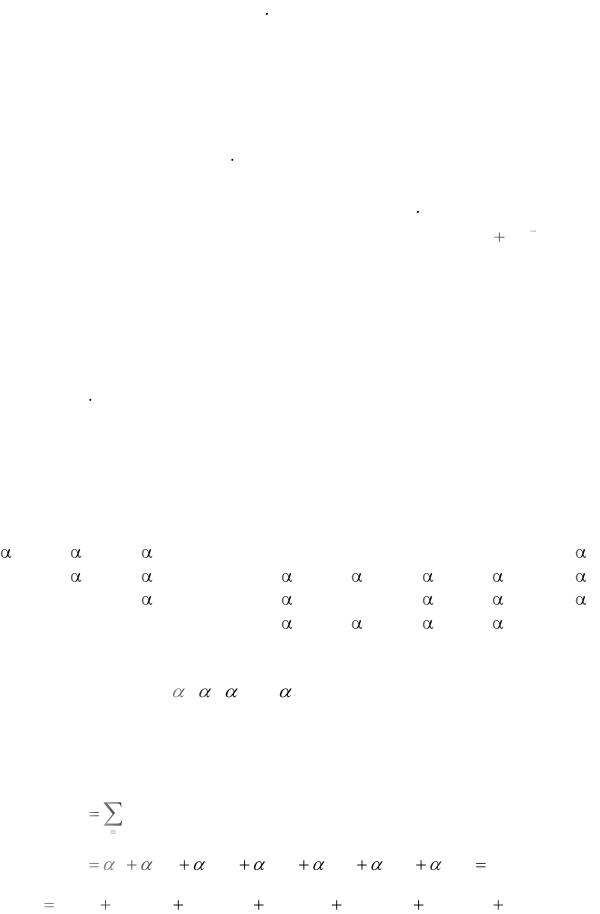
Здесь крайний правый символ является самым первым и крайний правый бит также является самым первым. Последовательность действий в течение первых k = 3 m тактовых сдвигов в цепи кодирования на рис. 4.15 будет иметь вид, представленный в таблице 4.10.
Таблица 4.10 Последовательность действий в кодере, представленном на рисунке 4.15
|
Очередь ввода |
|
|
Такт |
|
|
Содержимое регистра |
|
Обратная |
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
связь |
1 |
|
3 |
|
5 |
|
0 |
|
0 |
|
0 |
0 |
|
0 |
5 |
|
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1 |
|
3 |
|
1 |
|
1 |
|
6 |
5 |
|
1 |
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1 |
|
2 |
|
3 |
|
0 |
2 |
|
2 |
4 |
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
– |
|
3 |
|
0 |
|
2 |
4 |
|
6 |
– |
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|||||
|
Как можно видеть, после третьего такта регистр содержит четыре |
|||||||||||||
контрольных символа, |
0 , 2 , 4 и |
6. Затем переключатели 1 и 2 переходят в |
||||||||||||
положение 2, и контрольные символы, содержащиеся в регистре, подаются на выход. Поэтому выходное кодовое слово, записанное в полиномиальной форме, можно представить в следующем виде:
|
6 |
X n , |
|
|
|
|
T ( X ) |
t |
|
|
|
|
|
|
n |
|
|
|
|
|
|
n 0 |
|
|
|
|
|
T ( X ) |
0 |
2 X |
4 X 2 |
6 X 3 1 X 4 3 X 5 |
5 X 6 |
(4.47) |
(100) |
(001) X |
(011) X 2 |
(101) X 3 (010) X 4 |
(110) X 5 |
(111) X 6. |
|
137
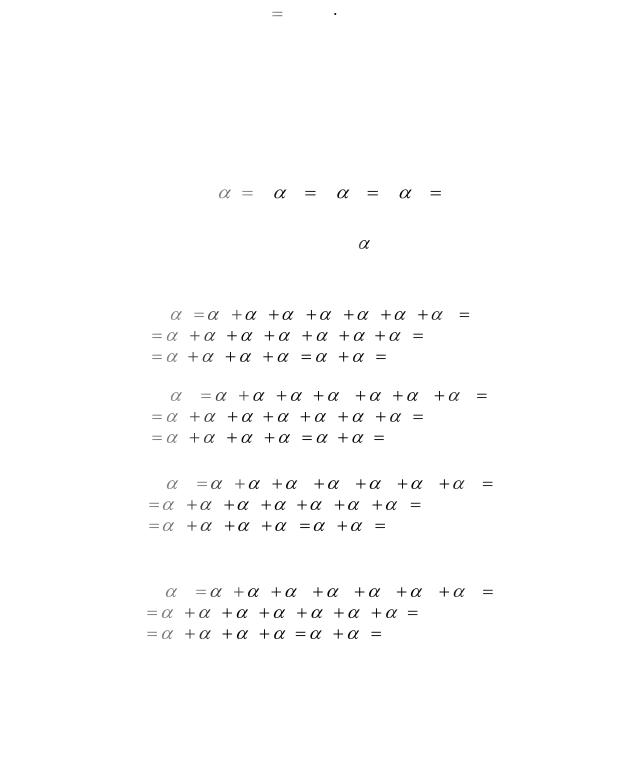
Процесс проверки содержимого регистра во время разных тактов несколько сложнее, чем в случае бинарного кодирования. Здесь сложение и умножение элементов поля должны выполняться согласно табл. 4.8 и 4.9.
Корни полиномиального генератора Р(X) должны быть и корнями кодового слова, генерируемого Р(X), поскольку правильное кодовое слово имеет следующий вид:
T (X ) D(X ) P(X ). |
(4.48) |
Следовательно, произвольное кодовое слово, выражаемое через корень генератора Р(X), должно давать нуль. Представляется интересным, действительно ли полином кодового слова в уравнении (4.47) дает нуль, когда он выражается через какой-либо из четырех корней Р(X). Иными словами, это означает проверку следующего:
T( ) T( 2 ) T( 3 ) |
T( 4 ) 0. |
(4.49) |
Подставим в (4.47) вместо Х значения |
i из (4.49) и независимо выполнив |
|
вычисления для разных корней с учетом таблиц 4.8 и 4.9 , получим следующее
T ( |
) |
0 |
3 |
6 |
9 |
5 |
|
8 |
11 |
|
|
|
|
|
|
|
|
||
|
0 |
3 |
6 |
2 |
5 |
1 |
|
4 |
|
|
1 |
0 |
6 |
4 |
3 |
3 |
0. |
|
|
|
|
|
|
|
|
|
|
||
T ( 2 ) |
0 |
4 |
8 |
12 |
|
9 |
13 |
17 |
|
|
0 |
4 |
1 |
5 |
2 |
6 |
|
3 |
|
|
5 |
6 |
0 |
3 |
1 |
1 |
0. |
|
|
|
|
|
|
|
|
|
|
||
T ( |
3 ) |
0 |
5 |
10 |
15 |
|
13 |
18 |
23 |
|
0 |
5 |
3 |
1 |
6 |
4 |
|
2 |
|
|
4 |
0 |
3 |
2 |
5 |
5 |
0. |
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
T ( |
4 ) |
0 |
6 |
12 |
18 |
|
17 |
23 |
29 |
|
0 |
6 |
5 |
4 |
3 |
2 |
|
1 |
|
|
2 |
0 |
5 |
1 |
6 |
6 |
0. |
|
|
|
|
|
|
|
|
|
|
||
Эти вычисления показывают, что, как и ожидалось, кодовое слово, выражаемое через любой корень генератора Р(X), должно давать нуль.
4.6.3 Декодирование Рида-Соломона
138
В предыдущем разделе тестовое сообщение кодируется в систематической форме с помощью кода Рида-Соломона (7,3), что дает в результате полином кодового слова, описываемый уравнением (3.56). Допустим, что в ходе передачи это кодовое слово подверглось искажению: 2 символа были приняты с ошибкой. (Такое количество ошибок соответствует максимальной способности кода к коррекции ошибок.) При использовании 7- символьного кодового слова модель ошибки можно представить в полиномиальной форме следующим образом
|
6 |
|
|
E( X ) |
E X n . |
(4.50) |
|
|
|
n |
|
|
n 0 |
|
|
Пусть двухсимвольная ошибка будет такой, что |
|
||
E( X ) 0 0X 0X 2 2 X 3 |
5 X 4 |
0X 5 0X 6 |
|
|
|
|
(4.51) |
(000) (000) X (000) X 2 (001) X 3 |
(111) X 4 (000) X 5 |
(000) X 6. |
|
Другими словами, один контрольный символ искажен 1-битовой ошибкой (представленной как 2 ), а один символ сообщения – 3-битовой ошибкой (представленной как 5). В данном случае принятый полином поврежденного кодового слова Z(Х) представляется в виде суммы полинома переданного кодового слова и полинома модели ошибки
Z(X ) T (X ) E(X ). |
(4.52) |
Следуя уравнению (4.52), мы суммируем Т(X) из уравнения (4.47) и Е(Х) из уравнения (4.51) и имеем следующее
Z ( X ) (100) |
(001) X |
(011) X 2 |
(100) X 3 |
(101) X 4 (110) X 5 (111) X 6 |
|
|
|
|
(4.53) |
0 |
2 X 4 X 2 |
0 X 3 |
6 X 4 |
3 X 5 5 X 6. |
В данном примере исправления 2-символьной ошибки (т.е. исправления ошибок в двух символах) имеется четыре неизвестных – два относятся к расположению ошибки, а два касаются ошибочных значений. Отметим важное различие между недвоичным декодированием Z(Х), которое представлено в уравнении (4.53), и двоичным. При двоичном декодировании декодеру нужно знать лишь расположение ошибки. Если известно, где находится ошибка, бит нужно поменять с 1 на 0 или наоборот. Но здесь недвоичные символы требуют, чтобы мы не только узнали расположение ошибки, но и определили правильное значение символа, расположенного на этой позиции. Поскольку в данном
139
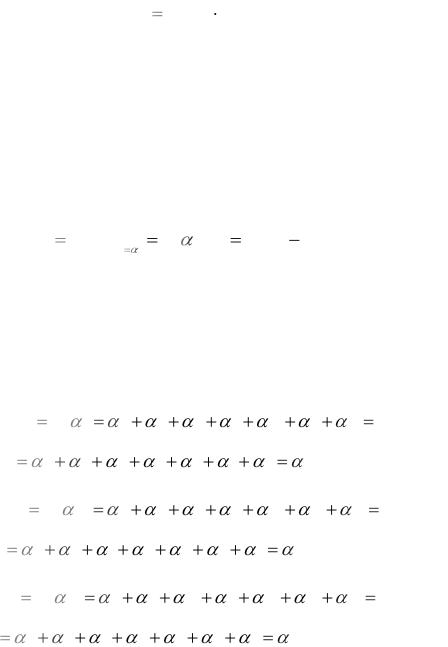
примере у нас имеется четыре неизвестных, нам нужно четыре уравнения, чтобы найти их.
Вычисление синдрома.
Напомним, что синдром – это результат проверки четности, выполняемой над Z, чтобы определить, принадлежит ли Z набору кодовых слов. Если Z является членом набора, то синдром S имеет значение, равное 0. Любое ненулевое значение S означает наличие ошибок. Точно так же, как и в двоичном случае, синдром S состоит из n - k символов, {Si,} (i = 1, ..., n - k). Таким образом, для нашего кода (7, 3) имеется по четыре символа в каждом векторе синдрома; их значения можно рассчитать из принятого полинома Z(Х). Заметим, как облегчаются вычисления благодаря самой структуре кода, определяемой уравнением (4.48).
T (X ) D(X ) P(X ). |
(4.54) |
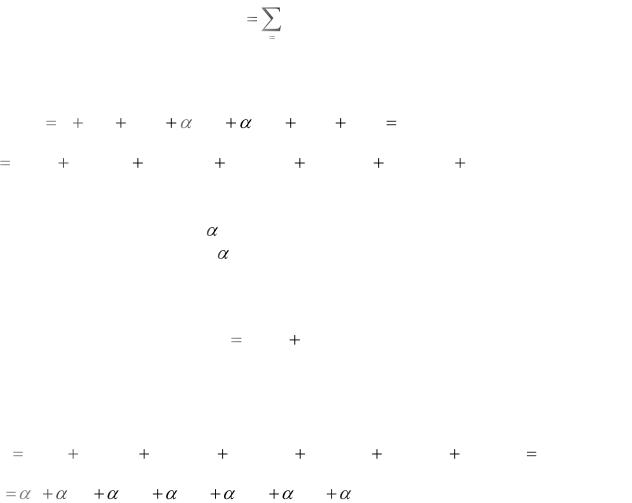
Из этой структуры можно видеть, что каждый правильный полином кодового слова T(X) является кратным полиномиальному генератору P(X). Следовательно, корни P(X) также должны быть корнями T(X). Поскольку Z(Х) = T(X) + E(Х), то Z(Х), вычисляемый с каждым корнем P(X), должен давать нуль, только если Z(Х) будет правильным кодовым словом. Любые ошибки приведут в итоге к ненулевому результату в одном (или более) случае. Вычисления символов синдрома можно записать следующим образом
S Z(X ) |
|
|
i Z( i ), i 1,...,n k. |
(4.55) |
|
|
|||
i |
|
X |
|
|
|
|
|
В рассматриваемом примере, как было показано в уравнении (4.53), Z(Х) содержит 2-символьные ошибки. Если Z(Х) окажется правильным кодовым словом, то это приведет к тому, что все символы синдрома Si, будут равны нулю. В данном примере четыре символа синдрома находятся следующим образом
|
|
S1 |
Z ( ) |
0 |
3 |
6 |
3 |
10 |
8 |
11 |
|
|
|
|
|
|
|
|
|
(4.56) |
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
3 |
6 |
3 |
3 |
1 |
4 |
3 , |
|
S |
2 |
Z ( 2 ) |
0 |
4 |
8 |
6 |
14 |
13 |
17 |
||
|
|
|
|
|
|
|
|
|
|
(4.57) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
4 |
1 |
6 |
0 |
6 |
3 |
5 , |
|
S |
3 |
|
Z ( |
3 ) |
0 |
5 |
10 |
9 |
18 |
18 |
23 |
|
|
|
|
|
|
|
|
|
|
(4.58) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
|
5 |
3 |
2 |
4 |
4 |
2 |
6 , |
|
140