Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
Требования к памяти декодера, работающего согласно алгоритму Витерби, растут с увеличением длины кодового ограничения как степенная функция.
Z: |
11 |
|
01 |
01 |
10 |
01 |
|
t1 |
t2 |
t3 |
t4 |
t5 |
t6 |
a = 00 |
2 |
2 |
1 |
|
|
|
|
|
0 |
|
1 |
b = 10 |
0 |
|
3 |
3 |
1 |
3 |
1 |
1 |
1 |
1 |
1 |
1 |
3 |
1 |
1 |
1 |
1 |
2 |
1 |
1 |
|
2 |
|
1 |
2
2 |
0 |
2 |
c = 01 |
2 |
0 |
3 |
0 |
2 |
0 |
|
2 |
|
||
|
|
|
|
0
0 |
2 |
0 |
d = 11 |
|
|
0 |
2 |
2 |
1 |
|
|
2 |
0 |
|
2 |
|
|
|
|
|
|||
Декодированные |
1 |
1 |
0 |
1 |
|
1 |
выходные данные |
|
|||||
|
|
|
|
|
|
Метрика ветви
Г
Метрика пути
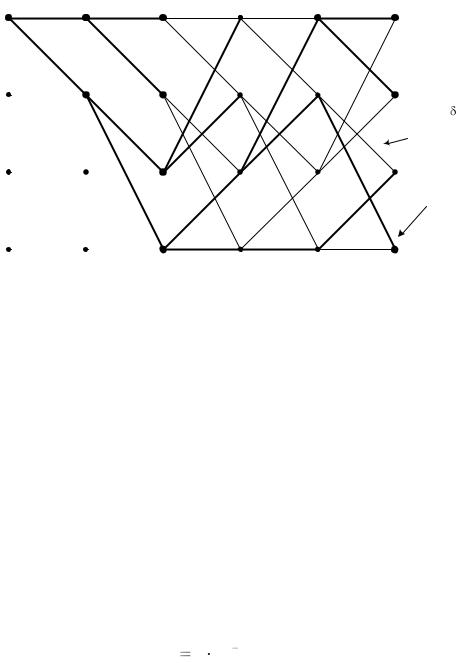
Рис. 5.13 Операции сложения, сравнения и выбора при декодировании по алгоритму Витерби
Для кода со степенью кодирования 1/n после каждого шага декодирования декодер держит в памяти набор из 2K-1 путей. С высокой степенью вероятности можно утверждать, что при значительном превышении существующей на данный момент глубины декодирования эти пути не будут взаимно непересекающимися [18, 20]. Все 2К-1 пути ведут к полной ветви, которая, в конце концов, разветвляется на разные состояния. Поэтому, если декодер сохраняет историю 2К-1 путей, самые первые биты на всех путях будут одинаковы. Следовательно, простой декодер имеет фиксированный объем истории путей и выдает самые ранние биты произвольного пути каждый раз, когда продвигается на один уровень вглубь решетки. Требуемый объем сохраняемых путей будет равен
u h 2K 1. |
(5.11) |
Здесь h — длина истории пути информационного бита на состояние. При уточнении, которое проводится для минимизации h, вместо самых ранних битов произвольных путей на выходе декодера используются самые ранние биты наиболее вероятных путей. Было показано [18], что значения h, равного 4 или 5 длинам кодового ограничения, достаточно, чтобы характеристики декодера были близки к оптимальным. Необходимый объем памяти и является основным ограничением при разработке декодеров, работающих
176
согласно алгоритму Витерби. В серийно выпускаемых декодерах длина кодового ограничения равна величине порядка К= 10. Попытка повысить эффективность кодирования за счет увеличения длины кодового ограничения вызывает экспоненциальный рост требований к памяти (и сложности), как это следует из уравнения (5.11).
Синхронизация кодовых слов ветвей – это процесс определения начала слова ветви в принятой последовательности. Такую синхронизацию можно осуществить, не прибавляя новую информацию к потоку передаваемых символов, поскольку можно видеть, что, пока принятые данные не синхронизированы, у них непомерно высокая частота появления ошибок. Следовательно, синхронизацию можно осуществить просто: нужно проводить сопутствующее наблюдение за уровнем частоты появления ошибок, т.е. нас должна интересовать частота, при которой увеличиваются метрики состояний, или частота, при которой сливаются выжившие пути на решетке. Параметр, за которым следят, сравнивается с пороговым значением, после чего соответствующим образом осуществляется синхронизация.
5.9 Свойства сверточных кодов
5.9.1 Пространственные характеристики сверточных кодов
Рассмотрим пространственные характеристики сверточных кодов в контексте простого кодера (рис. 5.2, а) и его решетчатой диаграммы (рис. 5.6). Мы хотим узнать расстояния между всеми возможными парами последовательностей кодовых слов. Как и в случае блочных кодов (см. раздел 4), нас интересует минимальное расстояние между всеми такими парами последовательностей кодовых слов в коде, поскольку минимальное расстояние связано с возможностями коррекции ошибок кода. Поскольку сверточный код является групповым или линейным, можно без потери общности просто найти минимальное расстояние между последовательностью кодовых слов и нулевой последовательностью. Другими словами, для линейного кода данное контрольное сообщение окажется точно таким же "хорошим", как и любое другое. Так почему бы не взять то сообщение, которое легко проследить, а именно нулевую последовательность? Допустим, что на вход передана нулевая последовательность; следовательно, нас интересует такой путь, который начинается и заканчивается в состоянии 00 и не возвращается к состоянию 00 нигде внутри пути. Всякий раз, когда расстояние любых других путей, которые сливаются с состоянием а = 00 в момент ti, окажется меньше расстояния нулевого пути, вплоть до момента ti, будет появляться ошибка, вызывая в процессе декодирования отбрасывание нулевого пути. Иными словами, при нулевой передаче ошибка возникает всегда, когда не выживает нулевой путь.
Следовательно, ошибка, о которой идет речь, связана с выживающим путем, который расходится, а затем снова сливается с нулевым путем. Может возникнуть вопрос, зачем нужно, чтобы пути сливались? Не будет ли для
177
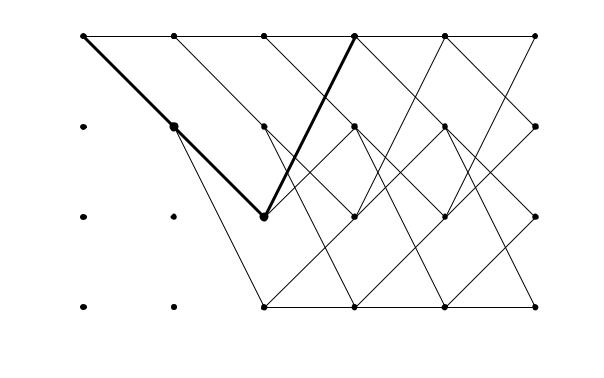
обнаружения ошибки достаточно лишь того, чтобы пути расходились? В принципе, достаточно, но если ошибка характеризуется только расхождением, то декодер, начиная с этой точки, будет выдавать вместо оставшегося сообщения сплошной "мусор". Мы хотим выразить возможности декодера через число обычно появляющихся ошибок, т.е. хотим узнать "самый легкий" для декодера способ сделать ошибку. Минимальное расстояние для такой ошибки можно найти, полностью изучив все пути из состояния 00 в состояние 00. Итак, давайте сначала заново начертим решетчатую диаграмму, как показано на рис. 5.14, и обозначим каждую ветвь не символом кодового слова, а ее расстоянием Хэмминга от нулевого кодового слова. Расстояние Хэмминга между двумя последовательностями разной длины можно получить путем их сравнивания, т.е. прибавив к началу более короткой последовательности нужное количество нулей. Рассмотрим все пути, которые расходятся из нулевого пути и затем в какой-то момент снова сливаются в произвольном узле. Из диаграммы на рис. 5.14 можно получить расстояние этих путей до нулевого пути. Итак, на расстоянии 5 от нулевого пути имеется один путь; этот путь отходит от нулевого в момент t1 и сливается с ним в момент t4. Точно так же имеется два пути с расстоянием 6, один отходит в момент t1 и сливается в момент t5, а другой отходит в момент t1 и сливается в момент t6 и т.д. Также можно видеть (по пунктирным и сплошным линиям на диаграмме), что входными битами для расстояния 5 будут 100; от нулевой входной последовательности эта последовательность отличается только одним битом. Точно так же входные биты для путей с расстоянием 6 будут 1100 и 10100; каждая из этих последовательностей отличается от нулевого пути в двух местах, минимальная длина пути из числа расходящихся, а затем сливающихся путей называется минимальным свободным расстоянием (minimum free distance), или просто свободным расстоянием (free distance).
Его можно видеть на рис. 5.14, где он показан жирной линией. Для оценки возможностей кода по коррекции ошибок, мы повторно приведем уравнение из раздела 4 с заменой минимального расстояния dmin на свободное расстояние df
t |
d f |
1 |
. |
(5.12) |
2 |
|
|||
|
|
|
|
|
Здесь x означает наибольшее целое, |
не большее х. Положив df = 5, можно |
|||
видеть, что код, описываемый кодером на рис. 5.2,а может исправить две любые ошибки канала.
Решетчатая диаграмма представляет собой "правила игры". Она является как бы символическим описанием всех возможных переходов и соответствующих начальных и конечных состояний, ассоциируемых с конкретным конечным автоматом. Эта диаграмма позволяет взглянуть глубже на выгоды (эффективность кодирования), которые дает применение кодирования с коррекцией ошибок, Взглянем на рис. 5.14 и на возможные ошибочные расхождения и слияния путей. Из рисунка видно, что декодер не может сделать ошибку произвольным образом. Ошибочный путь должен
178
следовать одному из возможных переходов. Решетка позволяет нам определить все такие доступные пути. Получив по этому пути кодированные данные, мы можем наложить ограничения на переданный сигнал.
Состояние
t1
a = 00
0 |
t2 |
0 |
t3 |
0 |
t4 |
0 |
t5 |
0 |
t6 |
2 |
2 |
2 |
2 |
2 |
b = 10 |
2 |
|
2 |
|
2 |
|
|
0 |
|
0 |
|
0 |
|
|
|
|
|
|||
1 |
|
|
|
|
|
|
|
|
1 |
|
1 |
|
1 |
c = 01 |
|
|
|
|
|
|
1 |
1 |
1 |
1 |
1 |
1 |
1 |
d = 11 |
1 |
|
1 |
|
1 |
|
|
|
|
|
Рис. 5.14 Решетчатая диаграмма с обозначенными расстояниями от нулевого пути
Если декодер знает об этих ограничениях, то это позволяет ему более просто (используя меньшее отношение сигнал/шум) удовлетворять требованиям надежной безошибочной работы.
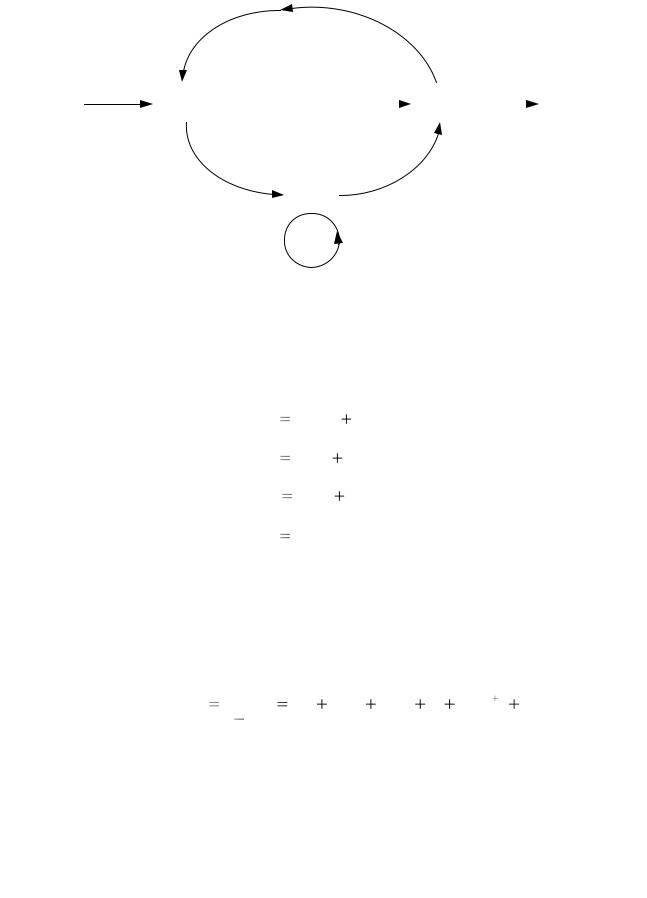
Хотя на рис. 5.14 представлен способ прямого вычисления свободного расстояния, для него можно получить более строгое аналитическое выражение, воспользовавшись для этого диаграммой состояний, изображенной на рис. 5.4. Для начала обозначим ветви диаграммы состояний как D0= 1, D1 или D2, как это показано на рис. 5.15, где показатель D означает расстояние Хэмминга между кодовым словом этой ветви и нулевой ветвью. Петлю в узле а можно убрать, поскольку она не дает никакого вклада в пространственные характеристики последовательности кодовых слов относительно нулевой последовательности. Более того, узел а можно разбить на два узла (обозначим их а и е), один из них представляет вход, а другой – выход диаграммы состояний.
Все пути, начинающиеся из состояния а = 00 и заканчивающиеся в состоянии е = 00, можно проследить на модифицированной диаграмме состояний, показанной на рис. 5.15. Передаточную функцию пути abce (который начинается и заканчивается в состоянии 00) можно рассчитать через неопределенный "заполнитель" D как D2DD2 = D5. Степень D – общее число единиц на пути, а значит, расстояние Хэмминга до нулевого пути. Точно так же пути abdсе и аbсbсе имеют передаточную функцию D6 и, соответственно, расстояние Хэмминга, равное 6, до нулевого пути.
179
00
D
a = 00 |
11 |
b = 10 |
|
10 |
|
|
c = 01 |
11 |
|
e = 00 |
D2 |
|
D |
|
|
D2 |
|||||
|
|
|
|
|
|
|
||||
|
|
D 01 |
|
01 D |
|
|
|
|||
|
|
|
|
d = 11 |
|
|
|
|
|
|
|
|
10 |
|
D |
|
|
|
|||
|
|
|
|
|
|
|||||
Рис. 5.15 Диаграмма состояний с обозначенными расстояниями до нулевого пути
Теперь уравнения состояния можем записать следующим образом
X |
b |
D2 X |
a |
X |
, |
|
|
c |
|
X c DXb DX d ,
(5.13)
X d DXb DX d ,
X |
e |
D2 X |
. |
|
c |
|
Здесь Ха ,..., Хе являются фиктивными переменными неполных путей между промежуточными узлами. Передаточную функцию кода, T(D), которую иногда называют производящей функцией кода, можно записать как T(D) = Xc / Xa. Решение уравнений состояния (5.13) имеет следующий вид
|
|
D5 |
|
|
|
|
T (D) |
|
|
D5 |
2D6 |
4D7 ... 2l Dl 5 ... |
(5.14) |
|
|
|||||
1 |
2D |
|
|
|
||
Передаточная функция этого кода показывает, что имеется один путь с расстоянием 5 до нулевого вектора, два пути – с расстоянием 6, четыре – с расстоянием 7. В общем случае существуют 2l пути с расстоянием l + 5 до нулевого вектора, причем l = 0, 1, 2, ... . Свободное расстояние df кода является весовым коэффициентом Хэмминга слагаемого, имеющего наименьший порядок в разложении T(D). В данном случае df = 5. Для оценки пространственных характеристик при большой длине кодового ограничения
180