Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
декодирования Витерби, поскольку при декодировании Витерби мягкое принятие решений лишь незначительно усложняет вычисления.
Двоичный симметричный канал.
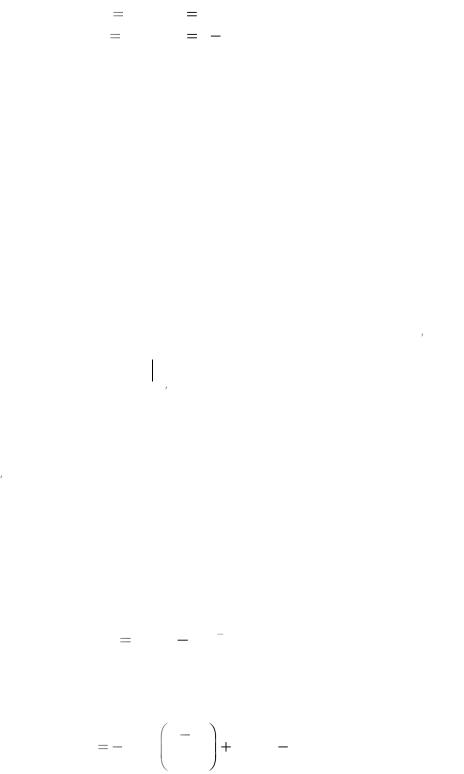
Двоичный симметричный канал (binary symmetric channel – BSC) – это дискретный канал без памяти, имеющий на входе и выходе двоичный алфавит и симметричные вероятности перехода. Как показано на рис. 5.8, его можно описать с помощью условных вероятностей
P(0 |
1) |
P(1 |
0) |
p, |
(5.6) |
|
P(1 |
|
1) |
P(0 |
0) |
1 p. |
|
|
|
|||||
|
|
|
|
|
|
|
Вероятность того, что выходной символ будет отличаться от входного, равна р, а вероятность того, что выходной символ будет идентичен входному, равна (1 -
р). Канал BSC является примером канала с жесткой схемой принятия решений,
это, в свою очередь, означает, что даже если демодулятор получил сигнал с непрерывным значением, BSC позволяет принять только какое-то одно определенное решение, так что каждый символ zji на выходе демодулятора содержит одно из двух двоичных значений. Индексы величины zji указывают на j-й кодовый символ i-го кодового слова Zi . Далее демодулятор передает последовательность Z = {Zi} на декодер.
Пусть U(m) – это переданное по каналу BSC кодовое слово с вероятностью появления ошибочного символа p, Z – соответствующая последовательность, полученная декодером. Как отмечалось ранее, декодер, работающий по принципу максимального правдоподобия, выбирает кодовое слово U (m ) , имеющее максимальное правдоподобие P(Z U (m) ) или его логарифм. Для BSC
это эквивалентно выбору кодового слова U (m ) , находящегося на наименьшем расстоянии Хэмминга от Z. Расстояние Хэмминга – это удобная метрика для описания расстояния или степени сходства между U(m) и Z. Из всех возможных
переданных |
последовательностей |
U(m) |
декодер |
выбирает |
такую |
последовательность U (m ) для которой |
расстояние |
до Z минимально. |
|||
Предположим, что каждая из последовательностей U(m) и Z имеет длину L бит и отличается на dm позиций (т.е. расстояние Хэмминга между U(m) и Z равно dm). Тогда, поскольку предполагалось, что канал не имеет памяти, вероятность того, что U(m) преобразовалось в Z, находящееся на расстоянии dm от U(m) , может быть записана в следующем виде
P(Z |
|
U (m) ) pdm (1 p)L dm . |
(5.7) |
|
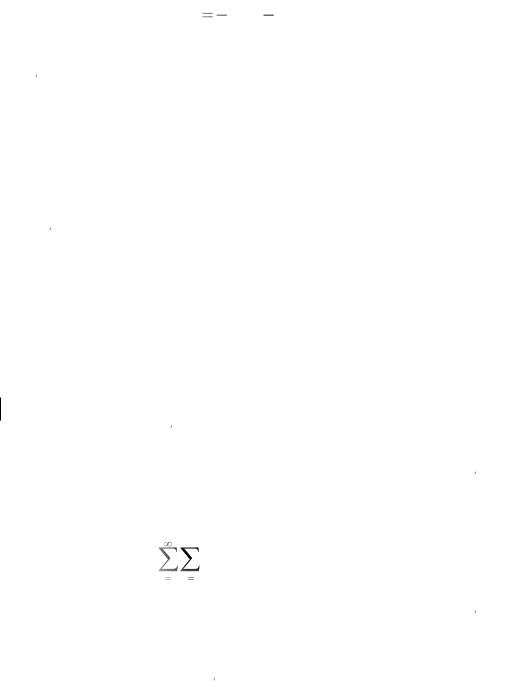
Логарифмическая функция правдоподобия будет иметь следующий вид:
lg P(Z |
|
U (m) ) dm lg |
1 p |
L lg(1 p). |
(5.8) |
|
|||||
|
p |
||||
166 |
|
|
|||
|
|
|
|||
Если вычислить эту величину для каждой возможно переданной последовательности, последнее слагаемое в уравнении будет постоянным для всех случаев. Если предположить, что p < 0,5, уравнение (5.8) можно записать в следующей форме
lg P(Z |
|
U (m) ) Ad |
m |
B. |
(5.9) |
|
|||||
|
|
|
|
|
Здесь А и В — положительные константы. Следовательно, такой выбор кодового слова , чтобы расстояние Хэмминга до полученной последовательности Z было минимальным, соответствует максимизации метрики правдоподобия или логарифма правдоподобия. Следовательно, в
канале BSC метрика логарифма правдоподобия легко заменяется расстоянием Хэмминга, а декодер, работающий по принципу максимального правдоподобия, будет выбирать на древовидной или решетчатой диаграмме путь, соответствующий минимальному расстоянию Хэмминга между последовательностью U (m ) и полученной последовательностью Z.
Гауссов канал.
Для гауссова канала каждый выходной символ демодулятора zji принимает значения из непрерывного алфавита. Символ zji нельзя пометить для детектирования как правильное или неправильное решение. Передачу на декодер таких мягких решений можно рассматривать как поступление семейства условных вероятностей различных символов. Можно показать [18], что
максимизация P(Z U (m) ) эквивалентна максимизации скалярного произведения
последовательности кодовых слов U (m ) (состоящей из двоичных символов, представленных как биполярные значения) и аналогового значения полученной последовательности Z, Таким образом, декодер выбирает кодовое слово U (m ) , если выражение
n |
|
|
(m) |
|
z |
ji |
u |
(5.10) |
|
|
|
ji |
|
i 1 j 1
имеет максимальное значение. Это эквивалентно выбору кодового слова U (m ) , находящегося на ближайшем евклидовом расстоянии от Z. Даже, несмотря на то, что каналы с жестким и мягким принятием решений требуют различных метрик,
концепция выбора кодового слова U (m ) , ближайшего к полученной |
последовательности Z, одинакова для обоих случаев. Чтобы в уравнении (5.10) |
точно выполнить максимизацию, декодер должен осуществлять арифметические операции с аналоговыми величинами. Это непрактично, поскольку обычно декодеры являются цифровыми. Таким образом, необходимо дискретизировать полученные символы zj i . Уравнение (5.10) является дискретным вариантом корреляции входного полученного сигнала приемника
167
r(t) с опорным сигналом si(t). Квантованный гауссов канал, обычно называемый каналом с мягкой схемой решений, – это модель канала, в которой предполагается, что декодирование осуществляется на основе описанной ранее мягкой схемы принятия решения.
5.6 Алгоритм сверточного декодирования Витерби
В 1967 году Витерби разработал и проанализировал алгоритм [18, 20], в котором, по сути, реализуется декодирование, основанное на принципе максимального правдоподобия; однако в нем уменьшается вычислительная нагрузка за счет использования особенностей структуры конкретной решетки кода. Преимущество декодирования Витерби, по сравнению с декодированием по методу "грубой силы", заключается в том, что сложность декодера Витерби не является функцией количества символов в последовательности кодовых слов. Алгоритм включает в себя вычисление меры подобия (или расстояния), между сигналом, полученным в момент времени ti и всеми путями решетки, входящими в каждое состояние в момент времени ti. В алгоритме Витерби не рассматриваются те пути решетки, которые, согласно принципу максимального правдоподобия, заведомо не могут быть оптимальными. Если в одно и то же состояние входят два пути, выбирается тот, который имеет лучшую метрику; такой путь называется выживающим. Отбор выживающих путей выполняется для каждого состояния. Таким образом, декодер углубляется в решетку, принимая решения путем исключения менее вероятных путей. Предварительный отказ от маловероятных путей упрощает процесс декодирования. Отметим, что задачу отбора оптимальных путей можно выразить как выбор кодового слова с максимальной метрикой правдоподобия или минимальной метрикой расстояния.
5.6.1 Пример сверточного декодирования Витерби
Для простоты предположим, что мы имеем дело с каналом BSC; в таком случае приемлемой мерой расстояния будет расстояние Хэмминга. Кодер для этого примера показан на рис. 5.2 а, а решетчатая диаграмма – на рис. 5.6. Для представления декодера, как показано на рис. 5.8, можно воспользоваться подобной решеткой.
Работа декодера начинается в момент времени t1 в состоянии 00 (вследствие очистки кодера между сообщениями декодер находится в начальном состоянии). Поскольку в этом примере возможны только два перехода, разрешающих другое состояние, для начала не нужно показывать все ветви. Полная решетчатая структура образуется после момента времени t1. Принцип работы происходящего после процедуры декодирования можно понять, изучив решетку кодера на рис. 5.6 и решетку декодера, показанную на рис. 5.8. Для решетки декодера каждую ветвь за каждый временной интервал удобно пометить расстоянием Хэмминга между полученным
168
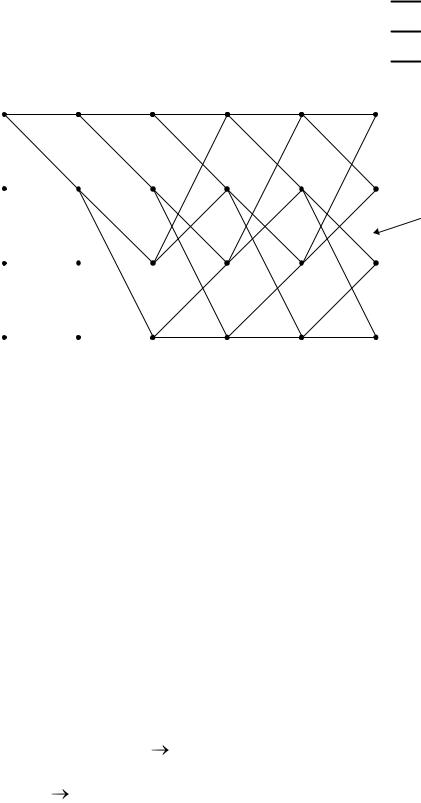
кодовым символом и кодовым словом, соответствующим той же ветви из решетки кодера.
Входная |
m |
1 |
1 |
0 |
1 |
1 |
|
последовательность |
|||||||
|
|
|
|
|
|
||
Переданные |
U |
11 |
01 |
01 |
00 |
01 |
|
кодовые слова |
|||||||
|
|
|
|
|
|
||
Принятая |
Z |
11 |
01 |
01 |
10 |
01 |
|
последовательность |
|||||||
|
|
|
|
|
|
Состояние |
t1 |
a = 00 |
2 |
t2 |
1 |
t3 |
1 |
t4 |
1 |
t5 |
1 |
t6 |
0 |
1 |
1 |
1 |
1 |
b = 10 |
1 |
|
1 |
|
1 |
|
|
1 |
|
1 |
1 |
Метрика |
|
|
|
|
||||
2 |
|
|
|
|
|
ветви |
|
|
|
|
|
|
|
|
|
2 |
|
0 |
2 |
|
c = 01 |
|
|
|
|
|
|
0 |
0 |
0 |
2 |
2 |
0 |
0 |
d = 11 |
2 |
|
0 |
|
2 |
|
|
|
|
|
|||
Рис. 5.8 Решетчатая диаграмма декодера сверточного кода (2, 1, 3)
На рис. 5.8 показана последовательность кодовых слов U, и искаженная шумом последовательность Z= 11 01 01 10 01 ... . Как показано на рис. 5.2 а, кодер характеризуется кодовыми словами, находящимися на ветвях решетки кодера и заведомо известными как кодеру, так и декодеру. Эти слова являются кодовыми символами, которые можно было бы ожидать на выходе кодера в результате каждого перехода между состояниями. Пометки на ветвях решетки декодера накапливаются декодером в процессе. Другими словами, когда получен кодовый символ, каждая ветвь решетки декодера помечается метрикой подобия (расстоянием Хэмминга) между полученным кодовым символом и каждым словом ветви за этот временной интервал. Из полученной последовательности Z, показанной на рис. 5.8, можно видеть, что кодовые символы, полученные в (следующий) момент времени t1 – это 11. Чтобы пометить ветви декодера подходящей метрикой расстояния Хэмминга в (прошедший) момент времени t1 рассмотрим решетку кодера на рис. 5.6. Видим, что переход между состояниями 00 00 порождает на выходе ветви слово 00. Однако получено 11. Следовательно, на решетке декодера помечаем переход между состояниями 00 00 расстоянием Хэмминга между ними, а именно 2.
Глядя вновь на решетку кодера, видим, что переход между состояниями 00  10 порождает на выходе кодовое слово 11, точно соответствующее полученному
в момент t1 кодовому символу.
169
Следовательно, переход на решетке декодера между состояниями 00 10 помечаем расстоянием Хэмминга 0. В итоге, метрика входящих в решетку декодера ветвей описывает разницу (расстояние) между тем, что было получено, и тем, что "могло бы быть" получено, имея кодовые слова, связанные с теми ветвями, с которых они были переданы. По сути, эти метрики описывают величину, подобную корреляциям между полученным кодовым словом и каждым из кандидатов на роль кодового слова. Таким же образом продолжаем помечать ветви решетки декодера по мере получения символов в каждый момент времени ti. В алгоритме декодирования эти метрики расстояния Хэмминга используются для нахождения наиболее вероятного (с минимальным расстоянием) пути через решетку.
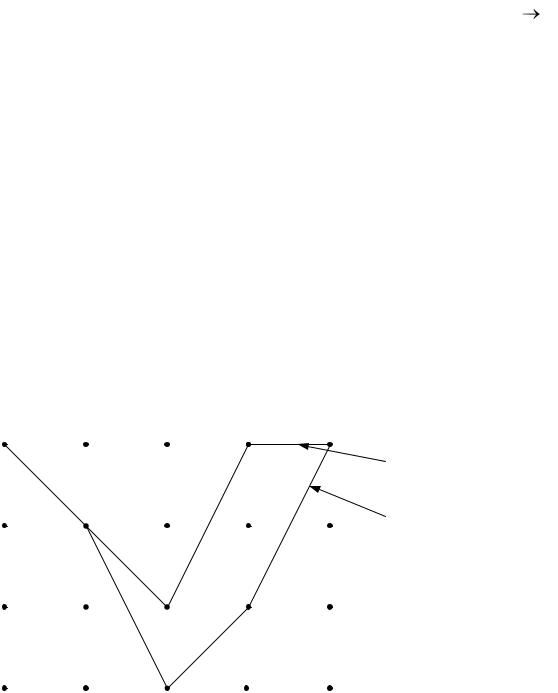
Смысл декодирования Витерби заключается в следующем. Если любые два пути сливаются в одном состоянии, то при поиске оптимального пути один из них всегда можно исключить Например, на рис. 5.9 показано два пути, сливающихся в момент времени t5 в состоянии 00.
Определим суммарную метрику пути по Хэммингу для данного пути в момент времени ti, как сумму метрик расстояний Хэмминга ветвей, по которым проходит путь до момента ti .
Состояние |
|
|
|
|
|
t1 |
t2 |
t3 |
t4 |
1 |
t5 |
a = 00 |
|
|
|
|
|
|
0 |
|
|
|
Метрика пути = 4 |
|
|
|
|
|
b = 10 |
1 |
|
1 |
Метрика пути = 1 |
|
|
|
|
|
2 |
|
|
|
|
c = 01 |
|
|
|
|
0 |
0 |
01 |
01 |
01 |
d = 11
10
Рис. 5.9 Метрики пути для двух сливающихся путей
На рис. 5.9 верхний путь имеет метрику 4, нижний – метрику 1. Верхний путь нельзя выделить как оптимальный, поскольку нижний путь, входящий в то же состояние, имеет меньшую метрику. Это наблюдение поддерживается Марковской природой состояний кодера. Настоящее состояние завершает историю кодера в том смысле, что предыдущие состояния не могут повлиять на будущие состояния или будущие ветви на выходе.
Вкаждый момент времени ti , в решетке существует 2К-1 состояний, где К
–это длина кодового ограничения, и в каждое состояние может войти два пути. Декодирование Витерби состоит в вычислении метрики двух путей, входящих в
170