Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
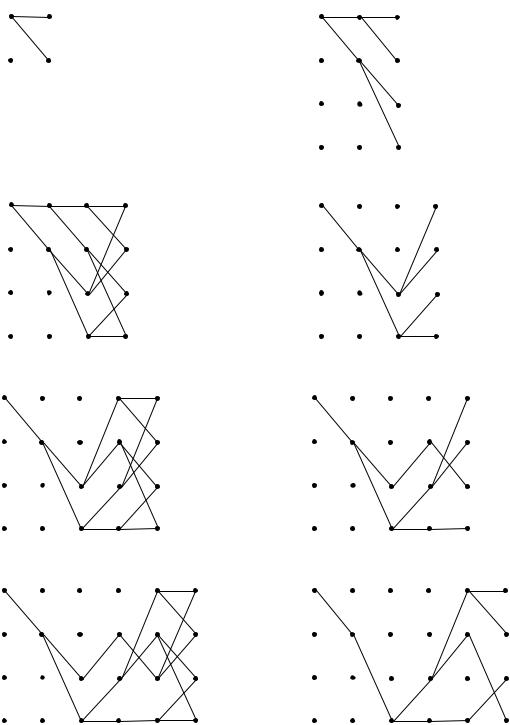
каждое состояние, и исключении одного из них. Такие вычисления проводятся для каждого из 2К-1 состояний или узлов в момент времени ti ; затем декодер переходит к моменту времени ti+1 и процесс повторяется. В данный момент времени метрика выжившего пути для каждого состояния обозначается как метрика для этого состояния в этот момент времени. Первые несколько шагов в нашем примере декодирования будут следующими (рис. 5.10). Предположим, что последовательность входных данных m, кодовое слово U и полученная последовательность Z аналогичны показанным на рис. 5.8.
Допустим, что декодер знает верное исходное состояние решетки. (Это предположение не является необходимым, однако упрощает объяснения.) В момент времени t1 получены кодовые символы 11. Из состояния 00 можно перейти только в состояние 00 или 10, как показано на рис. 3.10, а. Переход между состояниями 00 10 имеет метрику ветви 0; переход между состояниями 00 00 — метрику ветви 2. В момент времени t2 из каждого состояния также может выходить только две ветви, как показано на рис. 5.10, б. Суммарная метрика этих ветвей обозначена как метрика состояний Гa, Гb, Гc и Гd соответствующих конечным состояниям. В момент времени t3 на рис. 5.10, в опять есть две ветви, выходящие из каждого состояния. В результате имеется два пути, входящих в каждое состояние, в момент времени t4. Один из путей, входящих в каждое состояние, может быть исключен, а точнее – это путь, имеющий большую суммарную метрику пути.
Если бы метрики двух входящих путей имели одинаковое значение, то путь, который будет исключаться, выбирался бы произвольно. Выживший путь в каждом состоянии показан на рис. 5.10, г. В этой точке процесса декодирования имеется только один выживший путь, который называется полной ветвью, между моментами времени t1 и t2. Следовательно, декодер теперь может решить, что между моментами t1 и t2 произошел переход 00 10. Поскольку переход вызывается единичным входным битом, на выходе декодера первым битом будет единица. Здесь легко можно проследить процесс декодирования выживших ветвей, поскольку ветви решетки показаны пунктирными линиями для входных нулей и сплошной линией для входных единиц. Заметим, что первый бит не декодируется, пока вычисление метрики пути не пройдет далее вглубь решетки. Для обычного декодера такая задержка декодирования может оказаться раз в пять больше длины кодового ограничения в битах.
На каждом следующем шаге процесса декодирования всегда будет два пути для каждого состояния; после сравнения метрик путей один из них будет исключен. Этот шаг в процессе декодирования показан на рис. 5.10, д. В момент t5 снова имеется по два входных пути для каждого состояния, и один путь из каждой пары подлежит исключению. Выжившие пути на момент t5 показаны на рис. 5.10, е. Заметим, что в нашем примере мы еще не можем принять решения относительно второго входного информационного бита, поскольку еще остается два пути, исходящих в момент t2 из состояния в узле
10.
171
|
|
|
Метрики |
|
|
|
|
|
|
|
состояний |
|
|
|
|
a = 00 |
t1 |
2 t2 |
Гa=2 |
a = 00 |
t1 |
2 t2 |
1 t3 |
|
|
|
|
|
|||
|
|
0 |
|
|
|
0 |
1 |
|
|
|
|
|
|
b = 10 |
Гb=0 |
b = 10 |
2
c = 01
0
d = 11
a = 00 |
t1 |
2 |
t2 |
|
|
|
|
|
|
|
0 |
b = 10 |
|
|
|
c = 01
d = 11
а) |
б) |
1 t3 |
1 t4 |
a = 00 |
t1 |
t2 |
t3 |
t4 |
|
|
1 1 |
|
|
|
|
|
|
1 |
|
|
|
|
|
|
|
|
|
|
|
0 |
|
1 |
|
|
|
|
|
|
|
||
|
|
|
b = 10 |
|
|
|
|
2 |
|
1 |
|
|
2 |
|
1 |
|
|
2 |
c = 01 |
|
|
|
|
|
|
|
|
|
|
|
|
0 |
0 |
0 |
|
|
0 |
|
0 |
|
|
|
|
|
|||
|
|
|
d = 11 |
|
|
|
2 |
|
2 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
в) |
|
|
|
|
|
г) |
a = 00 |
t1 |
t2 |
t3 |
t4 1 |
t5 |
|
|
|
1 |
1 |
|
|
|
|
|
||
|
|
0 |
|
1 |
|
b = 10 |
|
|
|
|
|
|
|
|
2 |
1 |
1 |
|
|
|
|
0 |
|
c = 01 |
|
|
|
|
|
|
|
|
|
|
0 |
0 |
2 |
2 |
a = 00 |
t1 |
t2 |
t3 |
t4 |
t5 |
|
|
|
|
|
|
|
|
0 |
|
|
1 |
b = 10 |
|
|
|
|
|
|
|
|
2 |
1 |
1 |
c = 01 |
|
|
|
|
0 |
|
|
|
|
|
|
|
|
|
0 |
0 |
|
Метрики
состояний
Гa=3
Гb=3
Гc=2
Гd=0
Гa=3
Гb=3
Гc=0
Гd=2
Гa=1
Гb=1
Гc=3
d = 11
2 0
|
|
|
|
д) |
|
|
|
a = 00 |
t1 |
t2 |
t3 |
t4 |
t5 |
|
1 t6 |
|
|
|
|
|
|
|
|
|
|
0 |
|
|
1 |
1 |
1 |
|
|
|
|
|
|||
b = 10 |
|
|
|
|
1 |
|
1 |
|
|
|
|
1 |
|
||
|
|
|
2 |
|
|
|
|
|
|
|
|
|
|
2 |
|
|
|
|
|
|
0 |
|
|
c = 01 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
0 |
|
0 |
0 |
|
|
|
|||
|
|
|
|
|
|
d = 11 |
|
2 |
0 |
2 |
|
|
|
|
ж)
d = 11 |
2 |
0 |
Гd=2 |
|
|
е)
a = 00 |
t1 |
t2 |
t3 |
t4 |
t5 1 |
t6 |
Гa=2 |
|
|
|
|
|
|
||
|
|
0 |
|
1 |
|
1 |
|
b = 10 |
|
|
|
|
|
|
Гb=2 |
|
|
|
|
|
1 |
|
|
c = 01 |
0 |
|
0 |
Гc=2 |
|
|
|
||
|
0 |
|
0 |
|
d = 11 |
2 |
0 |
|
Гd=1 |
|
|
|
з)
Рис. 5.10 Выбор выживших путей: а) выживание на момент t2; б) выжившие на момент t3; в) сравнение метрик в момент t4; г) выжившие на момент t4; д) сравнение метрик в момент t5; е) выжившие на момент t5; ж) сравнение метрик в момент t6; з) выжившие на момент t6.
В момент времени t6 на рис. 5.10, ж снова можем видеть структуру сливающихся путей, а на рис. 5.10, з — выжившие пути на момент t6. Здесь же, на рис. 5.10, з, на выходе декодера в качестве второго декодированного
172
бита показана единица как итог единственного оставшегося пути между точками t2 и t3. Аналогичным образом декодер продолжает углубляться в решетку и принимать решения, касающиеся информационных битов, устраняя все пути, кроме одного.
Отсекание сходящихся путей в решетке гарантирует, что у нас никогда не будет путей больше, чем состояний. В этом примере можно проверить, что после каждого отсекания (рис. 5.10, б—д) остается только 4 пути. Сравните это с попыткой применить "грубую силу" (без привлечения алгоритма Витерби) при использовании для получения последовательности принципа максимального правдоподобия. В этом случае число возможных путей (соответствующее возможным вариантам последовательности) является степенной функцией длины последовательности. Для двоичной последовательности кодовых слов с длиной кодовых слов L имеется 2L возможные последовательности.
5.7 Реализация декодера
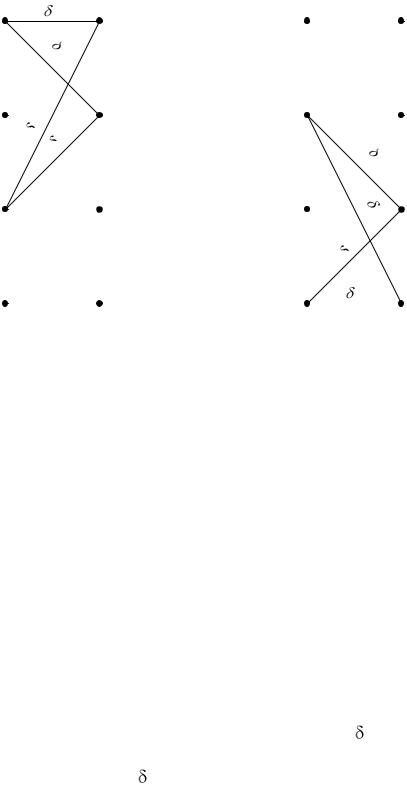
В контексте решетчатой диаграммы, показанной на рис. 5.8, переходы за один промежуток времени можно сгруппировать в 2 -1 непересекающиеся ячейки; каждая ячейка будет изображать четыре возможных перехода, причем v = K- 1 называется памятью кодера (encoder memory). Если К = 3, то = 2, и, следовательно, мы имеем 2 -1 = 2 ячейки. Эти ячейки показаны на рис. 5.11, где буквы a, b, с и d обозначают состояния в момент времени ti , а a', b', с' и d' – состояния в момент времени ti+1. Для каждого перехода изображена метрика ветви xy, индексы которой означают переход из состояния х в состояние у. Эти ячейки и соответствующие логические элементы, которые корректируют метрики coстояний {Гх}, где x означает конкретное расстояние состояния, представляют основные составляющие элементы декодера.
Процедура сложения, сравнения и выбора.
Вернемся к примеру двух ячеек с К = 3. На рис. 5.12 показан логический блок, соответствующий ячейке 1. Логическая схема осуществляет специальную операцию, которая называется сложение, сравнение и выбор (add- compare-select — ACS). Метрика состояния Гa' вычисляется путем прибавления метрики предыдущего состояния а, Гa, к метрике ветви aa' и метрики предыдущего состояния с, Гc, к метрике ветви ca'.
Это даст в результате две метрики путей в качестве кандидатов для новой метрики состояния Гa'. Оба кандидата сравниваются в логическом блоке, показанном на рис. 5.12. Наиболее правдоподобная из двух метрик путей (с наименьшим расстоянием) запоминается как новая метрика состояния Гa' для состояния а'. Также сохраняется новая история путей m€a для состояния а, где
m€a – история пути информации для данного состояния, дополненная
сведениями о выжившем пути.
На рис. 5.12 также показана логическая схема ACS для ячейки 1, которая дает новую метрику состояния Гь’ и новую историю состояния m€b' . Операция
173
ACS аналогичным образом осуществляется и для путей в других ячейках. Выход декодера составляют последние биты на путях с наименьшими метриками состояний.
|
|
Ячейка 1 |
|
|
a |
ti |
aa´ |
ti+1 |
a´ |
|
|
|
ab ´
|
Ячейка 2 |
ti |
ti+1 |
c
c |
a |
´ |
|
b´ |
b |
|
|
|
|
|
|
|
|
||
|
|
|
´ |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
b |
|
|
|
|
|
|
|
c |
|
|
|
|
|
|
|
|
|
|
|
b |
|
|
|
|
|
|
|
c´ |
|
|
|
|
|
|
|
bd´ |
|
|
|
|
|
d |
c |
´ |
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
d |
|
dd´ |
|
|
|
Рис. 5.11 Примеры ячеек декодера |
|
|
c´
d´
Вид процедуры сложения, сравнения и выбора на решетке.
Рассмотрим тот же пример, которым мы воспользовались в этом разделе для описания декодирования на основе алгоритма Витерби. Последовательность сообщений имела вид m = 1 1 0 1 1, последовательность кодовых слов – U = 11 01 01 00 01, а принятая последовательность – Z = 11 01 01 10 01, т.е. в канале в седьмом символе произошла ошибка.
Решетчатая диаграмма декодирования, аналогичная показанной на рис. 5.8, изображена на рис. 5.13. Метрика ветви, которая описывает каждую ветвь, – это расстояние Хэмминга между принятым кодовым символом и соответствующим кодовым словом из решетки кодера. Еще на решетке (рис. 5.13) показаны значения каждого состояния х в каждый момент t2 – t6, метрика состояния которых обозначена Гx. Операция ACS выполняется после появления двух переходов, входящих в состояние, т.е. для момента t4 и более поздних. Например, в момент времени t4 значение метрики состояния для состояния а вычисляется суммированием метрики состояния Гa = 3 в момент t3 и метрики ветви aa’ = 1, что в итоге дает значение 4. В то же время к метрике состояния Гc = 2 в момент времени t3 прибавляется метрика ветви ca’ = 1, что дает значение 3. В ходе процедуры ACS происходит отбор наиболее правдоподобной метрики (с минимальным расстоянием), т.е. новой метрики состояния; поэтому для состояния а в момент t4
174
новой метрикой состояния будет Гa’ = 3. Отобранный путь изображен жирной линией, а путь, который был отброшен, показан тонкой линией.
Гa |
Гc |
||
|
|
|
|
|
|
|
|
|
|
|
|
aa´ |
ca´ |
|
Сравнение |
|
m^a m^c |
Выбор |
Выбор |
1 из 2 |
1 из 2 |
Гa’ |
m^a’ |
ab´ |
cb´ |
|
Сравнение |
|
m^a m^c |
Выбор |
Выбор |
1 из 2 |
1 из 2 |
Гb’ |
m^b’ |
К следующему логическому |
К следующему логическому |
элементу |
элементу |
Рис. 5.12 Логический блок, предназначенный для осуществления операции сложения, сравнения и выбора
На рис. 5.13 на решетке слева направо показаны все метрики состояний. Убедимся, что в любой момент времени значение каждой метрики состояния получается суммированием метрики состояния, соединенного с предыдущим состоянием вдоль отобранного пути (жирная линия), и метрики ветви, соединяющей эти состояния. Через некоторое время на выход декодера будут поданы выжившие ветви, прослеженные до самых ранних битов.
Чтобы показать это, посмотрим на рис. 5.13 в момент t6. Видим, что значение метрики состояния, соответствующей минимальному расстоянию, равно 1. Отобранный путь можно проследить из состояния d обратно, к моменту t1 и убедиться, что декодированное сообщение совпадает с исходным, несмотря на наличии ошибки в принятой последовательности. Напомним, что пунктирные линии соответствуют двоичной единице, а сплошные – двоичному нулю.
5.8 Память путей и синхронизация
175