Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
внутреннего кода, и выносит решение о k информационных битах, основываясь на алгоритме максимального правдоподобия (минимума расстояния). Эти k бит представляют один символ внешнего кода. Когда принят блок из N k -битовых символов от внутреннего декодера, внешний декодер принимает жѐсткое решение по К k -битовым информационным символам, основываясь на декодирование по правилу максимального правдоподобия.
При каскадном кодировании возможно и декодирование мягких решений. Обычно оно выполняется по внутреннему коду, если он выбран так, что имеет немного кодовых слов, т е. 2k не очень велико. Внешний код обычно декодируется посредствам декодера жѐстких решений, особенно если длина блока велика и имеется много кодовых слов. С другой стороны, можно достичь достаточный выигрыш в качестве при использовании декодирования мягких решений по внутреннему и внешнему кодам, чтобы оправдать дополнительную сложность декодирования.
Внутренний код рис. 6.1 связан с модулятором (демодулятором) и каналом; он, как правило, настраивается для исправления большинства канальных ошибок. Внешний код, чаще всего с низкой избыточностью, снижает вероятность появления ошибок до заданного значения. Основной причиной использования каскадного кодирования являются низкая избыточность (высокая скорость) кодирования и меньшая сложность реализации, которая потребовалась бы для осуществления с какой-то одной ступенью кодирования. На рис.6.1 между двумя этапами кодирования располагается устройство перемежения. Делается это для того, чтобы разнести пакеты ошибок, которые могут возникать в результате внутреннего декодирования.
6.1 Турбокоды
Схема каскадного кодирования впервые была предложена Форни как метод получения высокоэффективного кода посредством комбинации двух или более компонуемых кодов (иногда называемых составными). В результате, такие коды могут корректировать ошибки в значительно более длинных кодах и имеют структуру, которая позволяет относительно легко осуществить декодирование средней сложности. Последовательные каскадные коды часто используются в системах с ограничением мощности, таких как спутниковые системы связи.
Самая распространенная из этих схем содержит внешний код РидаСоломона (выполняется первым, убирается последним), который следует за сверточным внутренним кодом (выполняется последним, убирается первым). Турбокод можно считать обновлением структуры каскадного кодирования с итеративным алгоритмом декодирования связанной кодовой последовательности.
Турбокоды впервые были введены в 1993 году Берру, Главье и Цитимаджимой (Berrou, Glavieux, Thitimajshima). Для этих кодов достигалась
191
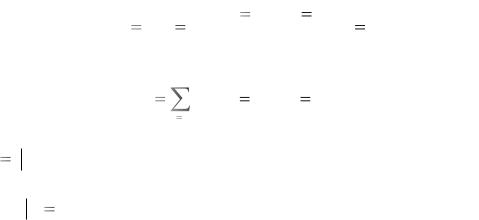
вероятность появления ошибок 10-5 при скорости кодирования 1/2 и модуляции BPSK в канале с белым аддитивным гауссовым шумом (additive white Gaussian noise – AWGN) с Eb/N0, равным 0,7 дБ. Коды образуются посредством компоновки двух или более составных кодов, являющихся разными вариантами чередования одной и той же информационной последовательности. Тогда как для сверточных кодов на финальном этапе декодер выдает жестко декодированные биты (или в более общем случае – декодированные символы), в каскадной схеме, такой как турбокод, для хорошей работы алгоритм декодирования не должен ограничивать себя, подавая на декодеры жесткую схему решений. Для лучшего использования информации, получаемой с каждого декодера, алгоритм декодирования должен применять, в первую очередь, мягкую схему декодирования, вместо жесткой. Для систем с двумя составными кодами концепция, лежащая в основе турбодекодирования, заключается в том, чтобы передать мягкую схему принятия решений с выхода одного декодера на вход другого и повторять эту процедуру до тех пор, пока не будут получены надежные решения [18, 20].
6.1.1 Понятия турбокодирования
6.1.1.1 Функции правдоподобия
Математическое обоснование критерия проверки гипотез проводится по теореме Байеса, которая выражает апостериорную вероятность (a posteriori probability – APP) решения через случайную непррывную переменную х как
P(d i |
|
x) |
|
p(x |
d |
1)P(d |
i) |
, i 1,..., M |
(6.1) |
|
|||||||||
|
|
|
|
|
|||||
|
|
|
|
p(X ) |
|
||||
и |
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|||
|
|
|
M |
|
|
|
|
||
p(x) |
|
p(x |
d |
i)P(d |
i), |
(6.2) |
|||
|
|
|
i 1 |
|
|
|
|
||
где p(d i x) – это апостериорная вероятность, a d = i представляет данные d, принадлежащие i -му классу сигналов из набора классов М. Выражение p(x d i) представляет функцию плотности вероятности
принимаемого непрерывного сигнала с шумом х, при d = i. Также p(d = i), называемое априорной вероятностью, означает вероятность появления i -го класса сигналов. Обычно х представляет "наблюдаемую" случайную переменную или лежащую в основе критерия статистику, которая получается на выходе демодулятора или какого-либо иного устройства обработки сигналов. Поэтому р(х) – это функция распределения вероятностей принятого сигнала х, дающая тестовую статистику в полном пространстве классов сигналов. В уравнении (6.1) при конкретном наблюдении р(х) является коэффициентом масштабирования, поскольку он получается путем усреднения
192
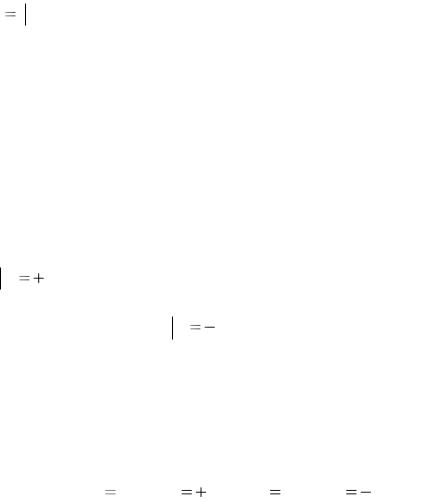
по всем классам пространства. Маленькая буква р используется для обозначения функции распределения вероятностей непрерывной случайной переменной, а большая буква Р – для обозначения вероятности (априорной и апостериорной). Определение апостериорной вероятности принятого сигнала, из уравнения (6.1), можно представлять как результат эксперимента. Перед экспериментом обычно существует (или поддается оценке) априорная вероятность P(d = i). В эксперименте для расчета апостериорной вероятности, P(d i x) , используется уравнение (6.1), и это можно считать "обновлением"
имевшихся сведений, полученных при изучении принятого сигнала х.
6.1.1.2 Пример класса из двух сигналов
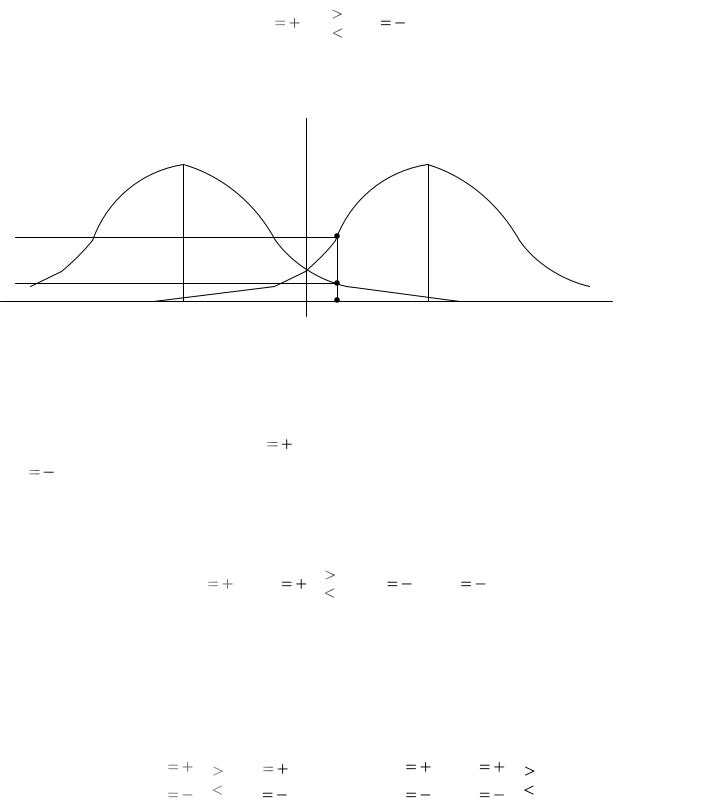
Пусть двоичные логические элементы 1 и 0 представляются электрическими напряжениями +1 и -1. Переменная d представляет бит переданных данных, который выглядит как уровень напряжения или логический элемент. Пусть двоичный 0 (или электрическое напряжение -1) будет нулевым элементом при сложении. На рис. 3.2 показана условная функция распределения вероятностей при передаче сигнала по каналу AWGN, представленная как функция правдоподобия. Функция, изображенная справа, p(x d 1) , представляет функцию распределения вероятностей случайной
переменной х, которая передается при условии, что d = +1. Функция, изображенная слева, p(x d 1) , в свою очередь, представляет ту же функцию
распределения вероятностей случайной переменной х, которая передается при условии, что d = -1. На оси абсцисс показан полный диапазон возможных значений тестовой статистики х, которая образуется в приемнике. На рис. 6.2 показано одно такое произвольное значение xk , индекс которого представляет
наблюдение, произведенное в k-й период времени. Прямая, опущенная в точку xk , пересекает две кривые функций правдоподобия, что дает в итоге два значения
правдоподобия l1 p(xk |
dk |
1) и l2 |
p(xk |
dk |
1). |
Хорошо известное |
правило |
принятия |
решения по жесткой схеме, |
||
называемое принципом максимального правдоподобия, определяет выбор данных dk = +1 или dk = -1, основываясь на большем из двух имеющихся значений l1 или l2. Для каждого бита данных в момент k решение гласит, что dk = +1, если xk попадает по правую сторону линии принятия решений, обозначаемой γ0, в противном случае – dk = -1.
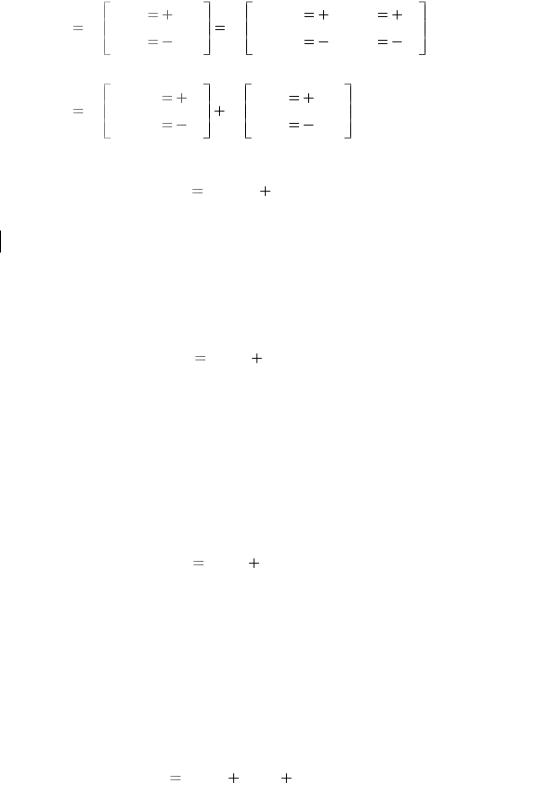
Аналогичное правило принятия решения, известное как максимум апостериорной вероятности (maximum a posteriori — MAP), можно представить в виде правила минимальной вероятности ошибки, принимая во внимание априорную вероятность данных. В общем случае правило MAP выражается следующим образом
193
H1
P(d 1 |
x) P(d 1 |
x). |
(6.3) |
|
|
|
|
H2
Правдоподобие d=-1 |
Правдоподобие d=+1 |
p(x|d=-1) |
p(x|d=+1) |
l1
l2
-1 |
xk |
+1 |
|
γ0 |
|
Рис. 6.2 Функция правдоподобия
|
Из уравнения (6.3) следует, что выбирается гипотеза H1 (d = + 1). Если |
|||||
апостериорная вероятность P(d |
1 |
x) больше |
апостериорной |
вероятности |
||
P(d |
|
|
выбирается |
гипотеза H2 |
(d = - 1). |
|
1 |
x). В противном случае |
|
||||
Воспользовавшись байесовской формой уравнения (6.1), можно записать апостериорную вероятность в уравнении (6.3) эквивалентным выражением
H1
p(x |
d |
1)P(d |
1) p(x |
d |
1)P(d |
1). |
(6.4) |
|
|
|
|
|
|
|
|
H2
Здесь функция распределения вероятности p(x), имеющаяся в обеих частях неравенства (6.1), была исключена. Уравнение (6.4), в целом представленное через дроби, дает так называемую проверку отношения функций правдоподобия
|
1) H1 |
|
|
|
|
|
|
|
|
H1 |
|
|||
p(x |
|
d |
P(d |
1) |
|
p(x |
|
d |
1)P(d |
1) |
|
|||
|
|
|
|
|
или |
|
|
|
|
|
1. |
(6.5) |
||
|
|
|
|
|
|
|
|
|
|
|
|
|||
p(x |
|
d |
1) H2 |
P(d |
1) |
p(x |
|
d |
1)P(d |
1) |
||||
|
|
|||||||||||||
|
|
|
H2 |
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|||
6.1.1.3 Логарифмическое отношение функций правдоподобия
Если взять логарифм от |
соотношения функций правдоподобия, |
полученного в уравнениях (6.3) |
– (6.5), получится удобная во многих |
|
194 |
отношениях метрика, называемая логарифмическое отношение функций правдоподобия (log-likelihood ratio – LLR). Это вещественное представление мягкого решения вне декодера определяется выражением
L(d |
|
|
x) lg |
|
P(d |
1 |
|
x) |
lg |
|
p(x |
|
d |
|
|
1)P(d |
1) |
(6.6) |
|||||
|
|
|
|||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||
|
|
P(d |
1 |
|
x) |
|
p(x |
|
d |
|
|
1)P(d |
1) |
||||||||||
|
|
|
|
|
|
||||||||||||||||||
так, что |
|
|
|
|
|
|
|
|
|
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||
L(d |
|
x) lg |
p(x |
|
d |
1) |
lg |
P(d |
1 |
|
x) |
|
(6.7) |
||||||||||
|
|
||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
||||||||||||||
|
p(x |
|
d |
1) |
|
1 |
|
x) |
|
||||||||||||||
|
|
|
|
|
|
|
|
|
P(d |
|
|
||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||
или |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
(6.8) |
|||||||||||||
|
|
|
|
|
L(d |
x) |
L(x |
d) |
L(d), |
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
где L(x d ) – это LLR тестовой статистики х, получаемой путем измерений х
на выходе канала при чередовании условий, что может быть передан d = +1 или d = -l, a L(d) — априорное LLR бита данных d. Для упрощения обозначений уравнение (6.8) можно переписать следующим образом
' ˆ |
(x) L(d). |
(6.9) |
L(d ) Lc |
Здесь Lc (x) означает, что данный член LLR получается в результате
канальных измерений, произведенных в приемнике. Уравнения (6.1)-(6.9) получены только исходя из данных детектора Далее введение декодера даст стандартные преимущества схемы принятия решений. Для систематических кодов было показано [18], что LLR (мягкий выход) вне декодера равняется следующему
|
|
|
|
ˆ |
' ˆ |
ˆ |
|
(6.10) |
|
|
|
|
L(d ) |
L(d ) |
Le (d ). |
|
|
Здесь |
' |
ˆ |
– |
это LLR бита |
данных вне |
демодулятора |
(на входе |
|
L(d ) |
||||||||
декодера), |
а |
|
ˆ |
называется внешним |
LLR |
и представляет |
внешнюю |
|
Le (d ) |
||||||||
информацию, вытекающую из процесса декодирования. Выходная последовательность систематического декодера образована величинами, представляющими информационные биты, или биты четности. Из уравнений (6.9) и (6.10) выходное LLR декодера теперь примет следующий вид
ˆ |
ˆ |
(6.11) |
L(d) |
Lc (x) L(d) Le (d). |
Уравнение (6.11) показывает, что выходное LLR систематического декодера можно представить как состоящее из трех компонентов - канального измерения, априорного знания данных и внешнего LLR, относящегося только к декодеру.
195