Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_

Чтобы получить финальное |
ˆ |
L(d ) , нужно просуммировать отдельные |
вклады LLR, как показано в уравнении (6.11), поскольку все три компонента
статистически независимы. Мягкий выход декодера |
ˆ |
является вещественным |
L(d ) |
числом, обеспечивающим в итоге, как само принятие жесткого решения, так и его
ˆ |
задает жесткое решение, т.е. при положительном знаке |
||
надежность. Знак L(d ) |
|||
ˆ |
|
ˆ |
определяет |
L(d ) решение – d = +l, а при отрицательном – d = -l. Величина |
L(d ) |
||
|
ˆ |
|
|
надежность этого решения. Часто величина L(d ) вследствие декодирования имеет |
|||
тот же знак, что и Lc (x) |
L(d), и поэтому повышает надежность.. |
|
|
6.1.1.4 Принципы итеративного (турбо) декодирования
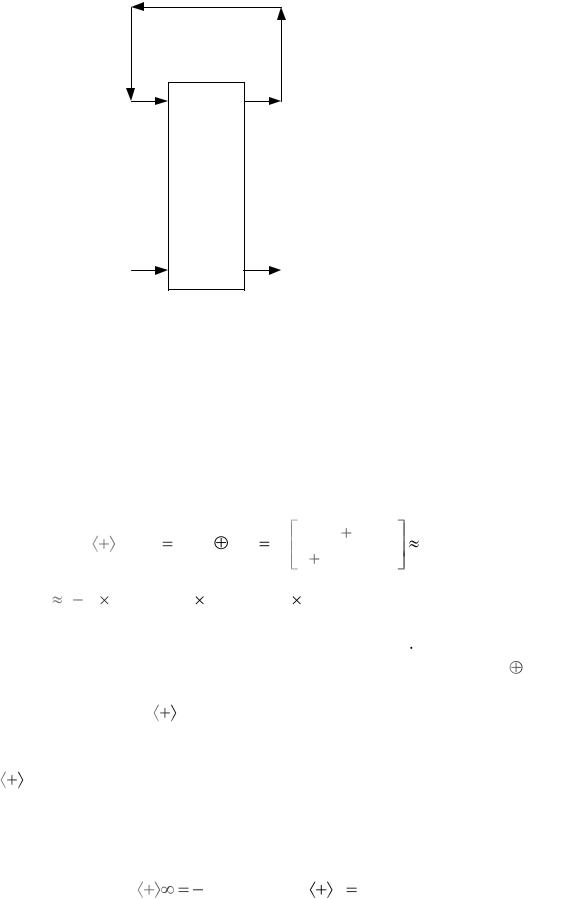
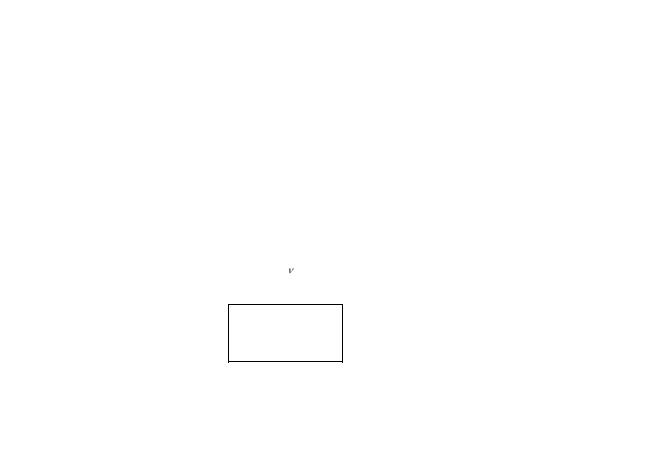
В типичном приемнике демодулятор часто разрабатывается для выработки решений по мягкой схеме, которые затем будут переданы на декодер. В такой схеме повышение достоверности передачи в системе, по сравнению с жесткой cxeмой принятия решений, оценивается приблизительно в 2 дБ в канале AWGN Такой декодер следует называть декодером с мягким входом и жестким выходом, поскольку процесс финального декодирования должен завершаться битами (жесткая схема). В турбокодах, где используется два или несколько составных кодов и декодирование подразумевает подключение выхода одного декодера ко входу другого для возможности поддержки итераций, декодер с жестким выходом нежелателен. Это связано с тем, что жесткая схема в декодере снизит производительность системы (по сравнению с мягкой схемой). Следовательно, для реализации турбодекодирования необходим декодер с мягким входом и мягким выходом. Во время первой итерации на таком декодере (с мягким входом и мягким выходом), показанном на рис. 3.3, данные считаются равновероятными, что дает начальное априорное значение LLR L(d) = 0 для третьего члена уравнения (3.7). Канальное значение LLR Lc(x) получается путем взятия логарифма отношения величин l1 и l2 для определенных значений х (рис. 6.2) и является вторым членом уравнения (6.7). Выход декодера L(d) на рис. 6.3 образуется из LLR детектора L(d) и внешнего LLR выхода L(d) и представляет собой сведения, вытекающие из процесса декодирования. Как показано на рис. 3.3 для итеративного декодирования, внешнее правдоподобие подается обратно на вход (иного составного декодера) для обновления априорной вероятности информации следующей итерации.
6.2 Алгебра логарифма функции правдоподобия
Для более подробного объяснения итеративной обратной связи выходов мягких декодеров, вводится понятие алгебры логарифма функции правдоподобия.
196
6.3 Пример композиционного кода
Рассмотрим двухмерный код (композиционный код), изображенный на рис. 6.4. Его структуру можно описать как массив данных, состоящий из k1 строк и k2 столбцов. В k1 строках содержатся кодовые слова, образованные k2 битами данных и п2 - k2 битами четности. Каждая из k1 строк представляет собой кодовое слово кода (п2, k2). Аналогично k2 столбцов содержат кодовые слова, образованные из k1 бит данных и n1-k1 бит четности. Таким образом, каждый из k2 столбцов представляет собой кодовые слова кода (п1, k1). Различные участки структуры обозначены следующим образом: d – для данных, рh – для горизонтальной четности (вдоль строк) и р — для вертикальной четности (вдоль столбцов). Фактически каждый блок битов данных размером k1 x k2 закодирован двумя кодами — горизонтальным и вертикальным.
|
|
|
k2 |
n2 - k2 |
|
|
|
||
|
|
|
столбцов |
||||||
|
|
|
столбцов |
|
|
|
|
|
|
строк |
d |
|
ph |
|
|
Leh |
|
||
|
|
|
|
|
|
|
|||
|
1 |
|
|
|
|
|
|
|
|
k |
|
|
|
|
|
|
|
||
1 |
|
|
|
|
|
|
|
|
|
строк |
p |
|
|
|
горизонталь |
||||
n |
|
|
|
||||||
k- |
|
|
|
|
|
Внешняя |
|||
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Le
Внешняя
вертикаль
Рис. 6.4 Структура двухмерного композиционного кода
Еще на рис. 6.4 присутствуют блоки Leh и Lev, содержащие значения внешних LLR, полученных из горизонтального и вертикального кодов. Код с коррекцией ошибок дает некоторое улучшение достоверности передачи. Можно увидеть, что внешние LLR представляют собой меру этого улучшения. Заметьте, что такой композиционный код является простым примером каскадного кода. Его структура описывается двумя отдельными этапами кодирования – горизонтальным и вертикальным.
Напомним, что решение при финальном декодировании каждого бита и
ˆ
его надежности зависит от значения L(d ) , как показывает уравнение (6.11).
198
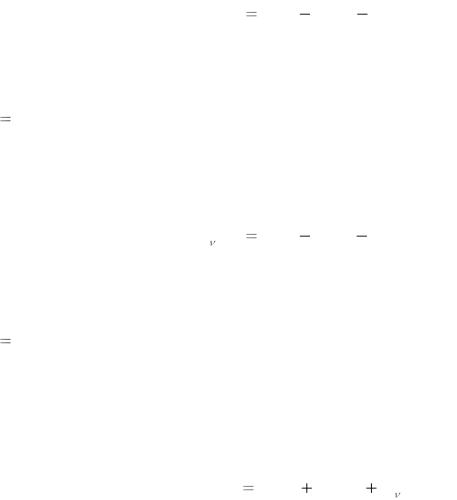
Опираясь на это уравнение, можно описать алгоритм, дающий внешние LLR
(горизонтальное и вертикальное) и финальное |
ˆ |
L(d ) . Для композиционного |
кода алгоритм такого итеративного декодирования будет иметь следующий вид:
1.Устанавливается априорное LLR L(d) = 0 (если априорные вероятности битов данных не равны);
2.Декодируется горизонтальный код и, основываясь на уравнении (3.11), вычисляется горизонтальное LLR
ˆ |
ˆ |
(x) L(d); |
Leh (d) L(d) Lc |
||
3. Для этапа 4 вертикального декодирования устанавливается
€
L(d) Leh (d);
4. Декодируется вертикальный код и, основываясь на уравнении (6.11), вычисляется вертикальное LLR
€ |
€ |
(x) L(d); |
Le (d) L(d) Lc |
||
5. Для этапа 2 горизонтального декодирования устанавливается
ˆ Затем повторяются этапы 2-5;
L(d ) Leh (d);
6.После достаточного для получения надежного решения количества итераций (т.е. повторения этапов 2—5) следует перейти к этапу 7;
7.Мягким решением на выходе будет
ˆ |
ˆ |
ˆ |
(6.13) |
L(d ) |
Lc (x) Leh (d ) |
Le (d ). |
Теперь рассмотрим пример, демонстрирующий применение этого алгоритма к очень простому композиционному коду.
6.3.1 Пример двухмерного кода с одним разрядом контроля четности
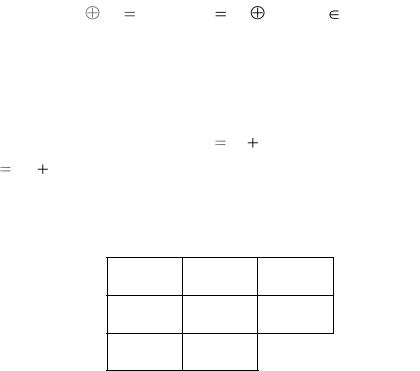
Пусть в кодере биты данных и биты контроля четности имеют значения, показанные на рис. 6.5, а. Связь между битами данных и битами контроля четности внутри конкретной строки (или столбца) выражается через двоичные цифры (1,0) следующим образом:
199
di d j |
pij , и di d j |
pij , i, j (1,2), |
(3,4), (1,3), (2,4) . (6.14) |
Переданные |
биты |
представлены |
последовательностью |
d1,d2 ,d3,d4 , p12 , p34 , p13, p24. На входе приемника искаженные помехами биты
представляются |
последовательностью |
xi , xij . |
При |
этом для |
каждого |
принятого бита |
данных xi di n, для |
каждого |
бита |
контроля |
четности |
xij pij n, а n представляют собой аддитивные помехи, которые статистически независимы от dij и pij .
d1=1 d2=0 p12=1
d3=0 d4=1 p34=1
p13=1 p24=1
а) Выходные двоичные цифры кодера
Lc(x1)=1,5 |
Lc(x2)=0,1 |
Lc(x12)=2,5 |
|
|
|
Lc(x3)=0,2 |
Lc(x4)=0,3 |
Lc(x34)=2,0 |
|
|
|
Lc(x13)=6,0 |
Lc(x24)=1,0 |
|
|
|
|
б) Логарифмическое отношение функций правдоподобия на входе декодера, Lc(x)
Рис. 6.5 пример композиционного кода
Если основываться на отношениях, установленных в уравнениях (6.6) – (6.9), и принять модель канала с AWGN, то LLR для канальных измерений сигнала xk , принятого в k-ый момент времени, будет иметь следующий вид
200