Материал: 636_Nosov_V.I._Seti_radiodostupa_CH.1_
5.5.1 Декодирование по методу максимального правдоподобия
Если все входные последовательности сообщений равновероятны, то минимальная вероятность ошибки получается при использовании такого декодера, который сравнивает условные вероятности и выбирает из них максимальную. Условные вероятности также называют функциями
правдоподобия P(Z U (m ) ) , где Z – это принятая последовательность, a U (m ) –
одна из возможных переданных последовательностей. Декодер выбирает U (m ) , если
P(Z |
|
U (m ) ) max P(Z |
|
U (m) ) |
(5.2) |
|
|
||||
|
|
по всемU (m) |
|||
|
|
|
|||
Принцип максимального правдоподобия, определяемый уравнением (5.2), является фундаментальным достижением теории принятия решений – это формализация способа принятия решений, основанного на "здравом смысле", когда имеются статистические данные о вероятностях. Однако при использовании принципа максимального правдоподобия в задаче сверточного декодирования, в сверточном коде обнаруживается наличие памяти (полученная последовательность является суперпозицией текущих и предыдущих двоичных разрядов). Таким образом, применение принципа максимального правдоподобия при декодировании бит данных, закодированных сверточным кодом, осуществляется в контексте выбора наиболее вероятной последовательности, как показано в уравнении (5.2). Обычно имеется множество возможных переданных последовательностей кодовых слов. Что касается двоичного кода, то последовательность из L кодовых слов является членом набора из 2L возможных последовательностей. Следовательно, в контексте максимального правдоподобия можно сказать, что в качестве переданной последовательности декодер выбирает U (m ) , если правдоподобие P(Z U (m ) ) больше правдоподобия всех остальных возможно переданных
последовательностей. Такой оптимальный декодер, минимизирующий вероятность ошибки (когда все переданные последовательности равновероятны), известен как декодер, работающий по принципу максимального правдоподобия (maximum likelihood detector). Функция правдоподобия задается или вычисляется, исходя из спецификации канала.
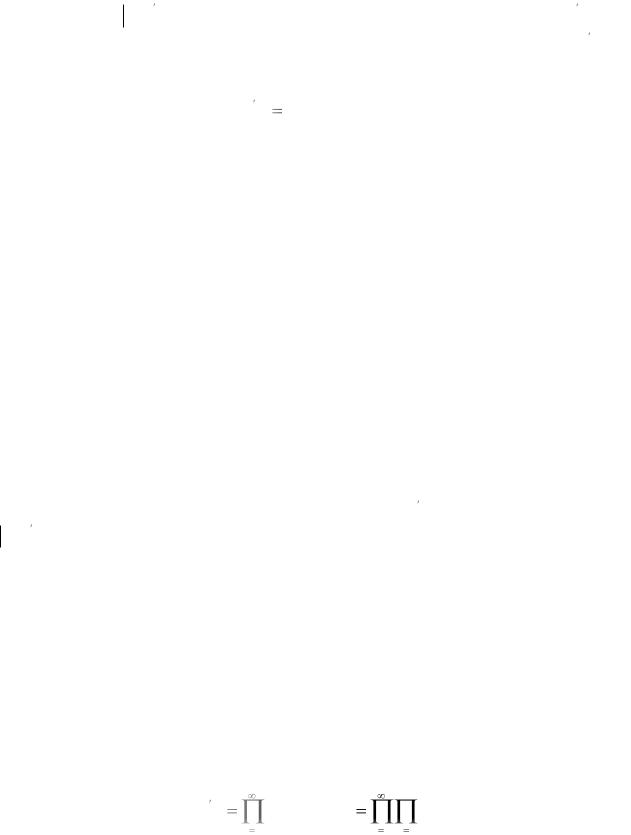
Предположим, что мы имеем дело с аддитивным белым гауссовым шумом с нулевым средним, следовательно, каналом без памяти, т.е. шум влияет на каждый символ кода независимо от остальных символов. При степени кодирования сверточного кода, равной 1/n, правдоподобие можно выразить следующим образом:
|
U (m ) ) |
|
U (m) ) |
n |
|
|
(m) ). |
(5.3) |
P(Z |
P(Z |
P(z |
ji |
u |
||||
|
|
|
i |
|
|
ji |
|
|
|
|
i 1 |
i 1 j 1 |
|
|
|
|
|
161
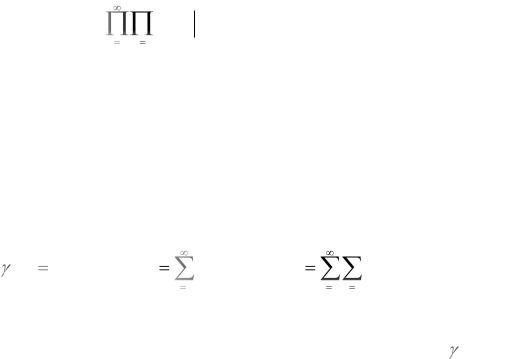
Здесь Zi – это i-я ветвь принятой последовательности Z, Ui(m) – это ветвь отдельной последовательности кодовых слов U (m) , zji — это j-й кодовый символ Zi , uji(m) – это j -й кодовый символ Ui(m) , а каждая ветвь состоит из п кодовых
символов. Задача декодирования заключается в выборе пути сквозь решетку, показанную на рис. 5.6 (каждый возможный путь определяет последовательность кодовых слов), таким образом, чтобы произведение
n
P(z |
ji |
u |
(m) ) было максимальным |
(3.4) |
|
|
ji |
|
i 1 j 1
Как правило, при вычислениях удобнее пользоваться логарифмом функции правдоподобия, поскольку это позволяет произведение заменить суммированием. Мы можем воспользоваться таким преобразованием, поскольку логарифм является монотонно возрастающей функцией и, следовательно, не внесет изменений в выбор окончательного кодового слова. Логарифмическую функцию правдоподобия можно определить следующим, образом
U ( m )
|
U (m) ) |
|
|
U (m) ) |
n |
|
|
(m) ). (5.5) |
lg P(Z |
lg P(Z |
i |
lg P(z |
ji |
u |
|||
|
|
|
i |
|
|
ji |
||
|
|
i 1 |
|
|
i 1 j 1 |
|
|
|
Теперь задача декодирования заключается в выборе пути вдоль дерева на рис. 5.5 или решетки на рис. 5.6 таким образом, чтобы U ( m) было
максимальным. При декодировании сверточных кодов можно использовать как древовидную, так и решетчатую структуру. При древовидном представлении кода игнорируется то, что пути снова объединяются. Для двоичного кода количество возможных последовательностей, состоящих из L кодовых слов, равно 2L. Поэтому декодирование полученных последовательностей, основанное на принципе максимального правдоподобия с использованием древовидной диаграммы, требует метода "грубой силы" или исчерпывающего сопоставления 2L накопленных логарифмических метрик правдоподобия, описывающих все варианты возможных последовательностей кодовых слов. Поэтому рассматривать декодирование на основе принципа максимального правдоподобия с помощью древовидной структуры практически невозможно.
В предыдущем разделе было показано, что при решетчатом представлении кода декодер можно построить так, чтобы можно было отказываться от путей, которые не могут быть кандидатами на роль максимально правдоподобной последовательности. Путь декодирования выбирается из некоего сокращенного набора выживших путей. Такой декодер, тем не менее, является оптимальным; в том смысле, что путь декодирования такой же, как и путь, полученный с помощью декодера критерия
162

максимального правдоподобия, действующего "грубой силой", однако предварительный отказ от неудачных путей снижает сложность декодирования.
Существует несколько алгоритмов, которые дают приблизительные решения задачи декодирования на основе критерия максимального правдоподобия, включая последовательный и пороговый. Каждый из этих алгоритмов является подходящим для узкоспециальных задач, однако все они близки к оптимальному. Алгоритм декодирования Витерби, напротив, осуществляет декодирование на основе критерия максимального правдоподобия шире, следовательно, является оптимальным. Это не означает, что алгоритм Витерби в любой реализации является наилучшим; при его использовании существуют жесткие условия, налагаемые на аппаратное обеспечение
5.5.2 Модели каналов: мягкое или жесткое принятие решений
Перед тем как начать разговор об алгоритме, который задает схему принятия максимально правдоподобного решения, давайте сначала опишем канал. Последовательность кодовых слов U(m), определяемую словами ветви, каждое из которых состоит из п кодовых символов, можно рассматривать как бесконечный поток, в отличие от блочного кода, где исходные данные и их кодовые слова делятся на блоки строго определенного размера. Последовательность кодовых слов выдается сверточным кодером и подается на модулятор, где кодовые символы преобразуются в сигналы. Модуляция может быть низкочастотной (например, модуляция импульсными сигналами) или полосовой (например, модуляция PSK или FSK). Вообще, за такт в сигнал si(t) преобразуется l символов, где l – целое, причем i = 1, 2, ..., а M = 2l. Если l = 1, модулятор преобразует каждый кодовый символ в двоичный сигнал. Предполагается, что канал, по которому передается сигнал, искажает сигнал гауссовым шумом. После того как искаженный сигнал принят, он сначала обрабатывается демодулятором, а затем подается на декодер.
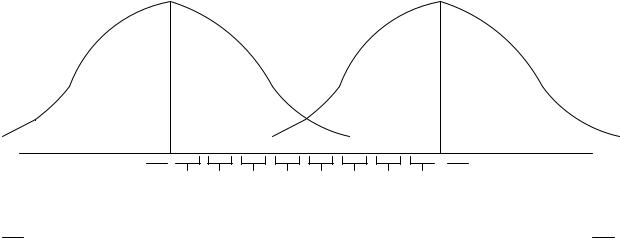
Рассмотрим ситуацию, когда двоичный сигнал передается за отрезок времени (0, Т), причем двоичная единица представляется сигналом s1(t) а двоичный нуль — сигналом s2(t). Принятый сигнал имеет вид r(t) = si(t) + n(t), где n(t) представляет собой вклад гауссового шума с нулевым средним. Детектирование r(t) производится в два основных этапа. На первом этапе принятый сигнал переводится в число z(T) = ai + n0, где аi – это компонент сигнала z(T), a n0 – компонент шума. Компонент шума n0 – это случайная переменная, значения которой имеют гауссово распределение с нулевым средним. Следовательно, z(T) также будет случайной гауссовой величиной со средним а1 или а2 в зависимости от того, какая величина была отправлена – двоичная единица или двоичный нуль. На втором этапе процесса детектирования принимается решение о том, какой сигнал был передан. Это решение принимается на основе сравнения z(T) с порогом. Условные вероятности z(T), p(z s1) и p(z s2 ) ,
показанные на рис. 5.7, обозначены как правдоподобие s1 и s2.
163
000 |
001 |
010 |
011 |
100 |
101 |
110 |
111 |
|
8-уровневая схема |
||
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
мягких решений |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
|
1 |
|
||
|
|
|
|
|
|
|
|
|
|
2-уровневая схема |
|
|
|
|
|
|
|
|
|
|
|
жестких решений |
|
Рис. 5.7 Жесткая и мягкая схемы декодирования
Демодулятор преобразует упорядоченный по времени набор случайных переменных {z(T)} в кодовую последовательность Z и подает ее на декодер. Выход демодулятора можно настроить по-разному. Можно реализовать его в виде жесткой схемы принятия решений относительно того, представляет ли z(T) единицу или нуль. В этом случае выход демодулятора квантуется на два уровня, нулевой и единичный, и соединяется с декодером. Поскольку декодер работает в режиме жесткой схемы принятия решений, принятых демодулятором, такое декодирование называется жестким.
Аналогично демодулятор можно настроить так, чтобы он подавал на декодер значение z(T), квантованное более чем на два уровня. Такая схема обеспечивает декодер большим количеством информации, чем жесткая схема решений. Если выход демодулятора имеет более двух уровней квантования, то декодирование называется мягким. На рис. 5.7 на оси абсцисс изображено восемь (3-битовых) уровней квантования. Если в демодуляторе реализована жесткая схема принятия двоичных решений, он отправляет на декодер только один двоичный символ. Если в демодуляторе реализована мягкая двоичная схема принятия решений, квантованная на восемь уровней, он отправляет на декодер 3-битовое слово, описывающее интервал, соответствующий z(T). По сути, поступление такого 3-битового слова, вместо одного двоичного символа, эквивалентно передаче декодеру меры достоверности вместе с решением относительно кодового символа.
Согласно рис. 5.7, если с демодулятора поступила на декодер последовательность 111, это равносильно утверждению, что с очень высокой степенью достоверности кодовым символом была 1, в то время как переданная последовательность 100 равносильна утверждению, что с очень низкой степенью достоверности кодовым символом была 1. Совершенно ясно, что, в конечном
164
счете, каждое решение, принятое декодером и касающееся сообщения, должно быть жестким; в противном случае на распечатках компьютера можно было бы увидеть нечто, подобное следующему: "думаю, это 1", "думаю, это 0" и т.д. То, что после демодулятора не принимается жесткое решение и на декодер поступает больше данных (мягкое принятие решений), можно понимать как промежуточный этап, необходимый для того, чтобы на декодер поступило больше информации, с помощью которой он затем сможет восстановить последовательность сообщения (с более высокой достоверностью передачи сообщения по сравнению с декодированием в рамках жесткой схемы принятия решений). Показанная на рис. 5.7 8-уровневая метрика мягкой схемы принятия решений часто обозначается как -7, -5, -3, -1, 1, 3, 5, 7. Такие обозначения вводятся для простоты интерпретации мягкой схемы принятия решения. Знак метрики характеризует решение (например, выбирается s1 если величина положительна, и s2, если отрицательна), а величина метрики описывает степень достоверности этого решения. Преимуществом метрики, показанной на рис. 5.7, является только то, что в ней не используются отрицательные числа.
Для гауссова канала восьмиуровневое квантование, по сравнению с двухуровневым, приводит в результате к улучшению на 2 дБ требуемого отношения сигнал/шум. Это означает, что восьмиуровневое квантование с мягкой схемой принятия решений может дать ту же вероятность появления ошибочного бита, что и декодирование с жесткой схемой принятия решений, однако требует на 2 дБ меньшего значения Eb/N0 при прочих равных характеристиках. Аналоговое квантование (или квантование с бесконечным числом уровней) дает в результате улучшение на 2,2 дБ, по сравнению с двухуровневым; следовательно, при восьмиуровневом квантовании, по сравнению с квантованием с бесконечным числом уровней, теряется приблизительно 0,2 дБ. По этой причине квантование более чем на восемь уровней может дать только небольшое улучшение производительности.
Какова цена, которую следует заплатить за такое улучшение параметров декодирования с мягкой схемой принятия решений. В случае декодирования с жесткой схемой принятия решений, для описания каждого кодового символа используется один бит, в то время как при восьмиуровневой мягкой схеме принятия решения для описания каждого символа применяется 3 бита; следовательно, в течение процесса декодирования нужно успеть обработать в три раза больше данных. Поэтому за мягкое декодирование приходится платить увеличением требуемых объемов памяти (и, возможно, возникнут проблемы со скоростью обработки).
В настоящее время существуют блочные и сверточные алгоритмы декодирования, функционирующие на основе жесткой или мягкой схемы принятия решений. Однако при блочном декодировании мягкая схема принятия решений, как правило, не используется, поскольку ее значительно сложнее реализовать, чем схему жесткого принятия решений. Чаще всего мягкая схема принятия решений применяется в алгоритме сверточного
165