Материал: Моделирование, анализ и оценка надежности информационных систем и технологий. Некравцева Т.А., Толстых Т.О
100
ем каждой ветви стрелок. Если стрелка именована до разветвления, а после разветвления стрелки ни одна из ветвей не именована, то считается, что каждая ветвь моделирует те же данные или объекты, что и ветвь до разветвления. Если стрелка именована до разветвления, а после разветвления осталась неименованной какая–либо ветвь, то она моделирует те же данные или объек-
ты, что и ветвь до разветвления. Недопустима ситуация, когда стрелка до разветвления не именована, а после разветвления не именована какая-либо ветвь.
Все работы модели нумеруются. Номер состоит из префикса и числа. Может быть использован префикс любой длины, но обычно используется префикс А. Контекстная (корневая) работа дерева имеет номер А0. Работы декомпозиции А0 имеют номера А1, А2, А3 и т.д. Работы декомпозиции нижнего уровня имеют номер родительской работы и очередной порядковый номер, например работы декомпозиции А3 будут иметь номера А31, А32, А33 и т.д. Работы образуют иерархию, где каждая работа может иметь одну родительскую и несколько дочерних работ, образуя дерево. Такое дерево называют деревом узлов, а нумерацию - нумерацией по узлам.
Рекомендации по рисованию диаграмм:
Прямоугольники работ должны располагаться по диагонали с левого верхнего в правый нижний угол (порядок доминирования). Порядок доминирования подчеркивает взаимосвязь работ, позволяет минимизировать изгибы и пересечения стрелок.
Следует максимально увеличивать расстояние между входящими или выходящими стрелками на одной грани работы.
Следует максимально увеличить расстояние между работами, поворотами и пересечениями стрелок.
Если две стрелки проходят параллельно (начинаются из одной и той же грани одной работы и заканчиваются на одной и той же грани другой работы), то по возможности их следует объединить и назвать единым термином.
Циклические обратные связи следует рисовать только в случае крайней необходимости, когда подчеркивают значение повторно используемого объекта.
Следует минимизировать число пересечений, петель и поворотов стрелок. Это ручная и творческая работа.
101
КОНТРОЛЬНЫЕ ВОПРОСЫ
1.Приведите определение системы массового обслуживания, представьте ее обобщенную структуру.
2.Что представляет собой простейший поток заявок? Каковы его основные свойства?
3.Дайте характеристику марковскому случайному процессу.
4.Представьте простейший поток как пример марковского процесса.
5.Приведите основные характеристики накопителя заявок СМО.
6.Приведите основные характеристики узла обслуживания СМО.
7.Какие характеристики СМО Вы знаете?
8.Перечислите показатели загруженности СМО.
9.Какие показатели характеризуют пропускную способность СМО.
102
ГЛАВА 6. СТАТИСТИЧЕСКАЯ ОБРАБОТКА РЕЗУЛЬТАТОВ ИМИТАЦИОННОГО МОДЕЛИРОВАНИЯ
6.1. Процедуры предварительной обработки архивной информации для формирования статистических моделей
Статистические модели (регрессионные, классификационные и другие) строятся на основе статистических данных, полученных в результате сбора архивной информации или проведения имитационного эксперимента. Большое влияние на точность построенных моделей оказывает правильный отбор и подготовка статистической информации.
Среди методов целенаправленного отбора статистической информации можно выделить два класса алгоритмов:
1)алгоритмы фильтрации информации, позволяющие провести отбор достоверной информации для адекватной оценки ситуации;
2)алгоритмы исключения параметрической избыточности, осуществляющие оптимальный выбор признакового пространства.
Основными причинами существования факта недостоверности информации являются: отсутствие возможности обеспечения объективности оценок; трудность количественной оценки качественных показателей; погрешности вызванные сбоями аппаратуры; ошибки при внесении данных. Для минимизации вероятности использования искаженной и недостоверной информации при анализе ситуации и построении моделей необходимы ее предварительный отбор или фильтрация.
Основным эвристическим правилом при информационной фильтрации является отбор информационных сообщений с наиболее вероятным, т.е. наиболее типичным для данной ситуации набором сведений.
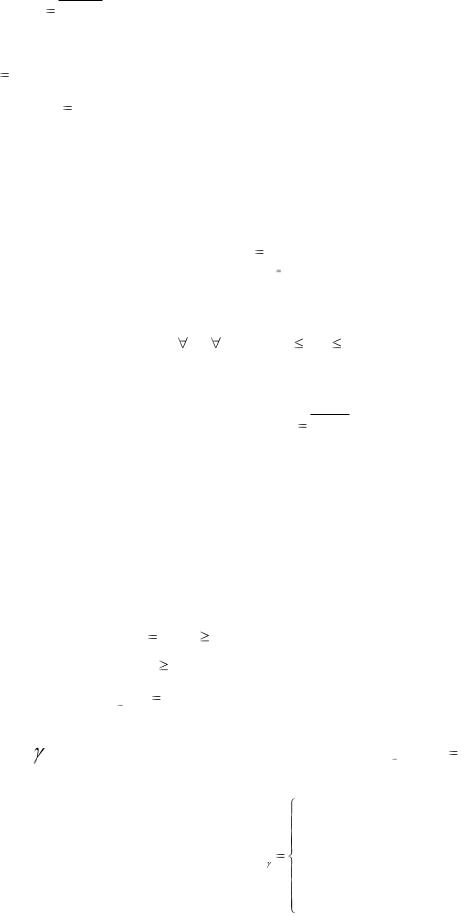
Всю исходную информацию можно представить в виде множества объ-
ектов
|
|
|
|
N исх |
|
|
|
|
|
|
Gисх |
gn |
, |
|
(6.1) |
|
|
|
|
n 1 |
|
|
|
где |
N исх - объем исходной выборки. |
|
|
||||
Каждый объект характеризуется набором показателей: |
|||||||
|
1 |
2 |
i |
,..., Pn |
, |
||
|
|
|
n : gn Pn Pn |
, Pn ,..., |
Pn |
||
|
|
|
|
|
|
I исх |
|
|
|
|
|
|
|
|
|
где |
i 1, I исх - индекс показателя, |
|
|
|
|||
103
- порядковый номер объекта.
На первом этапе фильтрации информации для каждого показателя P i
|
|
|
|
|
|
i |
|
|
( i 1, I исх ) |
устанавливаются нижняя и верхняя допустимые границы |
и |
||||||
Pmin |
||||||||
Pmaxi , ( i |
|
|
|
|||||
1, I исх ), выход за которые возможен только из-за ошибок измере- |
||||||||
ния или записи показателя. Затем осуществляется отсеивание сообщений, которые не могут быть достоверными из-за выхода значения какого-либо отдельного параметра (или группы параметров) за допустимые границы. В результате формируется множество
|
N гр |
|
|
|
|
Gгр |
gn , |
|
|
(6.2) |
|
|
n 1 |
|
|
|
|
в которое входят только измерения, удовлетворяющие следующему ус- |
|||||
ловию: |
|
|
|
|
|
|
i |
i |
i |
, |
(6.3) |
n, i : |
Pmin |
Pn |
Pmax |
||
Решение задачи второго, основного этапа информационной фильтрации заключается в отборе из исходного множества информационных сообщений с оценкой достоверности wn ( n 1, N гр ) выше некоторой значимой
величины w0 . Информация, содержащая фиксированные смысловые (лин-
гвистические) значения сообщений должна быть на основе экспертных оценок преобразована в численную.
Преобразование осуществляется следующим образом.
Сообщения, имеющие два возможных варианта (типа «Да», «Нет»), преобразуются соответственно в 1 и 0.
Если сообщение может принимать более двух различных лингвистиче-
ских значений L i (i |
|
|
|
|
|
3) , используется метод экспертных оценок. Пе- |
||
1,l; l |
||||||||
ред N экспертами ( N |
|
|
2 ), ставится вопрос: «Насколько значение L i более |
|||||
|
|
|
|
|
|
|
||
значимо, чем Li 1 ( i |
|
2, l ) ?» Ответы для каждой пары формируются в форме |
||||||
лингвистической переменной |
||||||||
|
|
|
|
|||||
i <сообщение L i |
важнее сообщения L i 1 > ( i 2, l ). |
|||||||
В качестве термов этой переменной определены следующие:
сильно
существенно T несколько
немного
мало
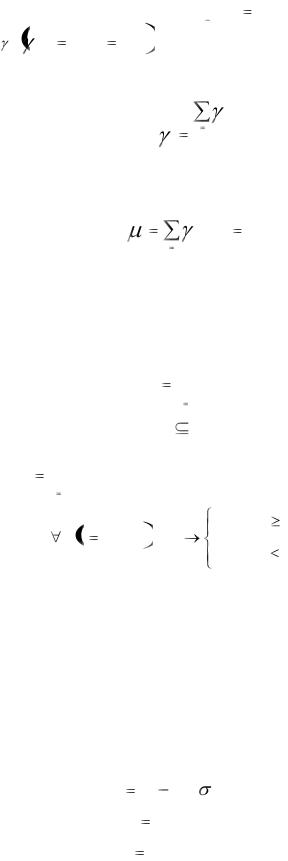
104
Для перевода к численному виду, каждому значению терма ставится в соответствие число от 1
до 5.
|
|
|
|
|
|
|
|
|
|
||
В результате по каждой паре L i , L i |
|
1 ( i 2, l ) формируется N значе- |
|||||||||
|
|
|
|
|
|
|
|||||
ний переменной |
, i 2,l, j 1, N . Обобщенное значение переменной вы- |
||||||||||
ij |
|
|
|
|
|
|
|
|
|
|
|
числяется по формуле |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
N |
|
|
|
|
|
|
|
|
|
|
|
j |
1 |
ij |
. |
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
i N
Численная оценка каждого исходного значения определяется следующим образом:
|
|
i |
|
|
|
|
|
|
, ( i 1, l ). |
||
i |
j |
1 |
j |
||
|
|
|
|
||
Для информации, имеющей численные значения сведений, решением задачи информационной фильтрации является отображение множества информационных сообщений (6.2) во множество оценок достоверности исходных сообщений
|
|
W |
N гр |
|
|
|
|
|
|
|
|
wn |
|
|
|
(6.4) |
|||
|
|
|
|
n 1 |
|
|
|
|
|
и формирование множества Gф |
Gгр |
отобранных (отфильтрован- |
|||||||
N ф |
|
|
|
|
|
|
|
|
|
ных) сообщений Gф g f |
|
по правилу |
|
|
|
|
|
||
f 1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
g f |
|
wn |
w0 |
|
|
|
|
|
|
|
|
|||
|
1, N гр : gn |
|
|||||||
n n |
|
|
wn |
0 , |
(6.5) |
||||
|
|
||||||||
|
|
|
|
|
0 |
|
w |
|
|
где 0 - некоторое пустое множество.
Как правило, различные показатели измерены в разных единицах измерения. Для эффективной работы алгоритма фильтрации информации необходимо произвести нормировку всех показателей. Нормировка представляет собой переход к некоторому единообразному описанию для всех признаков, к введению новой единицы измерения, допускающей формальные сопоставления объектов. Может быть использован один из указанных ниже способов нормировки (переход от исходных значений x к нормированным z ):
z1 |
|
|
|
(6.6) |
(x x) / , |
||||
z2 |
|
|
|
(6.7) |
x / x, |
||||
z3 |
x / x' , |
(6.8) |
||