Материал: Моделирование, анализ и оценка надежности информационных систем и технологий. Некравцева Т.А., Толстых Т.О
105
|
|
|
|
|
z4 |
|
x / xmax , |
(6.9) |
|
|
|
|
z5 |
|
|
|
(6.10) |
|
|
|
|
(x |
x) /(xmax xmin), |
|||
где x, |
- соответственно среднее и среднеквадратическое отклоне- |
|||||||
ние x ; |
|
|
|
|
|
|
||
x' - некоторое эталонное (нормативное) значение x ; |
|
|||||||
xmax , |
xmin |
- наибольшее и наименьшее значение x . |
|
|||||
Нормировки z1 |
и z2 |
определены для шкал отношений и интервалов, |
||||||
остальные - только для шкал отношений. |
|
|||||||
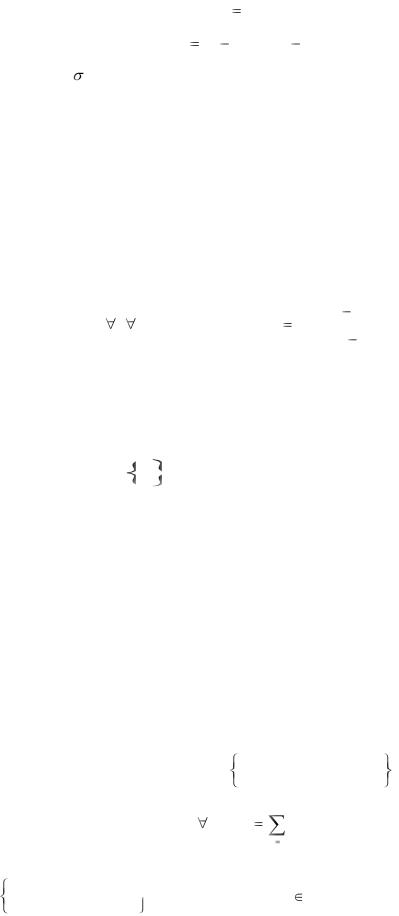
Наиболее удобна нормировка относительно допустимого диапазона изменения значений показателей. Для задачи (6.2) она определяется по следующей формуле:
|
|
i |
i |
|
n, i : P _ norm |
i |
i |
i |
(6.11) |
|
|
Pn |
Pmin |
|
|
n |
Pmax |
P min |
|
|
|
|
Определение степени достоверности информационных сообщений при решении задачи (6.4) - (6.5) основано на концепции типичности, т.е. достоверность wn информационного сообщения считается тем выше, чем оно типичнее для данной ситуации (для всего ряда сообщений). Поскольку сведе-
ния из сообщений |
i |
представлены численными значениями, правомерен |
Pn |
геометрический подход, позволяющий рассматривать информационные сообщения как «созвездия» в i-мерном гиперпространстве признаков. Способ и адекватность решения зависят от дополнительных априорных данных о степени «засоренности» исходной выборки сообщений Gгр .
Если априорно известно, что выборка Gгр «засорена» мало, то право-
мерно предположить, что сообщения gn сгруппированы некоторым образом
симметрично относительно мнимого центра тяжести и с большей вероятностью наиболее достоверные сообщения располагаются на наименьшем рас-
стоянии от некоторого гипотетического обобщенного сообщения g0 с чис-
ленным набором сведений P 0  p10 , p02 ,..., pi0 ,..., p0I гр , где
i : pi |
N гр P _ normi / N . |
|
o |
n 1 |
n |
|
|
|
Решением является вычисление значений вектора расстояний |
||
S  s1 , s2 ,..., sn ,..., sN гр
 от сообщений gn Gгр до обобщенного сообщения g0
106
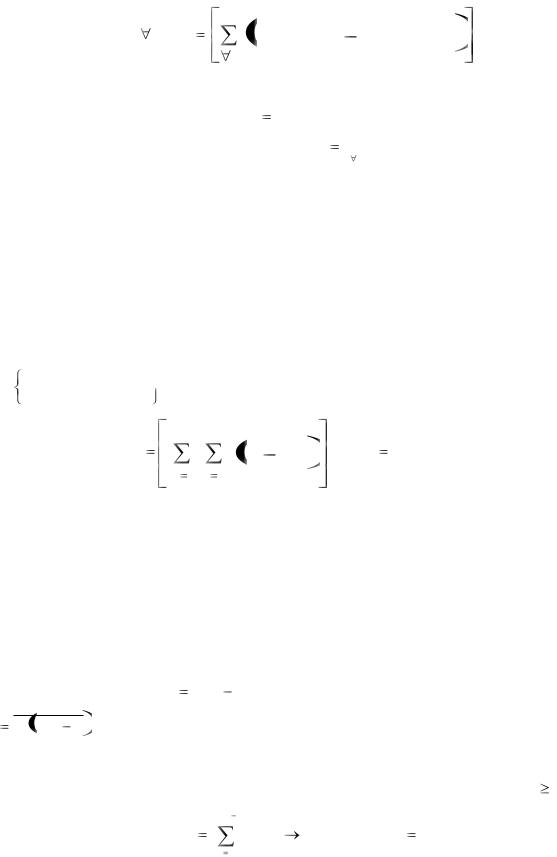
с использованием той или иной адекватной по отношению к сведениям метрики, например евклидовой:
1/ 2
n : sn |
|
P _ norm |
i |
P _ norm |
i 2 |
|
n |
0 |
|||
|
i |
|
|
||
|
|
|
|
|
При этом степень достоверности сообщений gn
wn smin / sn , |
(6.12) |
где |
smin minn sn . |
Если выборка Gгр «засорена» более значительно, например наполовину, то более правильно предположить асимметрию распределения фактов и тогда понятие обобщенного сообщения g 0 не может адекватным образом представить выборку Gгр . В этом случае предлагаются следующие процеду-
ры определения степени достоверности сообщений: с использованием той или иной адекватной по отношению к сведениям метрики, например евклидовой, вычисляются значения вектора суммарных расстояний
S  s1 , s2 ,..., sn ,..., sN гр
 от каждого информационного сообщения до прочих
|
|
|
1 / 2 |
|
N гр I исх |
2 |
|
|
|
s n |
Pin Pim |
, n 1, N гр |
||
m 1 |
i 1 |
|
|
|
и аналогично (6.21) определяется степень достоверности сообщений. Если выборка Gгр сильно «засорена», но есть значимая вероятность
того, что группа достоверных информационных сообщений достаточно выражена в смысле гипотезы компактности по отношению к прочим возможным группировкам, то правомерен подход, основанный на классификационном (кластерном) анализе. Предлагаются следующие процедуры определения степени достоверности информации. Если объем выборки Gгр составляет
N гр , то организуется M N гр 2 итерационных цикла с индексами
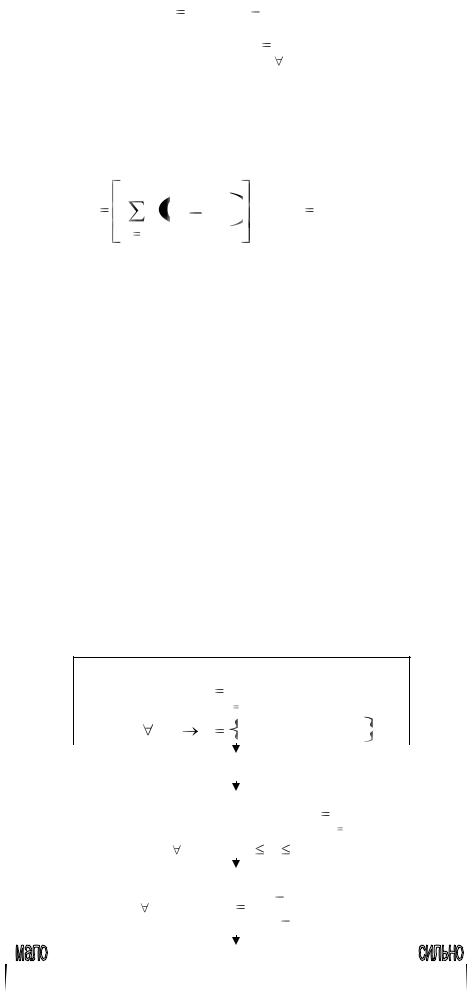
C 2, N гр 1 . В каждом итерационном цикле осуществляется классификация выборки Gгр на C классов и для всех итераций подсчитывается hn - суммарное число включений каждого сообщения в классы KC объемом V C 2
N гр |
1 |
|
hn |
1 |
gn KC &V C , n 1, N гр |
C 2 |
|
|
107
При этом степень достоверности информационного сообщения gn
wn hn /(N гр |
2) . |
Классификацию выборки сообщений Gгр |
gn на заданное число |
|
n |
классов C осуществляется с использованием того или иного адекватного по отношению к сведениям метода «средней связи». Для этого с помощью выбранной метрики, например евклидовой, строят матрицу S взаимных расстояний между сообщениями с элементами матрицы
|
|
|
1/ 2 |
|
|
I исх |
2 |
|
|
smn |
Pim Pin |
, n 1, N гр |
||
|
i 1 |
|
|
|
Далее сообщения классифицируются с использованием гипотезы компактности - сходные сообщения в гиперпространстве сведений располагаются в некотором смысле компактно, т.е. расстояния между сообщениями из одного класса меньше расстояний между центрами классов.
Объем множества Gф отфильтрованных сообщений в значительной мере зависит от установленного значения w0 .
Схема алгоритма информационной фильтрации приведена на рис. 6.1.
Точность моделей, построенных на основе статистических методов в значительной мере зависит от количества учитываемых параметров. Одновременно с увеличением числа параметров значительно возрастают затраты вычислительных ресурсов. Поэтому оптимальный выбор признакового пространства в значительной мере обеспечивает эффективность и качество функционирования алгоритмических схем. Критерием оптимальности является минимизация числа измеряемых параметров при условии обеспечения достаточной информативности выбранной параметрической системы. Степень оптимальности и корректности процедур минимизации определяют надежность и достоверность построенных моделей.
Существует эффективный метод минимизации информативной параметрической избыточности - метод «корреляционных плеяд». Его дальнейшее развитие и машинная адаптация - метод «дискретных корреляционных плеяд». Суть последнего метода заключается в формировании плеяд параметров со значимым признаком сходства и последующей заменой этих плеяд на единственный (головной) параметр, обладающий наибольшим весом по отношению к прочим.
При этом оказывается возможным установить функциональную зависимость каждого из параметров с головным параметром, что позволяет в даль-
Формирование исходной выборки
|
|
|
|
Nисх |
|
|
|
|
|
|
|
|
|
|
G исх |
g n , где |
|
|
|
||||
|
|
|
|
n 1 |
|
|
|
|
|
|
|
|
|
n:gn |
Pn |
1 |
|
2 |
i |
IИСХ |
|
||
|
|
Pn ,Pn ,...,Pn ,...,Pn |
|
||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
i |
i |
|
||
|
Задание допустимых границ Pmin |
,Pmах |
|
||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Nгр |
|
|||
|
Формирование множества |
G гр |
g n , |
|
|||||||
|
|
|
|
|
|
|
n 1 |
|
|||
|
|
где |
n,i: |
i |
i |
i |
|
|
|
||
|
|
P min |
Pn |
Pmax |
|
|
|
||||
|
|
|
|
|
|
|
|
||||
|
|
Нормировка параметров |
|
|
|
||||||
|
|
|
|
|
|
i |
i |
|
|
|
|
|
|
|
|
i |
Pn |
P min |
|
|
|
||
|
|
n,i: |
Pnormn |
|
|
|
|
|
|
|
|
|
|
|
i |
i |
|
|
|
||||
|
|
|
|
|
Pmax |
P min |
|
|
|
||
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Определение степени |
|
|
|
||||||
|
|
|
|
|
|||||||
|
|
"засоренности" выборки |
|
|
|
||||||
|
|
|
|
|
|
|
|
|
|
|
|

108
Рис. 6.1. Схема алгоритма информационной фильтрации
нейшем судить об их значениях.
В задаче (6.2) для множества Pni значений параметров объектов gn
формируется матрица взаимной корреляции, представляющая собой множество значений
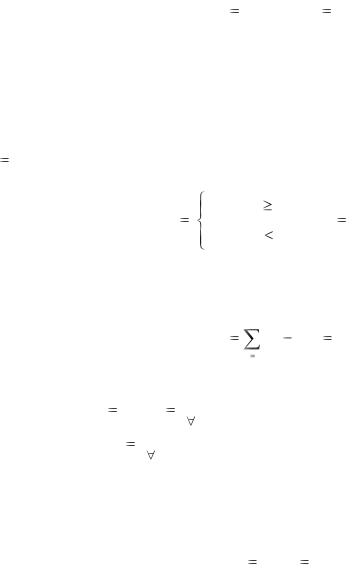
109
|
R |
|
rij , |
|
|
|
|
|
|
|
|||
|
|
i, j 1, I исх |
|
||||||||||
|
|
|
i, j |
|
|
|
|
|
|
|
|
||
где i и j - индексы соответственно строки и столбца матрицы R. |
|
||||||||||||
С использованием критерия Спирмена устанавливается порог значимо- |
|||||||||||||
сти коэффициента корреляции r0 |
и осуществляется преобразование исход- |
||||||||||||
ной матрицы взаимной корреляции R в дискретную корреляционную матри- |
|||||||||||||
цу B b i j по правилу |
|
|
|
|
|
|
|
|
|
|
|
|
|
i, j |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1, |
|
rij |
|
|
r0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
bi j |
|
|
|
, i, j 1, I исх |
(6.13) |
||||||||
0, |
|
rij |
|
r0 |
|||||||||
|
|
||||||||||||
Для каждой строки i полученной таким образом матрицы D подсчиты- |
|||||||||||||
ваются "веса" параметров V i |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
V i |
|
I исх bi j |
|
|
|
|
||||||
|
|
1, i 1, I исх |
|
||||||||||
j1
иопределяется индекс строки im матрицы B для параметров с макси-
мальным весом im i |
|
Vi |
maxi |
V i , причем если существуют несколько па- |
|
||||
раметров с весом V i |
|
maxi |
V i , |
то выбирается первый из них. |
Далее осуществляется формирование im -ой корреляционной плеяды со значимыми дискретными оценками корреляции. В плеяду включаются пара-
метры с индексом j , для которых справедливо |
|
|||
|
|
|
|
|
bim j |
1, j 1, I . |
(6.14) |
||
|
|
|
|
|
Строка с индексом im и столбцы с индексами j |
дискретной корреляци- |
|||
онной матрицы B, определяемыми согласно (14), обнуляются, и процесс формирования плеяд повторяется, начиная с определения значений весов параметров согласно (6.13) до полного обнуления матрицы B.
Данный метод по сравнению с другими методами минимизации информативной избыточности наиболее прост и доступен для алгоритмизации. Его машинная адаптация не является трудоемкой и не влечет за собой значительных вычислительных затрат и ресурсов. Однако ему присущи существенные недостатки, обусловленные следующей причиной: поскольку в данном методе в качестве оценок сходства применяются значения коэффициен-
тов корреляции, то предполагается, что параметры P i объектов g должны
n n
иметь нормальный закон распределения. Данное ограничение является весьма существенным, поскольку зачастую невыполнимо.