Материал: Моделирование, анализ и оценка надежности информационных систем и технологий. Некравцева Т.А., Толстых Т.О
110
Использование в качестве оценок мер сходства непараметрических робастных критериев, например коэффициентов ранговой корреляции Спирмена, также не обеспечивает их адекватности, поскольку данные оценки в ряде случаев являются приближенными.
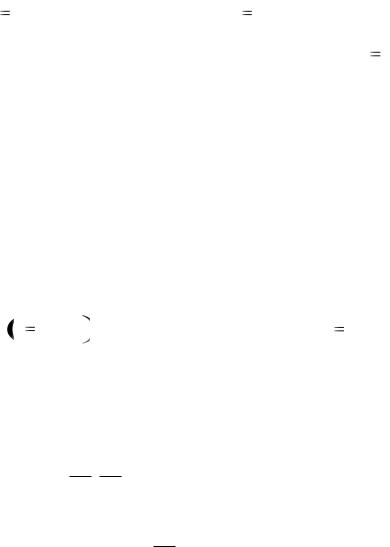
Наиболее естественно для определения меры сходства (различия) воспользоваться геометрическим подходом. В этом случае сходство двух рядов чисел (значений параметров) отождествляется либо с расстоянием между ними, определенным с использованием той или иной метрики, либо со значением некоторой заранее заданной функции над заранее определенной метрикой. Для определения степени сходства (близости) двух рядов чисел
i |
i |
i |
i |
i |
|
j |
j |
|
j |
j |
|
|
j |
|
|
{ p1 |
, p2 |
,..., pn |
,..., p |
|
} и |
{p1 |
, |
p2 |
,..., pn ,..., p |
|
} , представляющих |
||||
Pn |
|
Pn |
|
||||||||||||
|
|
|
|
|
N ф |
|
|
|
|
|
|
|
N ф |
||
|
|
|
|
||||||||||||
собой значения параметров с индексами i и j (i, j |
1, Iисх ) исходного множе- |
||||||||||||||
ства Gф , можно использовать такие метрические преобразования, как рас-
стояние Махаланобиса, евклидово и взвешенное евклидово, хеммингово расстояние. Степень близости при этом определяется путем сопоставления вычисленных расстояний с каким-то заранее определенным пределом. Объекты считаются похожими, если расстояние между ними не превышает этого предела, в противном случае - непохожими. При данном подходе невозможна строгая формализация понятия меры сходства как меры близости, поскольку степень сходства является зависимой как от значений параметров, так и от
значений установленного предела. Например для двух распределений |
i |
|
и |
||||||||||||
Pn |
|||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
j |
|
|
|
|
i |
|
j |
|
|
|
|
|||
|
n |
1, N ф , связанных зависимостью |
|
, где k - константа, при |
|
||||||||||
|
Pn |
Pn |
k Pn |
|
|||||||||||
фиксированном значении предела для разных значений коэффициента будут получены различные оценки сходства, хотя по аналогии с оценками корреляционного сходства они должны совпадать.
Существует другой подход, основанный на вычислении расстояний в признаковом пространстве с помощью некоторых специально устроенных
функций F( Pin, Pnj) , получивших название потенциальных. Эти функции
принимают значение от 0 до 1 в зависимости от «потенциала» объекта |
i |
|
по |
Pn |
|||
отношению к объекту Pnj . Однако, поскольку при этом ограничений на вид потенциальных функций не накладывается и признаковое пространство не фиксировано и не ограничено, полученные оценки не являются наглядными и так же как и в предыдущем случае не допускают эталонирования меры сходства.
111
Рассмотрим простую процедуру вычисления оценок степени сходства, свободную от указанных недостатков.
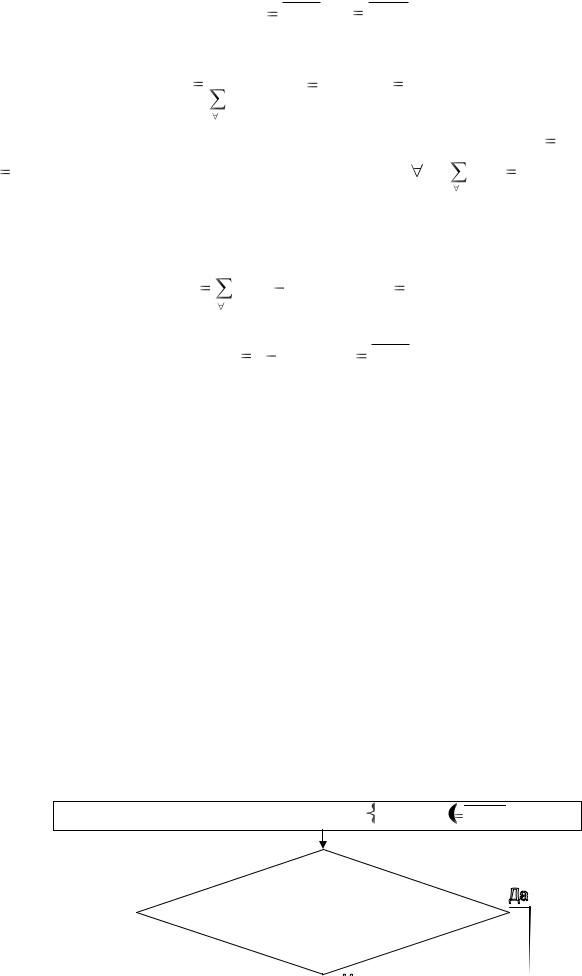
1. Значения признаков Pin (i 1, Iисх , n 1, N ф ) сводятся к единице в целях ограничения и фиксации признакового пространства:
|
|
|
i |
|
|
|
|
|
|
|
|
|
|
|
|
|
i |
Pn |
|
|
|
|
|
|
|
|
|
|
|
|
|
, |
i 1, Iисх , n 1, |
N ф |
, |
|
|
|
||||||
|
|
Pнn |
|
|
|
|||||||||
i |
|
|
|
|||||||||||
|
|
|
Pn |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
n |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||
|
т.е. формируются дискретные распределения признаков Pнin (i 1, Iисх , |
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
i |
|
|
|
n 1, N ф ) с суммарными весами, равными единице ( |
|
|
1,). |
|
|
|||||||||
i : |
Pнn |
|
|
|||||||||||
n
2. Аналогично расстоянию по Хэммингу определяется интегральная разница в значениях нормированных признаков распределений по каждой паре:
|
|
i |
j |
|
|
|
sij |
|
, (i, j 1, Iисх ). |
||||
n |
Pнn |
Pнn |
||||
|
|
|
|
|
|
|
3. По каждой паре признаков вычисляется значение степени сходства
qij 1 sij , (i, j 1, Iисх ).
Следует отметить, что коэффициент сходства q в основном аналогичен коэффициенту корреляции. В зависимости от значений признаков он принимает значения от -1 (что эквивалентно утверждению типа «абсолютно противоположен») до +1 (что эквивалентно утверждению типа «абсолютно поход»). Нулевое значение коэффициента q следует интерпретировать как абсолютную непохожесть, т.е. полное отсутствие какого либо сходства.
Данная аналогия позволяет осуществить эквивалентную замену в методе дискретных корреляционных плеяд коэффициента корреляции на приведенную непараметрическую оценку степени сходства.
На рис. 6.2 приведена схема алгоритма исключения параметрической избыточности.
Выбор исходного набора показателей Pi= P1i ,...,PNi ф  i 1,I ИСХ

Значения показателей Pi имеют нормальный Закон распределения?
112
Рис. 6.2. Схема алгоритма исключения параметрической избыточности.
6.2. Оценка значимости факторов на основе метода множественной корреляции
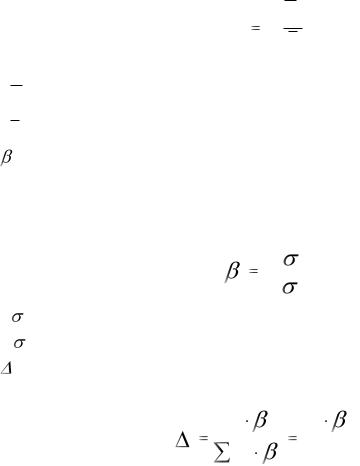
113
Сравнительная оценка значимости нескольких факторов по степени их влияния на моделируемый показатель возможна с использованием метода множественной корреляции. На первом этапе строится линейная регрессионная модель, связывающая набор независимых переменных (факторов) и зависимую переменную (моделируемый показатель). По значениям коэффициентов регрессионного уравнения можно сделать заключение об абсолютном вкладе каждого показателя в изменение зависимой переменной, но из-за того, что, как правило, оцениваемые факторы имеют различные единицы измерения, сравнительная их оценка затруднена. Для сравнения оценок влияния каждого фактора на формирование моделируемого показателя рассчитываются следующие относительные величины:
1) коэффициенты эластичности (Эj), показывающие, на сколько процентов в среднем изменяется моделируемый показатель (y) с изменением признака-фактора xj на один процент при фиксированном положении других факторов:
Эj a j xyj ,
где aj – коэффициент регрессии при j-м факторе; x j – средне значение j-го фактора;
y– среднее значение зависимой переменной.
2)-коэффициенты, позволяющие сравнить влияние колеблемости различных факторов на вариацию исследуемого показателя и выявить факторы,
вразвитии которых заложены наибольшие резервы изменения результативного показателя:
j a j |
j |
, |
|
y |
|||
|
|
где j – среднеквадратическое отклонение для j-го фактора;
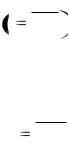
y – среднеквадратическое отклонение зависимой переменной. 3) -коэффициенты, оценивающие долю влияния каждого фактора в
суммарном влиянии факторов:
|
r jy |
j |
r jy |
j , |
|
j |
r jy |
j |
R2 |
||
|
|||||
|
j |
|
|
|
где rjy – коэффициент парной корреляции между j-м фактором и моделируемым показателем;
R2 – коэффициент детерминации для полученной регрессионной
114
зависимости; Определение приоритетности факторов основывается на сравнении пе-
речисленных коэффициентов. Для облегчения интерпретации полученных результатов проводится ранжирование факторов по величине каждой группы коэффициентов и рассчитывается средний ранг.
6.3. Построение математических моделей с использованием
регрессионного анализа
Регрессионный анализ может быть использован как для аппроксимации результатов имитационного моделирования, так и при обработке архивной информации с целью выявления зависимости между моделируемым показателем и набором воздействующих факторов.
Алгоритм построения регрессионных моделей состоит из следующих этапов.
1. На основе опроса экспертов определяется набор показателей X i
i 1, N , которые позволяют полностью идентифицировать состояние объ-
екта, а также, при необходимости, учесть индивидуальную неоднородность объектов.
2. Выделяется один или несколько контролируемых показателей  j 1, M
 , изменение которых необходимо спрогнозировать.
3. В результате проведения дисперсионного анализа определяется, имеет ли место изменение выбранных контролируемых показателей Y j в
процессе воздействия на объект.
4.Для отбора достоверных измерений производится фильтрация информации.
5.Осуществляется оптимальный выбор признакового пространства за счет исключение параметрической избыточности.
6.Проверяется гипотеза о нормальном распределении значений показателей X i .
7.Производится выбор вида регрессионной модели (линейная, неполная квадратичная, квадратичная).
8.Вычисляются оценки коэффициентов уравнения регрессии.
9.Выполняется проверка их значимости и исключаются из модели незначимые коэффициенты.