Материал: Моделирование, анализ и оценка надежности информационных систем и технологий. Некравцева Т.А., Толстых Т.О
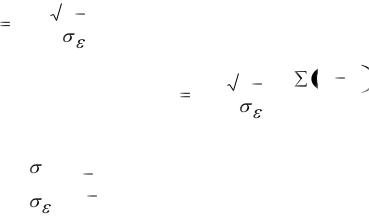
120
Показатели регрессии и корреляции - параметры уравнения регрессии, индексы или коэффициенты детерминации и корреляции, исчисленные для ограниченой по объему совокупности, могут быть искажены действием случайных факторов. Поэтому нужно проверить, насколько показатели характерны для того комплекса условий. в которых находится исследуемая совокупность, не являются ли они результатом стечения случайных обстоятельств. Проверка значимости (существенности) показателей регрессии и корреляции производится с помощью t- критерия (Стьюдента), дисперсионного F-критерия (Фишера):
t |
|
b |
* |
|
|
n |
2 |
|
, |
|
|
|
|
|
|
|
(6.24) |
||||
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||
|
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
xi |
x |
2 |
|
|
|
|
|
|
|
|
|
|
|
|
|
ti bi * |
|
n |
2 |
|
* |
; |
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
n |
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
(6.25) |
||
|
|
|
|
2 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
F = |
|
y |
* |
n |
m |
, |
|
|
|
|
|
|
(6.26) |
||||||
|
|
|
2 |
n |
1 |
|
|
|
|
|
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||
где m - число параметров в уравнении регрессии.
Вычисленные по этим формулам значения t сравниваются затем с критическими их значениями при принятом уровне значимости и числе степеней свободы k=n-2. Критические значения t находятся по таблице распределения Стьюдента.
Расчетное значение F сравнивается с критическим (табличным) для принятого уровня значимости и чисел степеней свободы k1=n-1, k2=n-m. Если Fрасч>Fкр, то гипотеза об адекватности модели данным эксперимента принимается.
Оценка значимости коэффициентов регрессии с помощью критерия t часто используется для завершения отбора факторов в процессе шагового анализа. Наиболее известны две процедуры, которые реализованы в прикладных пакетах: последовательное увеличение и последовательное уменьшение группы независимых переменных. Например, последовательное уменьшение заключается в том, что после решения модели и оценки значимости всех коэффициентов регрессии из модели исключается тот фактор, коэффициент при котором незначим и имеет наименьший коэффициент доверия t. После этого модель пересчитывается и снова производится оценка значимости всех коэффициентов регрессии. Если среди них опять окажутся незначимые, то снова исключается фактор с наименьшим коэффициентом t.
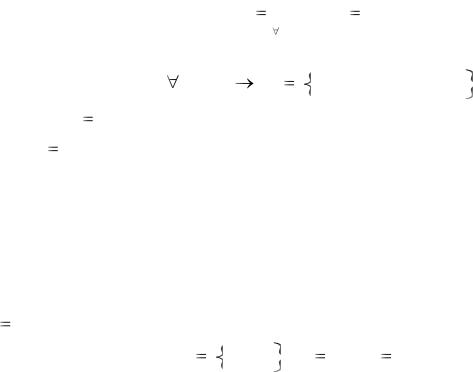
121
Процесс исключения факторов продолжается до тех пор, пока не будет получено уравнение регрессии, все коэффициенты в котором значимы. Пошаговая регрессия применяется для минимизации количества независимых переменных, входящих в исследуемую модель.
6.4. Построение формализованных моделей на основе методов кластерного анализа
Для решения задач прогнозирования и выбора адекватных управляющих воздействий предлагается использовать формализованные модели, позволяющие в понятной и доступной форме представить различные классы объектов.
Постановка задачи моделирования имеет следующий вид. Имеется исходное множество объектов
|
|
|
|
|
G |
gn |
|
|
|
|
|
|
|
|
(n 1, N ) . |
||||
|
|
|
|
|
|
n |
|
|
|
Каждый объект характеризуется набором показателей: |
|||||||||
|
|
|
|
|
n : gn |
Pn |
P1n , Pn2 ,..., Pin ,..., PnI , |
||
где |
|
i 1, I - индекс показателя, |
|
|
|
||||
|
|
|
|
||||||
n |
1, N - порядковый номер объекта. |
||||||||
Таким образом, каждому объекту соответствует точка в гиперпро- |
|||||||||
странстве признаков (показателей) Pi . Каждому элементу gn множества G ставится в соответствие лингвистическая переменная ln (тип объекта).
Построение формализованных моделей заключается в разбиении мно-
жества объектов на однородные группы. Модель каждой группы |
M j |
||||||
|
|
|
|
|
|
|
|
j 1, J описывается следующим образом: |
|
||||||
|
|
|
|
|
|
||
|
|
M j Zij , Lj , i |
1, I |
, j |
1, J |
, |
(6.27) |
где Z ij - значение параметров модели (эталон параметров),
L j - лингвистическое описание модели (класс объектов).
Для решения этой задачи предлагается два подхода: первый из них основан на прямой обработке статистической информации, второй - на классификационном методе.
122
При прямой обработке статистических данных критерием для классификации является значение лингвистической переменной ln . Число классов
(J) соответствует количеству возможных типов объектов для данной группы объектов (множества G).
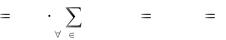
Параметры модели рассчитываются следующим образом:
L j - определено однозначно для каждой группы (критерий классифи-
кации);
i 1 |
i |
|
|
|
|
||
, i 1, I , j 1, J , |
|||||||
Z j |
|
Pn |
|||||
N j |
|||||||
|
n G j |
|
|
|
|
||
где Gj - множество объектов, вошедших в j-ю группу; N j - количество объектов, вошедших в j-е множество.
Данный метод хотя очень прост, но из-за большого количества рутинных операций весьма трудоемок. В результате субъективной оценки пара-
метров l значительна вероятность ошибки при разбиении исходного множе-
j
ства на группы и как следствие - вероятность неточной оценки параметров модели.
Подход, основанный на классификационном методе (кластерном анализе), лишен этих недостатков. В данном случае построение процедур классификации основано на минимаксном критерии. Суть данного метода заключается в интуитивном представлении понятия класса. Объекты объединяются в классы по следующему признаку: объекты внутри класса более «похожи» (более близки), чем объекты из различных классов.
Критерий качества кластеризации в той или иной мере отражает следующие неформальные требования:
а) внутри групп объекты должны быть тесно связаны между собой; б) объекты разных групп должны быть далеки друг от друга; в) при прочих равных условиях распределения объектов по группам
должны быть равномерными.
Узловым моментом в кластерном анализе считается выбор метрики (или меры близости объектов), от которого решающим образом зависит окончательный вариант разбиения объектов на группы при заданном алгоритме разбиения.
Для определения степени близости между объектами для различных типов данных могут быть использованы следующие показатели.
1. Для количественных шкал используется линейное расстоя-
ние
123
|
|
|
|
|
|
|
|
|
|
|
I |
|
Pai Pbi |
|
|
|
|
|
|
|
|
|
|
|
|
d Lab |
|
, |
|
|
|
|
|
|
|
|
|
|
|
|
i |
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
(6.28) |
||
евклидово расстояние |
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
|
I |
|
|
|
|
1/2 |
|
|
|
|
|
|
|
|
|
|
|
|
Pbi 2 |
|
|
|
|
|
|
|
|
|
d Eab |
|
Pai |
|
, |
(6.29) |
|||||
|
|
|
|
|
|
i 1 |
|
|
|
|
|
|
|
|
обобщенное степенное расстояние Минковского |
|
|
|
|||||||||||
|
|
|
|
|
|
I |
|
|
|
1/ p |
|
|
|
|
|
|
|
|
|
|
|
|
|
p |
|
|
|
|
|
|
|
|
d Pab |
Pai |
|
Pbi |
|
(6.30) |
||||||
|
|
|
|
|
i |
1 |
|
|
|
|
|
|
|
|
или расстояние Махаланобиса |
|
|
|
|
|
|
|
|
||||||
|
|
|
|
|
~i |
~i |
T |
W |
1 |
~i |
~i |
(6.31) |
||
|
|
|
d Mij ( Pa |
Pb) |
|
|
( Pa |
Pb) , |
||||||
i |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
где Pa(b) |
- значение i-го показателя у a(b)-го объекта, |
|
|
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
i 1, I , a,b 1, N , |
|
|
|
|
|
|
|
|
|
|||||
~i |
- вектор-столбец значений всех показателей на a(b) - ом объ- |
|||||||||||||
Pa (b ) |
||||||||||||||
екте,
W 1 - матрица, обратная ковариационной.
2. Для качественных шкал используется коэффициент Хемминга
h |
Sab / I , |
(6.32) |
ab |
где S ab - общее число совпадающих значений свойств (нулевых и еди-
ничных: 1 - наличие свойства, 0 - отсутствие).
Если из содержательных соображений не следует предпочтительность той или иной шкалы для каждого показателя, надо перейти к нормированным данным. При этом необходимо максимально учитывать качественную специфику показателей и выбирать соответствующий способ нормировки. Если имеется возможность, нормировку производить по величинам, не зависящим от выборки: (6.21)-(6.23).
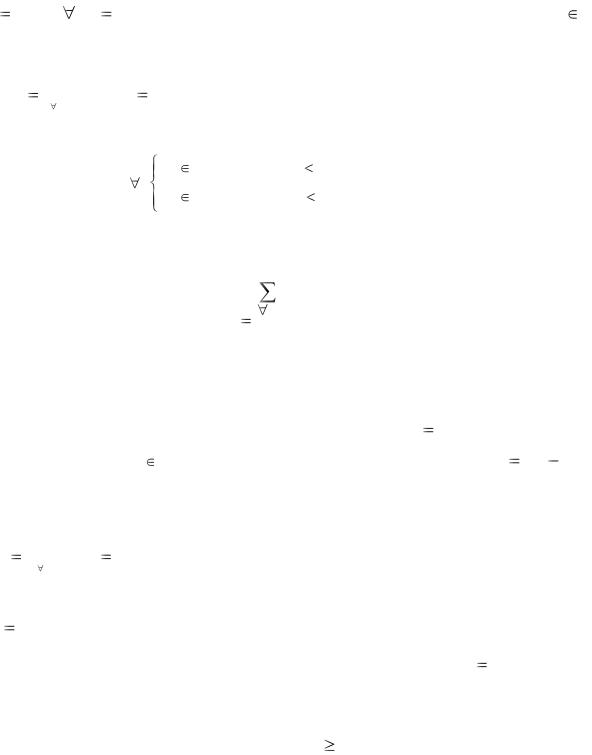
В случае различной значимости отдельных показателей Pi (i 1, I ), следует произвести корректировку нормированных величин с учетом степени значимости каждого показателя. Степень значимости wi (i 1, I ) опреде-
ляется на основе экспертных оценок, и должна находиться в диапазоне [0..1].
124
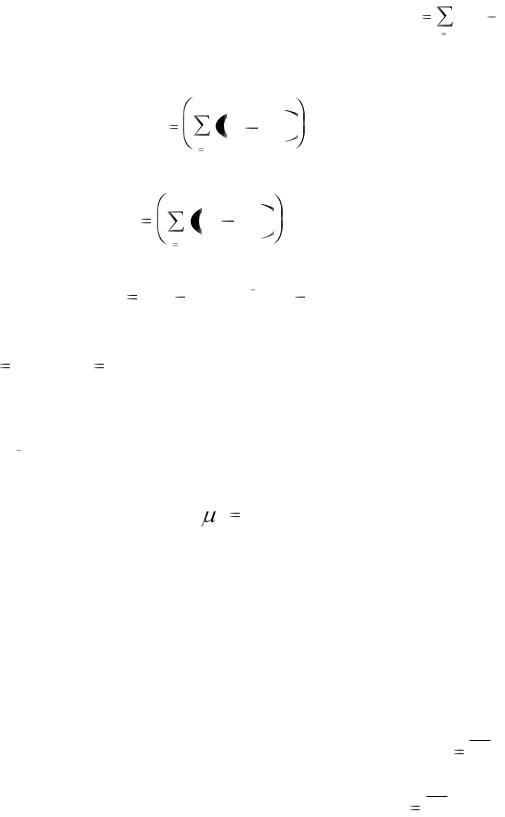
Количество групп для классификации устанавливается равным J, где J - число различных значений лингвистической переменной lj , соответствую-
щей исходной выборке (множество G). |
|
|
|
|
|
|
||||||||||||
|
|
Классификация осуществляется следующим образом: |
|
|
||||||||||||||
|
|
1. |
С использованием той или иной, адекватной по отношению к сведе- |
|||||||||||||||
ниям метрики (6.28 – 6.32), вычисляется матрица взаимных расстояний |
|
|
||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|||||||||
S |
|
|
( |
i, j 1, N ) между всеми информационными сообщениями g |
|
G . |
||||||||||||
|
ij |
|
|
|
|
|
|
|
|
|
|
|
|
|
n |
|
||
|
|
s |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
i , j |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
2. |
Выбираются объекты gk1 |
и gk2 |
, для которых выполняется условие |
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
Sk1k 2 |
maxi , j |
Sij (i, j |
|
|
1, N ). |
|
|
|
|
|
|
|
|
|||||
|
|
3. |
Производится разбиение множества G на два подмножества Gk1 |
и |
||||||||||||||
Gk 2 |
по правилу: |
i: |
|
gi |
Gk1 |
, если Sik1 |
Sik 2 |
. |
|
|
|
|
||||||
|
gi |
Gk 2 |
, если Sik 2 |
Sik1 |
|
|
|
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
|
|
4. |
Рассчитываются параметры классов Zik1 |
и Zik 2 |
, которые устанавли- |
|||||||||||||
ваются равными среднему значению параметров, вошедших в каждый класс:
|
|
|
|
|
|
|
|
|
Ptt |
j |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
i |
t j |
|
, |
j=1,2 , |
|
|
|
(6.33) |
||
|
|
|
|
|
|
|
|
Z j |
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
N j |
|
|
|
|
||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
где t j - множество объектов, вошедших в j-й класс, |
|
|
|
|
|
|
||||||||||
|
|
|
|
N j - количество объектов, вошедших в j-й класс. |
|
|
|
|
|
|
||||||||
|
5. |
Вычисляется вектор суммарных расстояний S {s1 ,s2 ,...,sn ,...,sN} от |
||||||||||||||||
каждого объекта gn |
G до точек mj , имеющих параметры Zij , |
|
|
|
|
|
|
|||||||||||
|
j |
1,c 1 (c - |
||||||||||||||||
1 - количество сформированных классов). |
|
|
|
|
|
|
|
|||||||||||
|
6. |
Выбирается объект gkc , для которого выполняется условие |
||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
s |
|
max Si , i 1, N . |
|
|
|
|
|
|
|
|
|
|
|
|
||||
k c |
|
|
i |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
7. |
Производится разбиение множества G на с подмножеств Gk j |
||||||||||||||||
|
|
|
|
|
- расстояние от объекта gi до точки mj |
|
|
|||||||||||
( j |
1,c ) по правилу |
( Sik j |
). |
|
||||||||||||||
|
|
По формуле (6.33) рассчитываются параметры Zij ( j |
|
|
|
|||||||||||||
|
8. |
1,c) сформи- |
||||||||||||||||
рованных классов. |
|
|
|
|
|
|
|
|
|
|
|
|
||||||
|
9. |
Вычисления, описанные в п.5-8 выполняются до тех пор, пока не |
||||||||||||||||
станет истинным логическое выражение c |
J . |
|
|
|
|
|
|
|||||||||||