Материал: Моделирование, анализ и оценка надежности информационных систем и технологий. Некравцева Т.А., Толстых Т.О
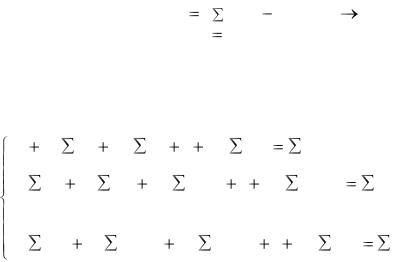
115
10. Проверяется адекватность модели. В случае адекватности модели - окончание алгоритма. Если модель неадекватна, но возможно ее усложнение - переход к п.7, в противном случае необходима корректировка исходной выборки (увеличение ее объема, сокращение числа неточных измерений).
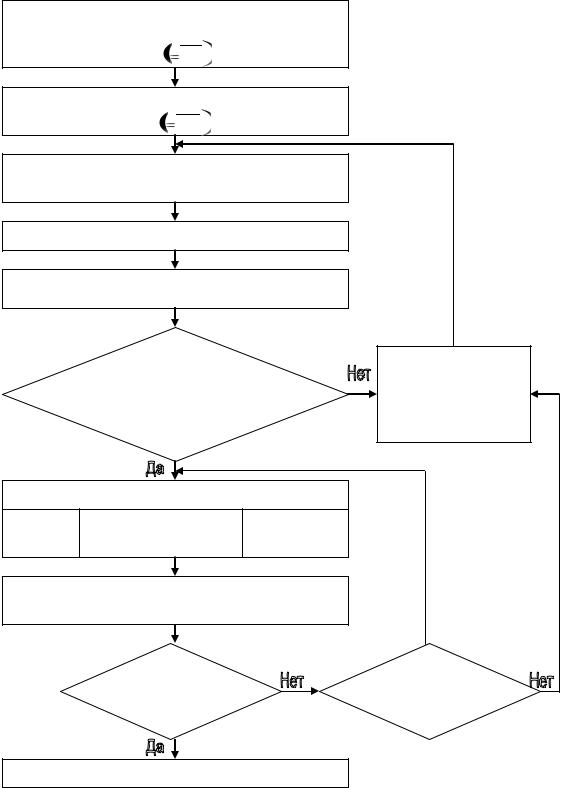
Схема алгоритма построения прогностических моделей приведена на рисунке 3.
Построение уравнений множественной регрессии часто производится путем так называемого пошагового (многошагового) анализа, в процессе которого производится формирование модели и с помощью статистикоматематических критериев завершается отбор факторов и уточняется форма связи каждого фактора с результативным признаком.
Определение числовых значений параметров уравнения множественной регрессии обычно производится методом наименьших квадратов, для чего строится и решается система нормальных уравнений.
Критерий метода наименьших квадратов можно записать таким обра-
зом:
S |
n ( yi |
yi (x))2 min |
i |
1 |
|
Для линейной множественной регрессии
Y( x1 , x2 ,..., xm) =b0+b1x1+b2x2+b3x3+...+bmxm
система нормальных уравнений такова:
b |
b |
|
x |
b |
x |
2 |
... bm |
|
xm |
|
y, |
|
|
|
|
||
0 |
1 |
1 |
2 |
|
|
|
|
|
|
|
|
|
|
|
|
||
b |
x |
|
b |
x2 |
b |
x x |
2 |
|
... b |
|
x x |
m |
yx , |
|
|
||
0 |
1 1 |
1 |
|
2 1 |
|
|
m |
1 |
1 |
|
(6.15) |
||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
......................................................................................... |
|||||||||||||||||
b |
x |
m |
b |
x x |
m |
b |
x |
2 |
x |
m |
... |
b |
x2 |
yx |
m |
. |
|
0 |
|
1 1 |
2 |
|
|
|
m m |
|
|
||||||||
Коэффициенты при xi в уравнении множественной линейной регрессии показывают, на сколько в среднем изменяется результативный признак при увеличении соответствующего фактора на единицу и при фиксированном (постоянном) значении других факторов, входящих в уравнение регрессии.
116
Формирование множества показателей, идентефицирующих состояние объекта
Xi i 1,N
Выбор контролируемых показателей
Yi i 1,M
Проведение дисперсионного анализа для оценки качества показателей Yi
Фильтрация информации
Выбор оптимального Признакового пространства
Гипотеза о нормальном |
Корректировка |
распределении показате- |
|
лей Xi подтверждена ? |
исходного |
|
множества |
Выбор вида модели
линейная неполная квадратичная квадратичная
Вычисление оценок коэффициентов уравнения регрессии
Модель |
Возможно |
|
усложнение |
||
адекватна? |
||
модели? |
||
|
||
Вывод модели |
|
Рис. 6.3. - Схема алгоритма построения регрессионных моделей
117
Величина совокупного коэффициента корреляции по значениям парных коэффициентов может быть определена следующим образом:
|
|
|
|
r10 |
r20 |
... |
rm0 |
|
|
|
|
||
|
|
|
1 |
|
|
|
|
|
|||||
|
|
|
r10 |
1 |
r21 |
... |
rm1 |
|
|
|
|
||
|
|
|
r20 |
r12 |
1 |
... |
rm2 |
|
|
|
|
||
|
|
|
... |
|
... |
... ... ... |
|
|
|
|
|||
R2 1 |
|
|
r0m |
r1m |
r2m |
... |
1 |
|
|
. |
(6.16) |
||
|
|
|
|||||||||||
|
|
|
1 |
r21 ... |
rm1 |
|
|
|
|||||
|
|
|
|
||||||||||
|
|
|
|
|
|
||||||||
|
|
|
|
r12 |
1 ... |
rm2 |
|
|
|
||||
|
|
|
... |
|
... ... ... |
|
|
|
|
|
|
||
|
|
|
|
r1m r2m ... |
1 |
|
|
|
|
|
|
||
Величина R2, называемая коэффициентом детерминации, показывает, в какой мере вариация результативного признака обусловлена влиянием при- знаков-факторов, включенных в рассматриваемое уравнение корреляционной зависимости.
Величина совокупного коэффициента корреляции изменяется в пределах от 0 до 1 и численно не может быть меньше, чем любой из образующих его парных коэффициентов корреляции. Чем ближе совокупный коэффициент корреляции к единице, тем меньше роль неучтенных в модели факторов и тем больше оснований считать, что параметры регрессионной модели отражают степень эффективности включенных в нее факторов.
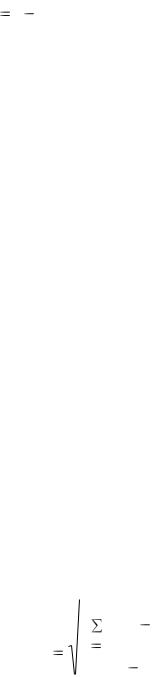
Иногда рассеяние точек корреляционного поля настолько велико, что нет смысла пользоваться уравнением регрессии, так как погрешность в оценке анализируемого показателя будет чрезвычайно велика. Для всей совокупности наблюдаемых значений рассчитывается средняя квадратическая ошибка уравнения регрессии Se, которая представляет собой среднее квадратическое отклонение фактических значений yi , относительно значений, рассчи-
танных по уравнению регрессии y |
, т. е. |
|
||||||||
|
|
|
|
i |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
n |
( y |
i |
y |
i |
)2 |
|
|
|
|
|
i |
1 |
|
|
|
|
|
||
Se |
|
|
|
|
, |
(6.17) |
||||
|
n |
|
m |
|
|
|||||
|
|
|
|
|
|
|
|
|
||
где Se - средняя квадратическая ошибка уравнения регрессии;
118
yi - фактические значения результативного признака, полученные
по данным наблюдения;
yi - значения результативного признака, рассчитанные по уравне-
нию корреляционной связи и полученные подстановкой значений факторного признака xi в уравнение регрессии;
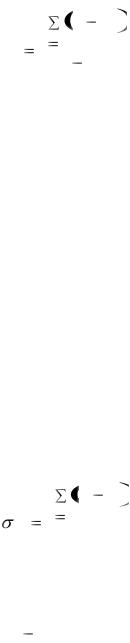
m - число параметров в уравнении регрессии. А также определяется стандартная ошибка:
|
n |
yi |
|
yi |
|
|
Еstd. |
i |
1 |
|
|
. |
(6.18) |
|
n |
m |
|
|||
|
|
|
|
|
||
Чем меньше рассеяние эмпирических точек вокруг прямой, тем меньше средняя квадратическая ошибка уравнения. Таким образом, величина Se служит показателем значимости и полезности модели, выражающей соотношение между признаками.
Проверка адекватности модели - одна из важнейших процедур регрессионного анализа, поскольку исследователь должен удостовериться в том, что практическое использование полученной модели приведет к положительным результатам. При выборе структуры модели стремятся к тому, чтобы она была как можно проще, т.е. включала как можно меньше коэффициентов. Это так называемый принцип экономичности модели.
Сокращение числа коэффициентов облегчает как процедуру оценивания, так и использование модели.
После построения модели (уравнения регрессии) ее необходимо оценить и проанализировать.
Важное место при оценке модели занимает измерение тесноты связи. Общая дисперсия
|
n |
yi y 2 |
|
|
2 i |
1 |
(6.19) |
||
y |
|
n |
||
|
||||
|
|
|
||
является мерой колеблемости фактических (эмпирических) значений признака у около их средней величины. Она характеризует общую вариацию результативного признака у, объясняемую влиянием всех факторов, от которых он зависит. Отклонения yi y объясняются тем, что сочетание значений
факторов, влияющих на у, у каждой единицы совокупности является индивидуальным, различным.
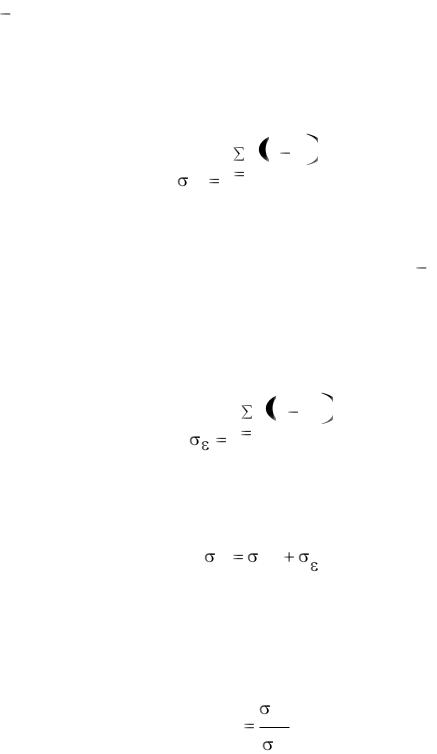
119
Кроме общей дисперсии, на основе уравнения регрессии и отклонений yi y можно вычислить средний квадрат этих отклонений, т.е. средний
квадрат отклонений теоретических значений yi , рассчитанных по уравнению регрессии, от их средней величины (средняя величина yi равна общей сред-
ней y ):
|
n |
|
|
|
|
y y 2 |
|
|
|
2 |
i 1 i |
. |
(6.20) |
|
y |
n |
|||
|
|
|||
|
|
|
||
Это - мера колеблемости теоретических значений признака около сред- |
||||
ней величины (факторная дисперсия). |
|
|
||
На основе уравнения регрессии и отклонений yi |
yi можно также вы- |
|||
числить средний квадрат этих отклонений, т. е. средний квадрат отклонений фактических значений результативного признака от теоретических его значений, полученных путем подстановки в уравнение регрессии соответствующих значений признака-фактора:
|
n |
|
|
2 |
|
|
|
y |
|
y |
|
|
|
2 i 1 |
i |
|
i |
|
||
|
|
|
|
|
. |
(6.21) |
|
|
n |
|
|
||
|
|
|
|
|
|
|
Это - мера колеблемости фактических значений у около соответствующих теоретических значений, т. е. около линии регрессии (остаточная дисперсия). В математической статистике
2 |
2 |
2. |
(6.22) |
y |
y |
|
|
Для измерения тесноты связи между у и х логично поэтому использовать отношение факторной дисперсии к общей дисперсии результативного признака. Это отношение называется теоретическим индексом детерминации
(i2):
2
i2 2y . (6.23) y
Теоретический индекс детерминации показывает, какая часть общей вариации результативного признака-фактора у объясняется признакомфактором х, входящим в соответствующее уравнение регрессии.
В качестве показателя тесноты связи используется также квадратный корень из индекса детерминации, называемый индексом корреляции (i).