Материал: Моделирование, анализ и оценка надежности информационных систем и технологий. Некравцева Т.А., Толстых Т.О
|
|
|
|
|
|
|
|
|
55 |
|
1 |
|
|
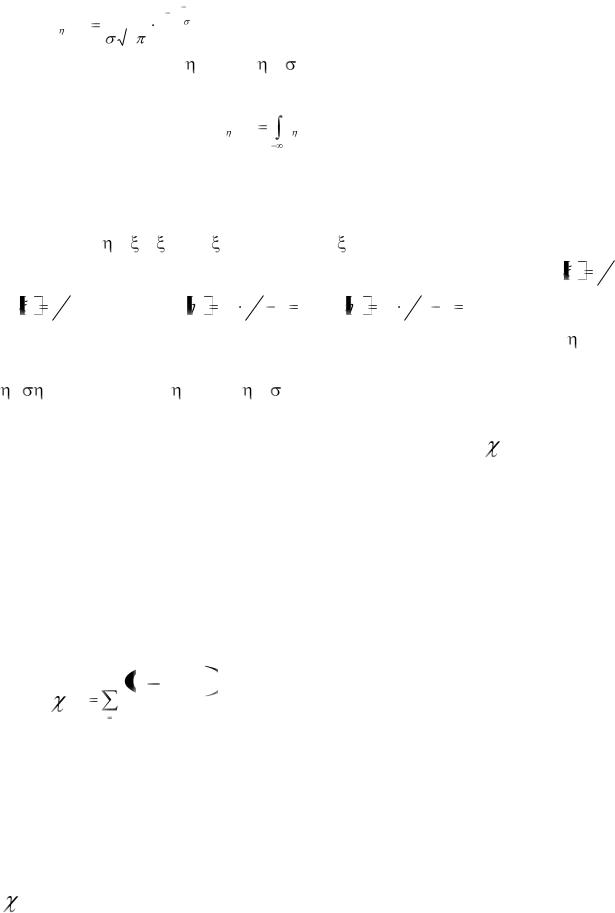
( x m)2 |
|
|
|
||
f (x) |
|
e |
2 |
2 |
. |
|
|
||
|
|
|
|
|
|
|
|||
2 |
|
|
|
|
|||||
|
|
|
|
|
|
|
|
||
Известно, что М[ |
]=m, D[ |
]= |
2. |
||||||
|
|
|
|
|
|
|
|
x |
|
Поскольку интеграл F (x) |
f |
(t)dt |
|||||||
в данном случае не выражается через элементарные функции, теорема 1 не позволяет получить экономный метод моделирования нормально распределенных чисел.
|
Пусть |
0= 1+ 2+…+ 12 – 6, где СВ |
i – независимы и равномерно рас- |
|||||||||||||
пределены |
на отрезке |
[0,1]. |
С |
учетом |
того, |
что |
для |
всех i |
M |
i |
1 |
2 |
, |
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
D i |
1 |
, получим M 0 |
12 |
1 |
2 |
6 0, D |
0 12 |
1 |
0 |
1. |
|
|
|
|
|
|
|
12 |
|
|
|
|
|
|
12 |
|
|
|
|
|
|
|
|
|
По центральной предельной теореме теории вероятностей СВ |
0 |
рас- |
|||||||||||||
пределена по близкому к нормальному |
закону. То же верно |
и |
для |
СВ |
||||||||||||
= |
0+m, причем М[ ]=m, D[ |
]= |
2. |
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
2 |
|
|
|
|
|
|
Проверка качества случайных чисел по критерию |
|
|
|
|
|
||||||||||
Для проверки соответствия опытных данных заданному закону распределения можно оценить близость частот, с которыми данные попадают в некоторые интервалы, к вероятностям попадания в эти интервалы значений случайной величины, вычисленным в соответствии с заданным законом распределения.
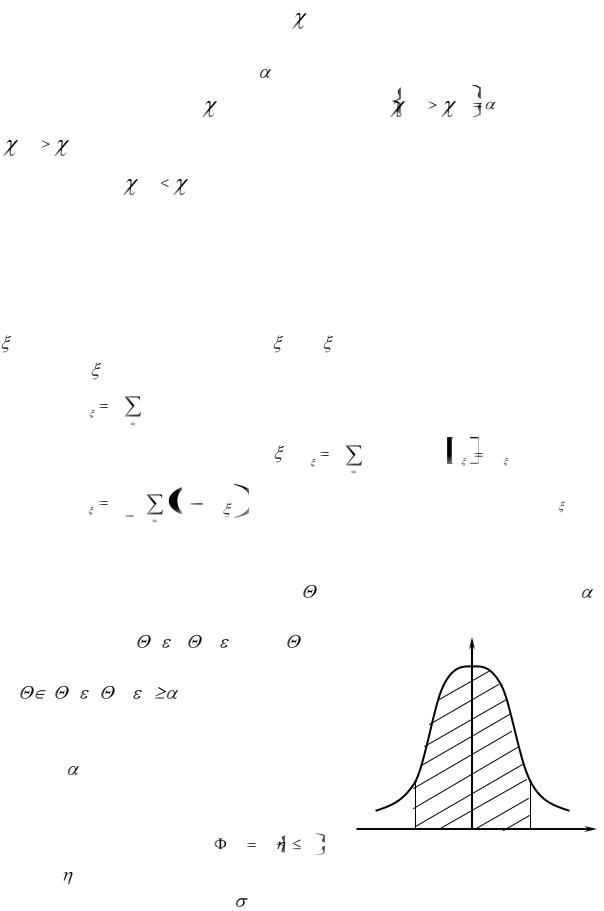
Численной мерой близости теоретической (f) и статистической (f*) плотности распределения служит величина
2 |
I |
ni |
N pi |
2 |
, |
|
набл |
i 1 |
|
N p |
|
|
|
|
|
|
|
|||
|
|
i |
|
|
||
|
|
|
|
|
|
|
где N - количество наблюдений; |
||||||
I |
- число интервалов разбиения; |
|||||
ni - количество наблюдений, попавших в i-й интервал;
pi - вероятность попадания СВ в i-й интервал в соответствии с заданным законом распределения.
Если гипотеза о заданном законе распределения справедлива, то число
2 |
является одним из значений случайной величины, распределенной по |
|
набл
56
закону, близкому к распределению 2 с k=I-s степенями свободы (s - число оцениваемых по опытным данным параметров закона распределения). Для
заданного уровня значимости |
по статистическим таблицам выбирается |
|||||
критическое значение |
2 , из |
условия |
P |
2 |
2 |
, т.е. событие |
|
кр |
|
|
набл |
кр |
|
2 2 маловероятно в случае справедливости гипотезы о законе распре-
набл кр
деления. При
предположению.
2 2 считаем, что данные не противоречат сделанному
набл кр
Точность статистических оценок
Теорема 2. Пусть x1, x2, ..., xn - результаты n независимых измерений СВ , т.е. значения независимых СВ 1, ..., n, распределенных по тому же зако-
ну, что СВ . Тогда
|
1) |
* |
1 n |
|
|
является значением несмещенной статистической оцен- |
|||||||||||||
|
m |
|
|
|
xi |
||||||||||||||
|
|
|
|||||||||||||||||
|
|
|
n i 1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
* |
|
1 n |
* |
|
|
|
||
ки математического ожидания СВ |
|
m |
|
|
xi , т.е. |
M m |
m . |
|
|
||||||||||
|
|
|
|
||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
n i 1 |
|
|
|
|
|
|
|
D* |
1 |
|
n |
|
m* 2 |
|
|
|
|
|
|
|
|
|
|
||
|
2) |
|
|
xi |
- значение несмещенной оценки для D . |
|
|
||||||||||||
|
n |
1 i 1 |
|
|
|||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
Несмещенность статистической оценки означает, что в среднем оценка |
||||||||||||||||||
равна оцениваемому параметру. |
|
|
|
|
|
|
|
|
|
||||||||||
|
Доверительным интервалом |
с доверительной вероятностью |
на- |
||||||||||||||||
зывается такой интервал со случайны- |
|
|
|
|
|
|
|
||||||||||||
|
|
|
|
|
|
|
|||||||||||||
ми |
границами [ |
*- ; |
*+ ], |
где |
* - |
|
|
|
|
у |
|
|
|||||||
статистическая оценка параметра, что |
|
|
|
|
|
|
|
||||||||||||
p{ |
[ |
*- ; |
*+ ]} |
, т.е. интервал на- |
|
|
|
|
|
|
|
||||||||
крывает истинное значение оценивае- |
|
|
|
|
|
|
|
||||||||||||
мого параметра с вероятностью не |
|
|
|
|
|
|
|
||||||||||||
меньше . |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
Функцией |
|
Лапласа |
называется |
|
|
|
|
|
|
|
||||||||
нечетная функция, при неотрицатель- |
|
|
|
|
|
|
|
||||||||||||
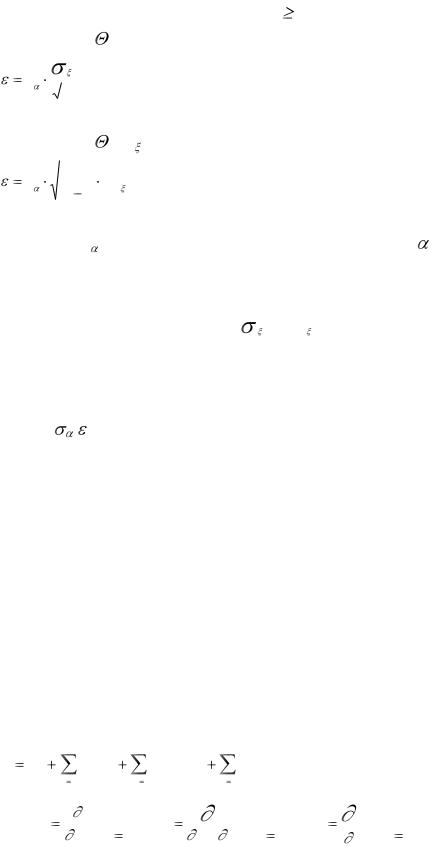
ных t определяемая как |
(t) |
p |
|
t , |
|
|
-t |
0 |
t |
х |
|
||||||||
|
|
|
|
||||||||||||||||
где СВ |
распределена по нормальному |
|
|
|
|
|
|
|
|||||||||||
|
|
|
|
|
|
|
|||||||||||||
закону с параметрами m=0 и |
=1. |
|
|
|
|
|
|
|
|
|
|||||||||
57
Геометрическая интерпретация: Ф(t) - площадь криволинейной трапе-
ции.
Теорема 3. (О радиусе доверительного интервала).
При большом числе наблюдений (n 100) 1) В случае =m
t |
|
|
|
|
|
, |
|
|
|
|
|
|
|
|
|||
n |
|
|||||||
|
|
|
|
|
|
|
|
|
(3.2) |
|
|
|
|
|
|
|
|
2) В случае |
=D |
|||||||
|
|
|
|
|
|
|
|
|
t |
|
|
2 |
|
D . |
|||
|
|
|
|
|
||||
|
n |
1 |
||||||
|
|
|
|
|
||||
(3.3) |
|
|
|
|
|
|
|
|
Где через t |
обозначено решение уравнения Ф(t)= . Например, t0,8 = |
|||||||
1,28; t0,85 = 1,44; t0,9 = 1,65; t0,95 = 1,96.
Поскольку, как правило,  и D
 неизвестны, то вместо них в формулах (1.8), (1.9) используются их оценки * и D* , что не гарантирует доверие, но
правдоподобно.
Следствие 1 из теоремы 3. Расчет количества наблюдений, обеспечивающих заданную точность и заданную надежность:
n = (t / )2.
Следствие 2. Для улучшения точности в k раз необходимо увеличить количество наблюдений в k2 раз.
Аппроксимация результатов моделирования
Во многих системах имеет место функциональная связь между двумя или более переменными, и желательно эту связь выявить. Для определения этой связи используется регрессионный анализ, который дает возможность построения уравнения исходя из выборки.
Математическая модель представляется в виде полинома, в который разлагается анализируемая статистическая характеристика системы y = f(x1, x2, ..., xk) по входным параметрам xi (j=1,k):
|
k |
|
|
|
|
|
k |
|
|
k |
|
|
|
|
|
|
|||
y b0 |
bj x j |
|
|
blj xl x j |
bjj x2j |
|
|
|
|
|
|
||||||||
j 1 |
|
|
|
|
l , j |
1 |
|
j 1 |
|
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
где bj |
|
f |
|
|
|
|
, |
blj |
|
2 f |
|
|
|
, |
bjj |
2 f |
|
|
|
|
x j |
|
x 0 |
xl |
x j |
|
x 0 |
2 |
|
x 0 |
|||||||||
|
|
|
|
|
|
|
|
x j |
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
58
Предположим, что проведена серия из N независимых наблюдений, давших N систем значений yi, x1i, x2i, ..., xki (i=1,N) и по этим данным требу-
ется оценить неизвестные коэффициенты b0, bj, blj, т.е. найти их оценки ˆ , |
||||||||
|
|
|
|
|
|
|
|
b0 |
ˆ |
ˆ . Уравнение регрессии, полученной на основании эксперимента, запи- |
|||||||
b j |
blj |
|
|
|
|
|
|
|
шется в следующем виде: |
|
|
|
|||||
|
yˆ ˆ |
k |
ˆ |
k |
ˆ |
k |
ˆ |
2 |
|
|
|
|
|||||
|
|
|
bj x j |
|
blj xl x j |
|
|
|
|
b0 |
j |
|
j 1 |
bjj x j |
|||
|
|
1 |
l , j 1 |
|
|
|||
Задача оценки параметров может быть решена применением методов максимального правдоподобия или наименьших квадратов, причем в последнем случае оценки коэффициентов находятся из условия
N yi yˆ i |
2 |
min . |
i 1 |
|
|
Необходимым условием минимума Ф является выполнение равенств
Ф |
|
Ф |
|
|
|
|
|
|
0, |
0, ( j 0, k; l 1, k ) . |
|||||||
|
|
|||||||
bj |
blj |
|||||||
|
|
|
|
|
|
|||
Разность между объемом выборки N и числом связей, наложенных на эту выборку p, называется числом степеней свободы выборки f
f=N-p.
При определении уравнения регрессии число связей p равно числу определяемых коэффициентов, а вид уравнения регрессии выбирается путем экспериментального подбора.
После того, как уравнение регрессии найдено, прежде чем принять какое либо решение по поводу модели, необходимо проверить гипотезу о том, что полученная модель удовлетворительно описывает экспериментальные данные. Для этого необходимо проверить значимость всех коэффициентов регрессии и адекватность модели.
При проверке значимости коэффициентов регрессии для каждого ко-
эффициента bj выдвигают гипотезу H0:(bj=0). Известно, что оценка ˆ |
имеет |
|||||||||
|
|
|
|
|
|
|
|
|
b j |
|
нормальное распределение со средним, равным истинной величине bj |
и дис- |
|||||||||
|
|
2 |
|
|
|
bj |
|
|
|
|
персией D bj |
|
y |
, а величина z |
|
|
|
|
имеет стан- |
||
N |
2 |
|
|
|
|
|
||||
|
N |
|
2 |
|||||||
|
x ji |
x j |
|
y |
x ji x j |
|
|
|
||
|
i 1 |
|
|
|
i 1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
дартное гаусовское распределение. Величину z можно использовать для про-
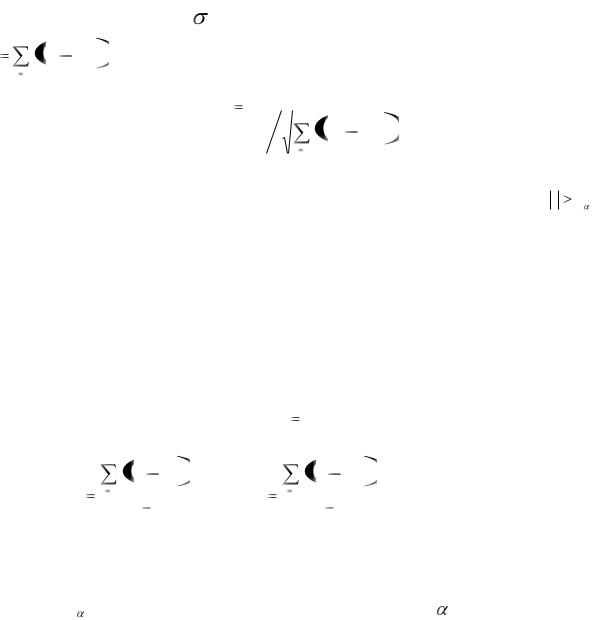
59
верки гипотезы H0. Если |
2y неизвестна, |
то используя вместо нее оценку |
||||||
S2y N yi yi |
2 , получим |
|
|
|
|
|
|
|
i 1 |
|
|
|
|
|
|
|
|
|
|
t |
|
bi |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
S y |
N |
x ji x j |
2 |
|
|
|
|
|
|
|
|
||||
|
|
|
|
i 1 |
|
|
|
|
Величина t распределена как стьюдентовская величина с N-2 степенями свободы. Поэтому, если для заданного уровня значимости  получено t t ,
гипотеза H0 должна быть отвергнута, т.е. коэффициент bj значимо отличается от нуля.
В модели множественной регрессии незначимые коэффициенты исключаются из уравнения. Оставшиеся коэффициенты пересчитываются, поскольку в общем случае они коррелированны друг с другом.
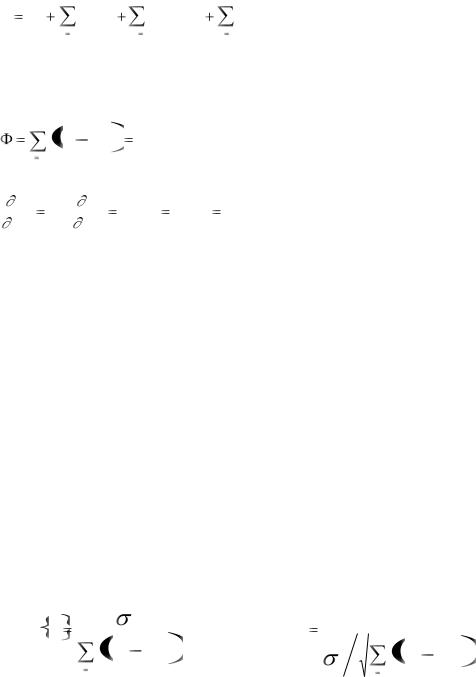
Проверка адекватности полученной модели производится по критерию Фишера:
|
|
|
|
|
|
F |
|
S2– р |
|
, |
|
|
|
|
|
|
|
|
|
|
S”2– |
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
||
|
2 |
N yi |
y 2 |
2 |
|
|
N yˆ i |
yi |
2 |
|
|||
где |
i 1 |
, |
|
i 1 |
|
. |
|||||||
Sср |
Sост |
|
|
||||||||||
|
|
|
|
|
|
|
|
|
|||||
|
|
N |
1 |
|
|
|
|
|
N |
p |
|
|
|
Критерий Фишера показывает, во сколько раз уменьшится рассеяние относительно полученного уравнения регрессии по сравнению с рассеянием относительно генерального среднего. Чем больше значение F превышает табличное F (f1,f2) для выбранного уровня значимости и чисел степеней свободы f1=(N-1) и f2=N-p, тем эффективнее уравнение регрессии.
КОНТРОЛЬНЫЕ ВОПРОСЫ
1.Раскройте суть понятий «модель», «моделирование», «теория моделирования».
2.Что такое адекватность модели, каким образом производится ее
оценка?
3.Сформулируйте принципы системного подхода в моделировании систем, чем отличается индуктивный подход от системного?
4.Опишите основные характеристики моделей систем.