Материал: Руководство по выполнению контрольной работы по эконометрике (110
проверка 121 таблетки полученной партии лекарств показала, что средний вес таблетки партии x 0,53 мг. Требуется на уровне значимости 0,01 проверить гипотезу H 0 : m 0,50 при конкурирующей гипотезе:
а) H1 : m 0,50 ; б) H1 : m 0,50 .
23. В социологическом обследовании приводятся выборочные данные о времени X (мин), проведенном 100 посетителями за столиком в одном из кафе: выборочное среднее x 58,3, исправленное стандартное отклонение s 3,6. Требуется на уровне значимости 0,05 проверить гипотезу H 0 : m 60 при
конкурирующей гипотезе H1 : m 60 .
24. Проектный контролируемый вес пакета растворимого кофе, расфасованного станком-автоматом m 35 г. Измерения 20 случайно отобранных пакетов дали следующие результаты:
|
Вес xi |
34,8 |
34,9 |
35,0 |
35,1 |
35,3 |
|
|
|
|
|
|
|
|
|
|
Частота ni |
2 |
3 |
4 |
6 |
5 |
|
|
|
|
|
|
|
|
|
Требуется на уровне значимости 0,05 проверить нулевую гипотезу |
|||||||
H 0 : m 35 при конкурирующей H1 : m 35 . |
|
|
|
|
|||
25. Точность работы станка-автомата, заполняющего пакеты со стиральным порошком, определяется совпадением веса пакетов. Дисперсия веса не должна превышать 25. По выборке из 20 пакетов определена исправленная дисперсия
s 2 30. Определить на уровне значимости 0,05 требуется ли переналадка станка?
26. Точность работы станка-автомата проверяется по дисперсии контролируемого размера изделий, которая не должна превышать 2 0,1. Взята проба из случайно отобранных изделий и получены следующие результаты измерений:
Размер xi |
3,0 |
3,5 |
3,8 |
4,4 |
4,5 |
|
|
|
|
|
|
Частота ni |
2 |
6 |
9 |
7 |
1 |
Требуется на уровне значимости 0,05 проверить, обеспечивает ли станок требуемую точность.
27. Партия изделий принимается, если дисперсия контролируемого веса изделия значимо не превышает 0,2. Исправленная выборочная дисперсия, найденная по выборке объема n 31, оказалась равной s 2 0,3. Можно ли принять партию изделий при уровне значимости 0,01?
28. По выборке объема n 30 найден средний вес пакетов x 139 г, расфасованных станком-автоматом №1. По выборке объема l 40 найден средний вес пакетов y 125 г, расфасованных станком-автоматом №2. Генеральные дисперсии известны: D( X ) 60, D(Y ) 80. Предполагается, что случайные величины
X , Y распределены нормально и выборки независимы. При уровне значимости
0,05 проверить, значимо ли различается вес пакетов, расфасованных различными автоматами?
29. В университете проведен анализ успеваемости среди студентов и студенток за последние 25 лет. Случайные величины X , Y , представляющие их суммарный балл за время учебы соответственно, имеют нормальный закон распределения. Получены следующие данные: x 400, y 420, sx2 300, sy2 150.
Можно ли на уровне значимости 0,05 утверждать, что девушки в среднем учатся лучше ребят?
30.В условиях задачи 29 определить, есть ли основание считать, что разброс оценок студентов больше, чем у студенток?
31.Из двух партий изделий, изготовленных на двух одинаково настроенных станках, извлечены малые выборки, объемы которых n 10, l 12. Получены
следующие результаты:
Размер изделий 1 станка xi |
3,4 |
|
3,5 |
|
3,7 |
|
3,9 |
||
|
|
|
|
|
|
|
|
|
|
|
Частота ni |
2 |
|
3 |
|
4 |
|
1 |
|
|
|
|
|
|
|
|
|||
|
Размер изделий 2 станка yi |
3,2 |
|
3,4 |
3,6 |
|
|||
|
|
|
|
|
|
|
|||
|
Частота li |
2 |
|
2 |
8 |
|
|||
При уровне значимости 0,01 проверить допущение о равенстве генеральных дисперсий и при положительном ответе проверить предположение о равенстве средних размеров изделий.
32. Расход X бензина автомобилей некоторой фирмы имеет нормальный закон распределения mx 7,5 л и x 0,5 л. Выпустив новую модификацию автомоби-
ля, фирма утверждает, что у него средний расход m y снижен до 7 л при том же значении стандартного отклонения. Выборки из 15 автомобилей каждой модели дали следующие средние расходы: x 7,45; y 7,15. Можно ли по этим данным доверять рекламе фирмы?
33. Для сравнения точности двух станков-автоматов взяты две пробы (выборки), объемы которых n 10, l 8. В результате измерения контролируемого размера отобранных изделий получены следующие результаты:
xi : 1,08; 1,10; 1,12; 1,14; 1,15; 1,25; 1,36; 1,38; 1,40; 1,42; yi : 1,11; 1,12; 1,18; 1,22; 1,33; 1,35; 1,36; 1,38.
Можно ли считать, что станки обладают одинаковой точностью на уровне значимости 0,1.
34. По двум независимым выборкам, объемы которых n1 9 и n2 6, найдены выборочные дисперсии D( X ) 14,4 и D(Y ) 20,5 годовых дивидендов от вложе-
ний в отрасли А и В соответственно. При уровне значимости 0,05 проверить гипотезу о равенстве рисков при вложении денег в обе отрасли.
36. Предполагается, что месячная зарплата сотрудников фирмы составляет 1000 $ при стандартном отклонении 100 $. Выборка из 36 человек дала следующие результаты: x 900 $, s 150 $. Можно ли по результатам приведенных наблюдений при уровне значимости 0,01 утверждать, что средняя зарплата сотрудников фирмы меньше рекламируемой, а разброс в зарплатах больше?
37. Анализируется зависимость между доходами X горожан, имеющих индивидуальные домовладения, и рыночной стоимостью Y их домов. По случайной выборке из 120 горожан данной категории получены следующие результаты:
xi 25200; yi 110500; (xi x)2 72300;
( yi y)2 1500200; (xi x)(yi y) 201350.
При уровне значимости 0,01 проверить предположение о равенстве дисперсий рассматриваемых случайных величин и гипотезу о наличии сильной линейной зависимости между исследуемыми показателями.
38. Объем продаж Y (тыс. руб) и расходы на рекламу X (тыс. руб) по 62 предприятиям концерна характеризуется выборочным коэффициентом корреляции rxy 0,3. При уровне значимости 0,05 проверить значимость коэффициента
корреляции.
39. Определяется наличие линейной зависимости между уровнями инфляции X и безработицы Y в некоторой стране за 11 лет. По статистическим данным рассчитан выборочный коэффициент корреляции rxy - 0,34. При уровне значимо-
сти 0,01 установить, существует ли значимая линейная связь между указанными показателями в данной стране на рассматриваемом временном интервале?
40. Сменная добыча угля на одного рабочего Y (т) и мощность угольного пласта X (м), характеризующие процесс добычи угля на 10 шахтах, представлены в таблице:
|
xi |
8 |
11 |
|
12 |
9 |
8 |
8 |
9 |
9 |
8 |
12 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
yi |
5 |
10 |
|
10 |
7 |
5 |
6 |
6 |
5 |
6 |
8 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Вычислить коэффициент корреляции между переменными X и Y и оце- |
|||||||||||||
нить при 0,01 его значимость. |
|
|
|
|
|
|
|
|
|
||||
2. Парный регрессионный анализ
Парная регрессия – это уравнение связи двух переменных y (объясняемая или зави-
симая) и x (объясняющая или независимая), в котором учитывается воздействие случайной составляющей
y f (x, ) . |
(1) |
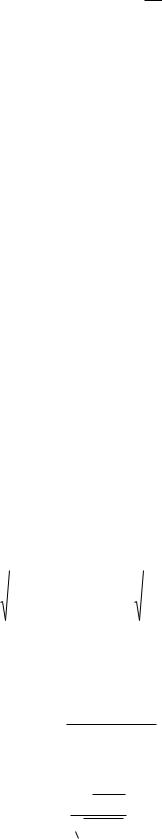
По имеющейся двумерной выборке ( yi , xi ), i 1, n требуется получить оценку (при-
ближенное выражение, аппроксимацию) уравнения (1) в виде |
||
~ |
|
~ |
y |
f (x) , |
|
которую называют выборочной регрессией в отличие от модельной регрессии (1). При аппроксимации используют либо линейную зависимость
~ |
b0 |
b1 x , |
(2) |
y |
либо различные нелинейные:
- степенную |
~ |
b0 x |
b1 |
; |
y |
|
~ |
|
x |
; |
|
|
|
- показательную y |
b0b1 |
|
|
|||
~ |
b1 |
/ x ; |
|
|
|
|
- гиперболу y b0 |
|
|
|
|||
|
~ |
e |
b0 |
b1x |
и т.д. |
|
- экспоненциальную y |
|
|
||||
Для определения параметров b0 , b1 ,... часто используют метод наименьших квадратов (МНК), когда они находятся из условия минимума функции
n |
~ |
|
|
|
|
n |
|
Q(b0 , b1 ,...) ( yi |
) |
2 |
|
|
2 |
, |
|
yi |
|
ei |
|||||
i 1 |
|
|
|
|
|
i 1 ~ |
|
представляющей собой сумму квадратов остатков ei |
yi |
yi . |
|||||
Для линейной модели (2) и нелинейных моделей, приводимых к линейн ым и содержащих два параметра b0 , b1 , верны следующие формулы (МНК-оценки):
|
|
|
|
|
|
||
b |
|
xy |
xy |
, |
b y b x . |
||
|
|
|
|
||||
1 |
|
x2 |
x 2 |
|
0 |
1 |
|
|
|
|
|
|
|||
Тесноту связи y и x для линейной регрессии оценивает линейный коэффициент пар-
ной корреляции |
rxy |
( |
r |
1) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
xy |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
r b x |
|
|
|
xy |
|
|
|
||||
|
|
|
|
|
|
xy |
, |
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
xy |
1 y |
|
|
x2 |
x 2 |
|
|
||||
а для нелинейной регрессии – индекс корреляции R (0 R 1) |
||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
~ |
) |
2 |
|
|
|
|
2 |
|
||
|
|
|
|
|
( yi yi |
|
|
|
|
|
|
ei |
||||
|
|
|
|
R |
1 |
( yi y)2 |
1 |
n y2 . |
||||||||
Если требуется установить тесноту связи между порядковыми переменными, то их ранжируют и присваивают им ранг. Затем оценивают тесноту ранговой корреляции с помощью коэффициента ранговой корреляции Спирмена
|
n |
|
1 |
6 (li |
mi )2 |
i 1 |
, |
|
|
|
n3 n
где li , mi ранги i го объекта по переменным X и Y . Для проверки значимости используют статистику
t 
 n 2 ,

 1 2
которая имеет распределение Стьюдента с (n 2) степенями свободы.
Оценку качества построенной линейной модели дает коэффициент детерминации R2 rxy2 , а для нелинейной модели – индекс детерминации R2 , равный квадрату индекса
корреляции R .
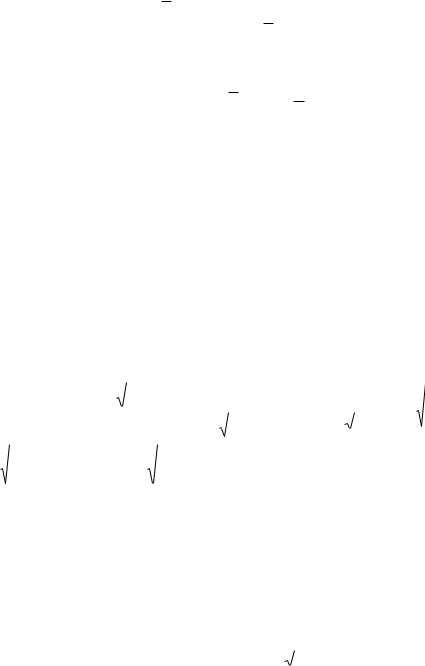
Средняя относительная ошибка аппроксимации определяется по формуле
|
|
|
|
|
~ |
|
||
|
|
|
|
n |
|
|
||
|
1 |
|
|
yi |
yi |
100% . |
||
|
A |
|
||||||
|
n |
|
yi |
|||||
|
|
|
i 1 |
|
|
|||
Допустимый предел значений A для точных моделей - не более 8-10%.
Средний коэффициент эластичности Э показывает, на сколько процентов в среднем изменится результат y от своей средней величины при увеличении фактора x на 1% от сво-
его среднего значения
Э f (x) xy .
Оценивание качества уравнения регрессии в целом производится с помощью F теста. Гипотеза H 0 о статистической незначимости уравнения регрессии проверяется с помощью критерия
F |
|
R 2 |
|
n m |
, |
|
R 2 |
m 1 |
|||
1 |
|
|
|||
где R2 - коэффициент или индекс детерминации, m - число оцениваемых параметров уравнения регрессии. Если Fнаб > Fкр , то уравнение регрессии статистически значимо. Значение
Fкр находится из таблиц критических точек распределения Фишера по заданному уровню
значимости и числу степеней свободы k1 m 1 и k2 n m .
Для оценки статистической значимости параметров регрессии и коэффициента корреляции рассчитываются t тесты и доверительные интервалы для данных показателей. Вначале определяются стандартные ошибки параметров линейной регрессии:
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
m |
|
s |
|
|
xi2 |
|
, m |
|
|
|
|
s |
|
|
|
|
|
|
|
s |
|
|
|
, |
m |
|
|
|
1 rxy2 |
, |
|
|
|
|
|||||||||||
|
|
|
b |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
r |
|
|
|
|
|
|
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||||
|
|
|
|
|
|
|
n x |
|
b |
|
|
|
|
|
(xi |
x)2 |
|
|
x |
|
n |
|
|
|
n 2 |
|
|
|
|
|
|
|||||||||||||||||
|
|
|
|
0 |
|
|
|
|
|
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
1 |
|
|
~ |
|
2 |
|
|
|
|
1 |
|
|
|
|
2 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
где s |
|
( yi |
yi |
) |
|
|
|
|
|
|
|
ei . |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||
n 2 |
|
|
|
n 2 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
Далее вычисляются |
t статистики: |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
b |
|
|
|
, i |
|
|
|
|
|
|
|
rxy |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
tb |
|
|
i |
|
1,2, |
|
tr |
|
|
|
, |
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
mb |
|
|
mr |
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
i |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
i |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
которые сравнивают с критическими точками |
tкр |
|
распределения Стьюдента, находимыми по |
|||||||||||||||||||||||||||||||||||||||||||||
|
|
|
|
tкр , то со- |
||||||||||||||||||||||||||||||||||||||||||||
заданному уровню значимости и числу степеней свободы k n 2 . Если |
tнаб |
|
||||||||||||||||||||||||||||||||||||||||||||||
ответствующий параметр |
признается |
статистически |
|
значимым. |
Существует |
связь между |
||||||||||||||||||||||||||||||||||||||||||
F критерием Фишера и t статистикой Стьюдента: |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
tr |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
tb |
|
|
F . |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Для статистически значимых параметров регрессии строят доверительные интервалы, |
||||||||||||||||||||||||||||||||||||||||||||||||
находя предельную ошибку для каждого показателя |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
b |
|
tкр mb , |
b |
tкр mb |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
0 |
|
|
1 |
|
|
|
|
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
и сами интервалы |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
(b0 |
|
b |
;b0 |
b ) , (b1 |
b |
|
; b1 |
b |
) . |
|
|
|
|
|
|
|
|
|
||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
1 |
|
|
1 |
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
~ |
|
|
|
зависимой переменной определяется путем подстановки в |
||||||||||||||||||||||||||||||||||
Прогнозное значение y p |
|
|||||||||||||||||||||||||||||||||||||||||||||||
уравнение регрессии соответствующего прогнозного значения x p . |
|
|
|
|
|
|
|
|
||||||||||||||||||||||||||||||||||||||||
Для построения доверительного интервала прогноза |
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
~ |
|
t |
|
|
|
|
~ |
|
t |
|
m~ ) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
( y |
p |
|
кр |
m~ ; y |
p |
кр |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
yp |
|
|
|
|
|
|
yp |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||
вычисляется средняя стандартная ошибка прогноза